lao1 me
AI
服务器
日常
推广
公告
搜索
主题
回帖
收藏
【开源】Inkrypt - 基于 Cloudflare 的端到端加密笔记软件,零成本,多设备同步,Passwordless体验,全面的Markdown支持
热
想了想还是把次世代给删了() 步子一点点迈
VrianCao
10小时前
AI
19
gep
AI
【开源】Inkrypt - 基于 Cloudflare 的端到端加密笔记软件,零成本,多设备同步,Passwordless体验,全面的Markdown支持
热
思来想去最终选用的类Material Design 3 光是UI就打磨了一周
VrianCao
10小时前
AI
19
gep
AI
【开源】Inkrypt - 基于 Cloudflare 的端到端加密笔记软件,零成本,多设备同步,Passwordless体验,全面的Markdown支持
热
@here 图来了!我对UI还是比较自信的,打磨了有个一周的时间 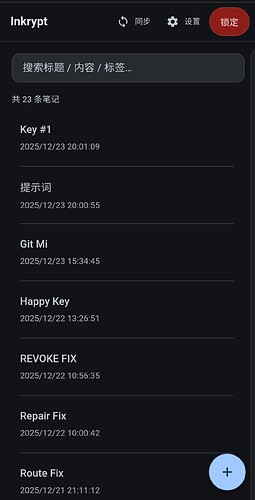 
VrianCao
10小时前
AI
19
gep
AI
【开源】Inkrypt - 基于 Cloudflare 的端到端加密笔记软件,零成本,多设备同步,Passwordless体验,全面的Markdown支持
热
因为是端到端加密+WebAuthn的,没法给预览站 回头会补一些截图
VrianCao
10小时前
AI
19
gep
AI
【开源】Inkrypt - 基于 Cloudflare 的端到端加密笔记软件,零成本,多设备同步,Passwordless体验,全面的Markdown支持
热
就是比较高级的意思(x 主要是现在市面上没有一个类似的全免费的E2EE笔记软件,这也算是开辟了新赛道了(?
VrianCao
10小时前
AI
19
gep
AI
Kimi K3.1 Pro:智能前沿,更进一步
热
依旧先官方一步 ^-^ > 介绍 Kimi K3.1 Pro:我们最强大的 3T 级开源权重模型。 > ^-^ 100 万 token 上下文,2.8T 总参数 / 1040 亿活跃参数(MoE),多模态。 > ^-^ 全项目编码:Unreal、Unity 和 Godot 中的游戏。 > ^-^ 在 Blender 和 CAD 中…
Kimi_Moonshot
3天前
AI
19
mi_tu
AI
kimi k3.1向我们证明了:DeepSeek的强大并不只靠蒸馏
热
目前看来Kimi K3.1对WebGL和网页3D的掌控程度至少是Opus 5.5水平的,但是接到Blender的效果暂时不清楚
涅利娅
3天前
AI
19
Gordonhilly1
AI
kimi k3.1向我们证明了:DeepSeek的强大并不只靠蒸馏
热
根据Arena上的检查点测试,K3.1的3D设计水平**远超**GPT-6.1 Sol,甚至超过Astra 作为一个3T参数量的模型,鹈鹕画成这样我认为反而说明了没有进行特训,因为参数量摆在这里,要想特训一下那都可以画出全球最好的鹈鹕了
涅利娅
3天前
AI
19
Gordonhilly1
AI
大肥鱼给我整个d盘干掉了
热
AI大战PowerShell意满离
keshi2006
4天前
AI
19
andyxiong
AI
使用机场的佬注意了,机场可以用泄露的 CA 私钥盗取你的 API KEY
热
并非,主流浏览器有小时级的CRL检测,可以做到全球同步的吊销 但是各大后端和请求库是自主维护的CA,其既不是系统证书也不是CRL,这也是为什么Go在今天发布了紧急的版本更新 包括但不限curl、Python、Rust、Docker、VPN都是不检查CT Log和CRL的,其在手动修复和更新前均受到这个泄露的影响 这件事的影响程度远远超过了这次的PHP,其短时影响性没有那么大,但是长期的恶劣影响极大
Bob
5天前
AI
14
cangying33
AI
让人瞳孔地震的史诗级草台班子使得全球设备持续高危整整16个月:eMudhra泄露的八张CA证书的全部密钥均为8bits及以下,其中一张证书的私钥为“4”,现代设备可以在1ms内全部破解,且事发后eMudhra还在嘴硬
看一次笑一次 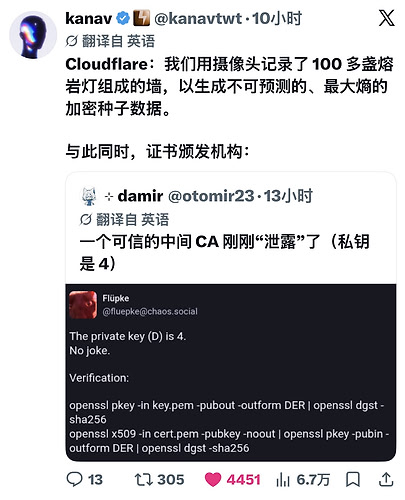
VrianCao
6天前
AI
4
社会八级大哥哥
AI
历史性时刻:Mercury 3 发布,能力超越 Haiku 5.5 与 6 Luna 的同时保持 1000+ TPS,同等级下的扩散模型首次超越了自回归模型
热
补充图片: 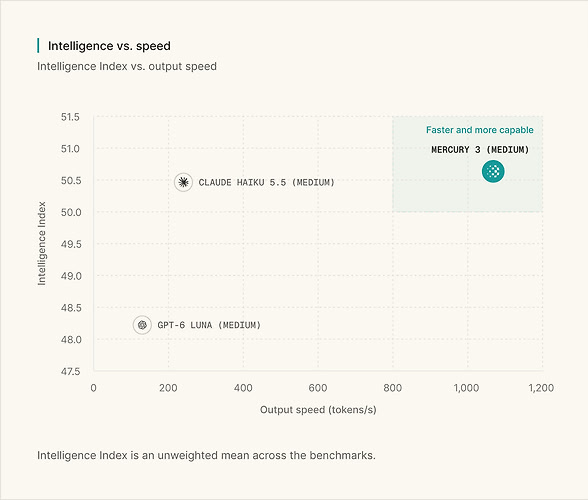
VrianCao
2026-10-20
AI
17
DFobainx
AI
历史性时刻:Mercury 3 发布,能力超越 Haiku 5.5 与 6 Luna 的同时保持 1000+ TPS,同等级下的扩散模型首次超越了自回归模型
热
聊天Demo:https://chat.inceptionlabs.ai/ API:https://platform.inceptionlabs.ai/
VrianCao
2026-10-20
AI
17
DFobainx
AI
令人感慨,两年过去只剩一家模型会说人话了
热
Gemini的世界知识是所有模型都望尘莫及的存在,能稍微接近它的也许只有Fable甚至Mythos,Astra都还差点意思 而且一旦涉及到一些知识问答,你会感觉Gemini是真的懂这些知识,而非给你非常非常长的长篇大论,只是把语料“复述一遍”
羽织
2026-10-18
AI
19
pitttttt
AI
Gemini 4 Argon 的鹈鹕测试太令人失望
热
实践是检验真理的唯一标准,但凡自己试试看就知道不是楼主说的这样的。
UEFI
2026-10-14
AI
19
yuefeng_yang
AI
Gemini 4 Argon 的鹈鹕测试太令人失望
热
能否说一下是在哪个平台或者用的什么API呢? 我目前没有看到任何一个Gemini 4 Argon的鹈鹏测试是长这样的,我自己测试下来也从未出现过这么差的,始终都是表现很好的 > 我不要你觉得,我要我觉得,我觉得你不友善 > 鹈鹕也无法代表您的 “科学求证的精神” 那就举证回答平台或者API?
UEFI
2026-10-14
AI
19
yuefeng_yang
AI
对于普通人而言,办美卡的意义是什么?
热
你现在能开出什么卡了?据我的(极)(非常)(完全)不可靠观测,用美卡充Claude的风控要比礼品卡、虚拟卡、Wise这些低得多得多,纯自己用基本不封 *仅个人观点,不构成买号卖号意见和教程
evan
2026-10-14
AI
11
12dora
AI
对于普通人而言,办美卡的意义是什么?
热
此美卡非彼美卡,佬友远行外出历练一阵便可进阶至楼主的第二境界()
evan
2026-10-14
AI
11
12dora
AI
重磅分析:目前来看Opus 5.5 似乎 *大幅* 提升了帕累托前沿,实现了智价比的飞跃
孩子们 OpenAI 变成价格屠夫了,这下真是不好说了
VrianCao
2026-09-23
AI
8
VrianCao
AI
重磅分析:目前来看Opus 5.5 似乎 *大幅* 提升了帕累托前沿,实现了智价比的飞跃
依旧是74%,那我的猜想应该是正确的,DeepSWE的缺陷导致了这就是无限接近的理论最高分了,因此Anthropic不选择宣传 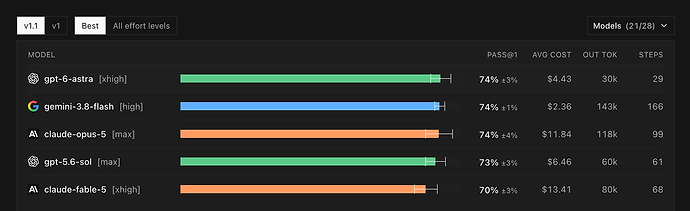
VrianCao
2026-09-23
AI
8
VrianCao
AI
重磅分析:目前来看Opus 5.5 似乎 *大幅* 提升了帕累托前沿,实现了智价比的飞跃
关于DeepSWE分数: 我倾向于是因为当前的DeepSWE V1.1已实际饱和,其理论最高分即~80%,而且这玩意实在是太好刷了,Anthropic没理由不公布 更详细的信息可参考: > [image] > Epoch AI在前几天完成了对多个Benchmark的审计,证明了DeepSWE V1.1是存在缺陷的,当前已实际饱和,前沿模型已实际追进了可获得的最高分 > 参考:
VrianCao
2026-09-23
AI
8
VrianCao
AI
震惊瘫坐!Opus 5.5的AAII比Fable 5.1以及Astra高出了整整5分!!!巨幅提升!!!
热
讨好人类也是一种人类偏好的体现,这也是当前Llama 4获得高分的原因 大可以不看Text榜单,只看WebDev这些,还是有参考意义的 就近期来看,Arena应该是没什么刷榜行为的,但是AAII的公信度在前段时间遭受到了严重的质疑,随后官方连续更新,换了新的Benchmark和加权算法,升级到了V4.3.2
VrianCao
2026-09-23
AI
19
VrianCao
AI
震惊瘫坐!Opus 5.5的AAII比Fable 5.1以及Astra高出了整整5分!!!巨幅提升!!!
热
AA是Benchmark融合分数,并含有自己的私有测试集,在新的 v4.3.2 下恢复了一定的公信力,但仍存在饱和和刷分的情况 Arena则是纯人类投票,其代表了广泛人类的偏好,出了AutoEval那个垃圾东西之外,其余数据是大多可信的
VrianCao
2026-09-23
AI
19
VrianCao
AI
震惊瘫坐!Opus 5.5的AAII比Fable 5.1以及Astra高出了整整5分!!!巨幅提升!!!
热
Artificial Analysis  artificialanalysis.ai 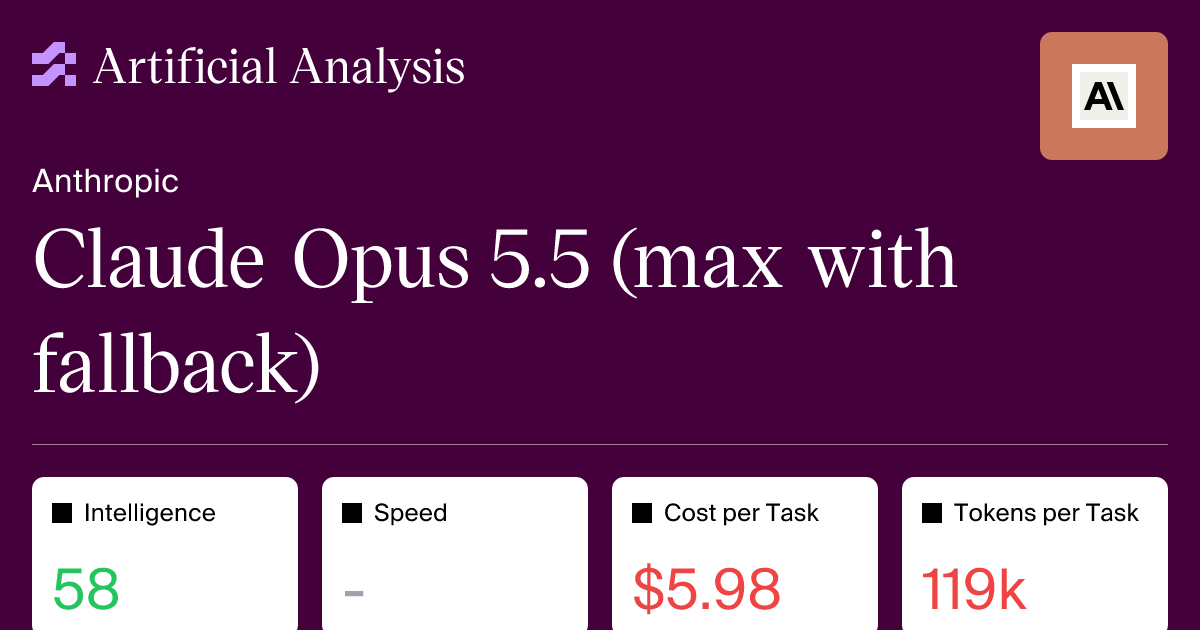 Claude Opus 5
VrianCao
2026-09-23
AI
19
VrianCao
AI
震惊瘫坐!Opus 5.5的AAII比Fable 5.1以及Astra高出了整整5分!!!巨幅提升!!!
热
目前看来针对Agentic Coding,Med和High都是不错的甜点 Ref三个Benchmark: 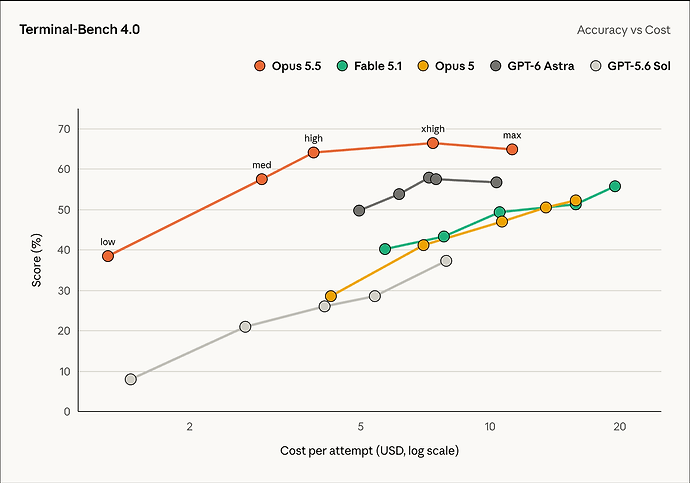   artificialanalysis.ai Intelligence Evaluati
VrianCao
2026-09-23
AI
19
VrianCao
AI
Grok疑似在内测新模型OR新功能?
破案了,Grok 4.7在一个小时前发布了 大概率是下午在进行部分内测
VrianCao
2026-09-22
AI
2
VrianCao
AI
前端优化建议
要论审美的话Gemini不虚的 秒杀Sol那是轻轻松松,GPT到了Astra才开始逐渐有审美
WT.HSBG
2026-09-10
AI
7
MangoDIO
AI
1
2
下一页
提示
×