lao1 me
AI
服务器
日常
推广
公告
搜索
主题
回帖
收藏
ChatGPT 20X 会员被突然暂停了
看说好像开了自动续订的是可以的
heing
2026-09-11
AI
8
light2199
AI
不知道 GPT Pro 20x 啥时候能重新开订阅
热
> 5x的2倍,pro的20倍,没问题啊, 而且你没发现你自己这说的都矛盾吗
wayned
2026-09-11
AI
16
还想成为88VIP
AI
不知道 GPT Pro 20x 啥时候能重新开订阅
热
> 然后 Claude 20x 又弄小字营销,实际没有 20x 所以你都没看清我说的内容吗? 我不就是在说 GPT 的 20x 就是 20x,Claude 的 20x 是风味 20x ^-^
wayned
2026-09-11
AI
16
还想成为88VIP
AI
不知道 GPT Pro 20x 啥时候能重新开订阅
热
我真不想继续争辩了 5x2=20 吗?
wayned
2026-09-11
AI
16
还想成为88VIP
AI
不知道 GPT Pro 20x 啥时候能重新开订阅
热
> 在网上看到了很多说法,有的说只是5h 是5x的4倍,我一个5x一个月就出了这么多 > [image] 当然,不仅是站内,前一两周 x 上也很多博主讨论这个问题 ^-^
wayned
2026-09-11
AI
16
还想成为88VIP
AI
不知道 GPT Pro 20x 啥时候能重新开订阅
热
不知道啊,一开始说要暂停订阅我还是不太相信的
wayned
2026-09-11
AI
16
还想成为88VIP
AI
不知道 GPT Pro 20x 啥时候能重新开订阅
热
没有,A\ 玩小字营销,只有 5h 是 20x,周限没有
wayned
2026-09-11
AI
16
还想成为88VIP
AI
不知道 GPT Pro 20x 啥时候能重新开订阅
热
那我就两个 5x 了,这样不如一个 20x 性价比高,而且 Claude 的 Fable 还只能用一般额度,Opus5 难用我又不想用,这样基本一半额度是浪费了
wayned
2026-09-11
AI
16
还想成为88VIP
AI
[离大谱]DS V4.1 Flash在livebench居然追平5.6Sol
热
有可能是主观刷分,还有可能就是训练的时候评判标准就是用的这些 benchmark 类似的方式,导致模型偏向刷分
V_Arrow
2026-09-11
AI
10
Dumbledore
AI
[离大谱]DS V4.1 Flash在livebench居然追平5.6Sol
热
看到更上面的 Muse Spark 1.3 xHigh Effort,我释怀了 ^-^
V_Arrow
2026-09-11
AI
10
Dumbledore
AI
DeepSeek想一出是一出啊 推迟下线了
热
只能说之前那个直接路由有点逆天,不像一个正经商业公司的举措 我倒是挺希望 DeepSeek 不要变成一个正经商业公司,还是专注探索基模比较好 但是最近的两轮融资和着急上市,不好说是不是要变质成一个正经商业公司 ^-^
Ningbainb
2026-09-10
AI
19
Eric
AI
DeepSeek 变了吗?
热
感觉相对于之前好像变得确实更看重跑分了,但是界面那些问题感觉就是强行找问题了 毕竟还没出会员制和广告呢 ^-^
william0819
2026-09-10
AI
13
海獭为什么叫海獭
AI
[Nao 榜] v4.1 flash,你在哪里……?往上走走啊
热
Gemini 3.7 Flash 和 GLM 5.3 Flash 的位置和我的体感有点差距,我感觉 V41F 可能比这两个好一点,当然也可能是场景差异 Gemini 我感觉主要是短小的任务能力尚可,稍微长一点的任务就容易偏离了 GLM 5.3 Flash 则是通过雷霆大思考,时间换的效果,不过鉴于价格便宜,倒是一个比较甜品的模型 其他的感觉差距不太大
calendar
2026-09-10
AI
19
越rrdvdfvd
AI
GPT6 Astra 像一个想太多的实习生
热
> superpowers 会不会是这个的问题,可以去掉试试,我反正用过这个没多久就不用了
Kinema
2026-09-10
AI
19
imBoyka
AI
现在国产大模型谁最强?Kimi-K3还是智普
热
应该是 K3 总体最强吧,但是纯执行我觉得 GLM5.3 更好一点,K3 感觉规划更好一点 对了,就如上面所说,K3 很慢,GLM 最近还好,挺快的,也没遇见重连了
Snail
2026-09-10
AI
11
Guilliman
AI
我要给Gemini说对不起。
热
让 agy 里的 3.8Flash 写了一个需求,一开始其他几个模型 review 实现质量还可以,然后定了一版 review 结论,交给 3.8Flash 去改,结果修复又引入了好几个新问题,然后我就把这次改动撤销了 ^-^ 可能 Gemini 在一次性的工作上效果还不错吧,多轮会话的任务用起来可能一般
riverxorange
2026-09-10
AI
17
1_9_7_3
AI
Claude强制署名越来越严重了
热
我的解决方法是不让 Claude 提交了,换个别的模型提交,提交前让别的模型 review 一下 不过现在主力用 Astra,Opus5 有点难用,也没怎么用了,不过我也不会让 Astra 提交
CN_CoreSteb
2026-09-10
AI
10
厄喑透
AI
Claude强制署名越来越严重了
热
不看楼主说的吗?
CN_CoreSteb
2026-09-10
AI
10
厄喑透
AI
Claude Pro 即将重置周额度
你这个标题。。 ^-^
牧之
2026-09-10
AI
8
wayned
AI
Codex 疑似进行了不完整重置
热
恢复了 不是,哥们,为啥不是直接重置啊
BlueFunny
2026-09-10
AI
15
wayned
AI
神了额度怎么突然重置了
热
周限从 60 多变成 40 多了
changsheng_chen
2026-09-10
AI
19
changsheng_chen
AI
分享重度使用半年以上国产模型的感受
热
zcode 只有客户端,没有 cli,kimi code 只有 cli,两个刚好不是一个路子,看你习惯了
gorgias
2026-09-10
AI
19
HarmonyOS
AI
不要使用mimo x pro
截图这个是 mimo 的那个客户端吗?
鸹貔
2026-09-09
AI
4
wayned
AI
这个image2.5的品质绝了
热
云的效果感觉有点差,有点像棉花。。
Underthemoon
2026-09-09
AI
11
时牧
AI
有预感 deepseek 风评迎来转折点
热
> 此外,lwf 当时对世界模型的毫不关心也引起了我的担忧,这种想法可能是错的,Astra 探索出了 3D 和 PCB 等等与现实生产更为紧密的场景(这些依靠的都是多模态能力),可能在预示下一个增长点; 确实有可能变质(但不会倒闭),但是你这前后就不是一个东西啊 ^-^ 还是你想说多模态?
EFL
2026-09-09
AI
19
白学森
AI
GPT Pro 5X的额度相当于Claude pro的额度
热
另外,Claude 订阅在缓存窗口内和窗口外使用占比对额度影响差距很大,需要有良好的利用缓存的使用习惯,我对比了下感觉很明显,GPT 的没有这么明显的感觉,可能是 OpenAI 没有怎么优化缓存(也可能是故意不优化 ^-^
DrNoir
2026-09-09
AI
18
时牧
AI
GPT Pro 5X的额度相当于Claude pro的额度
热
Opus5 挺拉的,而且不说人话,用得难受得一批 Astra 目前用得很爽,又快又好,说人话,不说废话,希望后面别降智(不过感觉不太可能 当然 Astra 发布前几周的 5.6 Sol 也是真拉,到后面我都不想用了
DrNoir
2026-09-09
AI
18
时牧
AI
OpenAI 发布了ChatGPT Images 2.5
热
现在还没有其他生图模型能追上 Image-2 吧
雪豹形哈基米
2026-09-09
AI
19
rsharecn
AI
DeepSeek V4.1 Flash 纪念碑谷 游戏测试
那就是你表述有问题,测试一般就是指单元测试、集成测试啥的 你应该说让他不要通过迭代验证或者反馈优化的方式改进,比如: 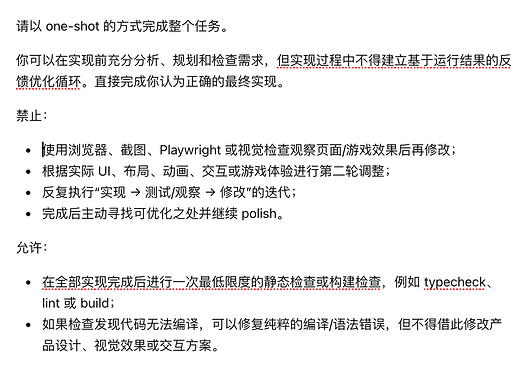 但是这样意义不太大
Coffee
2026-09-09
AI
5
mark
AI
DeepSeek V4.1 Flash 纪念碑谷 游戏测试
看图片我感觉 50 分都不到 不过你说的的那个测试就像它回复的那样,不算测试,应该是验证,它不可能一下写成没问题的,需要迭代验证优化效果
Coffee
2026-09-09
AI
5
mark
AI
上一页
1
2
3
4
5
6
下一页
提示
×