lao1 me
AI
服务器
日常
推广
公告
搜索
主题
回帖
收藏
billion-context 真的有用吗?
直观看来大概率没什么用,billion context 自己那篇预印本里的评测做的都很水
dataflow
3天前
AI
7
b1ElUd@mf2Kv5
AI
Kimi的公关宣传稿被曝光了
热
看这个稿子不太像真的,Kimi 的外宣会这么涉政吗^-^,而且他只有五千粉丝,这个曝光也是孤证
starlord9527
3天前
AI
16
starlord9527
AI
kimi k3.1 的 AA 跑分
热
那些 benchmark 应该没有一个是测 arena 这种前端能力的,包括 coding,因为审美在竞技场很重要,但这种东西很难程序化评价
PPTkgky
4天前
AI
13
lxb123
AI
Kimi K3.1 Pro 现已正式发布:与世界顶尖的专有模型不分伯仲
热
因为 swe bench 基本都被刷爆了,比如 deepswe ,Claude 之类的也不测这个了 frontier code ,Cursorbench 这些好像都是闭源的,估计第一时间捞出来的就是图里这几个
VrianCao
4天前
AI
14
moying
AI
k3.1-pro-highspeed 吐字355token/s,一次鹈鹕测试消耗699-20%额度
699 才 25 刀也太变态了 ^-^
永不言败zlcggb
4天前
AI
4
佩恩
AI
commandcode的ds4.1降智无疑(FAST也答不上糖果题,总之不是降智就是量化)
热
想起我的 cline pass 里的 deepseek 连 dsh 的工具都调不明白, 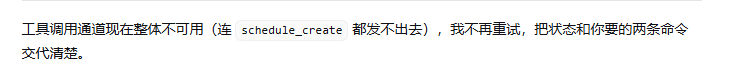
社畜OvO
4天前
AI
12
還sんì吥懂
AI
Google疑似再次在反重力进行灰测
热
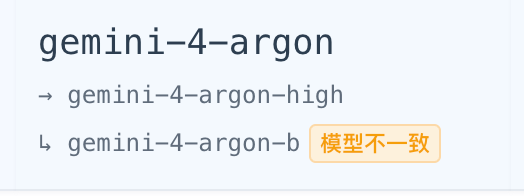 我这怎么还有 argon-b 呢
一只猪
4天前
AI
19
alexanderfs
AI
奉劝买macmini 理由是为了自己部署模型的人早点放弃
热
> Qwen3.8-Flash-Next ,Qwen3.8-27B-BF16 这两模型不应该鹈鹕都画不好吧?是不是部署出了问题
YAOHUO
4天前
AI
10
YAOHUO
AI
今天pro账号爽爆了好吧
热
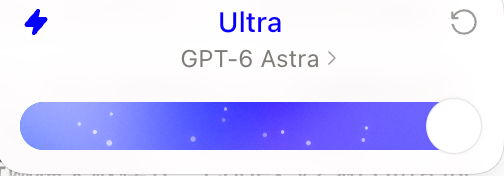 享受一下吧,提前这么久给重置准信相当于一天时间免费蹬了,这种机会真的不多 不对怎么五分钟没了 5%^-^
shiner
4天前
AI
19
DEA
AI
DSH会成为下一个OpenClaw吗?
热
关键是大肥鱼,而不是 DSH 感觉 DSH 在技术社区没被玩出什么新范式,看大家用它的方法和用 pi 的方法都没啥区别 ^-^
Faye2611
4天前
AI
17
Faye2611
AI
感觉这个 LayerFS 有点东西
热
这个和 Anthropic 之前提的那个替代 git 的产品有什么区别,都是为 Agent 并行开发的版本管理设计的
ZRainbow
6天前
AI
15
ZRainbow
AI
买了 gpt 和 grok,但我还是想用 DeepSeek
热
grok 本身就不太行,ds 的问题也是对比 sol 和 opus 这种一线模型的,argon,grok感觉都是这股味儿
光头不砍树
6天前
AI
13
小飞侠
AI
买了 gpt 和 grok,但我还是想用 DeepSeek
热
也就是 TPS 快了,工具调用力大飞砖,动不动扫全盘 timeout600,然后反复读文件,实际还不如 30tps 的 sol 快,更别说和最近提速后的 sol 还有 opus 对比了
光头不砍树
6天前
AI
13
小飞侠
AI
deepseek 4.1 flash 这消耗token的速度太离谱了
热
任何 agent 都是这样,除非要压缩了
Cielos
6天前
AI
17
Cielos
AI
小米 MiMo-V2.6-Pro 上线 WorkBuddy
热
刚刚出的时候试过,上一个版本的 DeepSeek 的思考效率,但是只有四五十的 TPS,大概就是这种感觉吧,调一次工具能思考个几分钟
Astralyn
2026-10-20
AI
14
mitch
AI
历史性时刻:Mercury 3 发布,能力超越 Haiku 5.5 与 6 Luna 的同时保持 1000+ TPS,同等级下的扩散模型首次超越了自回归模型
热
> - 在输入价格基础上再享 9 折优惠。 等等,缓存怎么是输入的九折?
VrianCao
2026-10-20
AI
17
DFobainx
AI
历史性时刻:Mercury 3 发布,能力超越 Haiku 5.5 与 6 Luna 的同时保持 1000+ TPS,同等级下的扩散模型首次超越了自回归模型
热
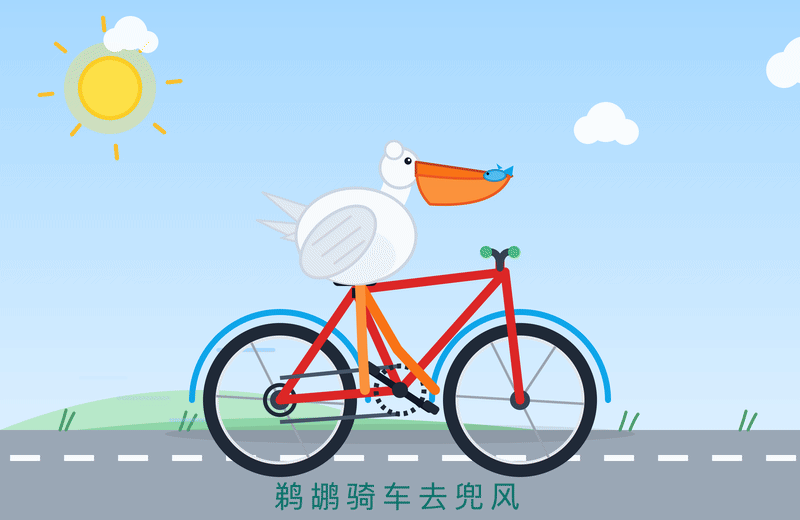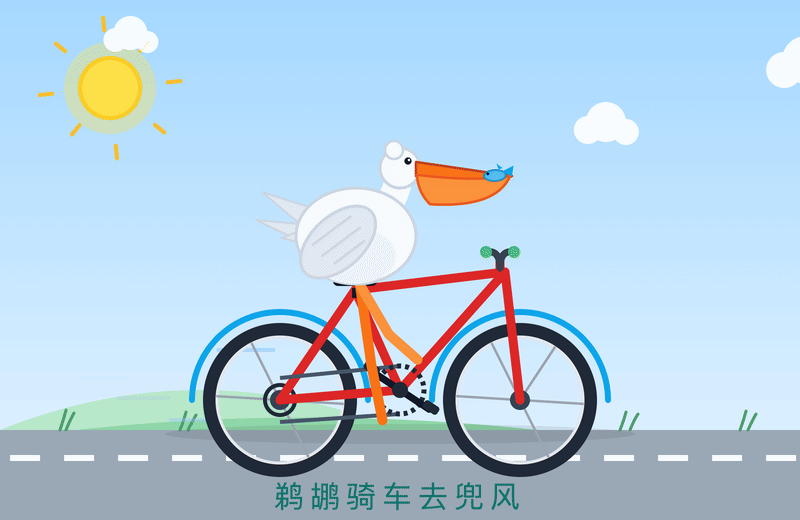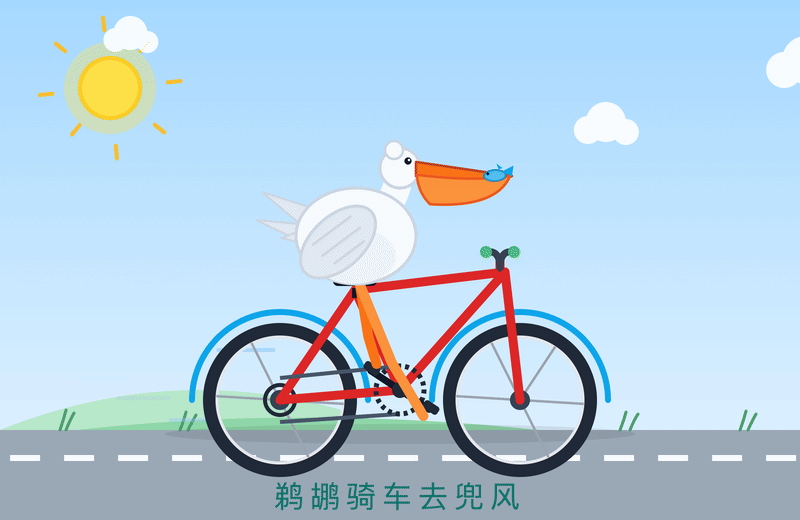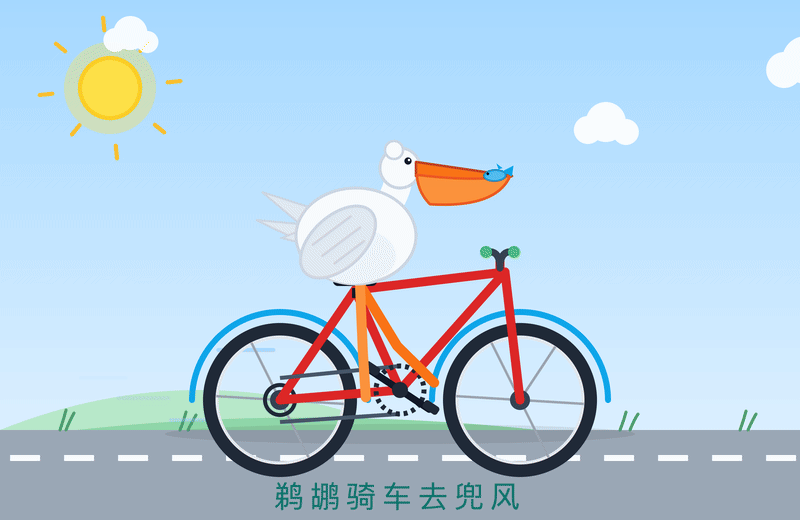 扩散模型能做成这样其实已经很强了
VrianCao
2026-10-20
AI
17
DFobainx
AI
DeepSeek-v4.1-flash-1017的在CC的缓存命中率大幅提升!
40 轮次以上的任务低于 98 基本可以认定要么上游出了问题(deepseek 官 api 基本不会丢缓存),要么 harness 里有前缀丢失 佬可以让 ai 排查下 trace
Mrt123
2026-10-19
AI
9
Mrt123
AI
国产大区Minimax3.1f猫老板榜单出炉!
热
猫榜不是私人榜单吗?那他怎么拿到题目的 难道是直接从输入的数据里定位到题目的吗 想起了手机圈特调机的事 ^-^,靠 ip 地址来决定要不要调参数
栏杆拍遍
2026-10-19
AI
19
runner_dhero
AI
MiniMax M3.1 Flash 怎么热度不高啊,opencode都免费提供了!
热
模型强才有震惊瘫坐的帖子,deepseek 发新模都没几个测试 还记得 Astra 发布的那个晚上,震惊瘫坐四个字都不认识了
吴亦Fan?
2026-10-19
AI
19
gangpula32
AI
用Workbuddy的时候对比了一下,感觉Deepseek V4.1flash-1017还是比不上Gemini 3.8 Flash啊
热
这些不都有官方的 GUI 版本(除了 pi)吗?你都能反代 aistudio,让 AI 帮你下个 magpie 来代理 workbuddy 就可以在这些 harness 里面用 deepseek 了
GoTop
2026-10-19
AI
19
superdadhobo
AI
用Workbuddy的时候对比了一下,感觉Deepseek V4.1flash-1017还是比不上Gemini 3.8 Flash啊
热
因为 workbuddy 非常难用,llm 要先和它的沙箱搏斗一番才能真正做事 如果你是 windows 环境,那更可怕了,拿个 powershell 的输出模型都得力竭 不如反代出来接个正经的 agent 用
GoTop
2026-10-19
AI
19
superdadhobo
AI
都说Deepseekv4flash1017蒸了Astra,那我更好奇6luna是怎么诞生的了
热
deepseek 的算力相较于用户体量就多了吗?那大涨价干嘛。 我估计你也没有两边的负载-算力的具体数据吧,那如何得出的 luna 远小于 deepseek 的结论?
白包
2026-10-18
AI
19
lucas-linuxdo
AI
都说Deepseekv4flash1017蒸了Astra,那我更好奇6luna是怎么诞生的了
热
如何做到小得多且用着领先好几代的算力的同时 api 价格更贵,ttft 更慢,tps 更慢的?
白包
2026-10-18
AI
19
lucas-linuxdo
AI
你们有觉得DSH有点过于拖泥带水了吗
热
没必要,不如冲一个 claude pro,额度太少,模型也不够强
jamesenha
2026-10-14
AI
19
jamesenha
AI
Argon的额度不容乐观
热
感觉根本没法干活啊^-^,这钱开两个 Claude pro 耐用好几倍
Kassdin
2026-10-14
AI
17
一只猪
AI
猜一下Tibo的新Good plans
热
丢掉五小时限额就是给自己找不痛快,大家都工作时间猛猛蹬给服务器上压力 最后就必须靠降速降智和限流来削峰
Seb666
2026-10-14
AI
11
被强煎的蛋
AI
Argon的额度不容乐观
热
不过chat的额度至少是和cli分开的,待我打通cpa后体验一下cli的额度
Kassdin
2026-10-14
AI
17
一只猪
AI
如何停止许愿式编程
热
找不到不许愿的理由,ai 写出来也没啥问题^-^,感觉自己都没有什么发挥空间
ch7x
2026-10-05
AI
12
recronin
AI
【补档】国产模型已经到了最惊险的转折点【Opus 5.5 主观体验报告】
热
个人感觉不存在这一点,从这一年看过来 gpt5.4 时代,难道国模就不危险了吗?当时随手一薅就是 bug team,成本远远比 Claude 的会员便宜,约等于免费。公益站里 gpt 最强模型随便用,而国模唯一能打的还是 glm5.1 还限购
wakusei
2026-10-02
AI
19
bfloat16
AI
1
2
3
4
下一页
提示
×

