lao1 me
AI
服务器
日常
推广
公告
搜索
主题
回帖
收藏
GPT5.6 Sol已经没法用了。
深有同感,现在的能力能不能打过glm5.3flash都是个问题,常用技术栈做的UI都改不明白 ^-^,Astra你快来吧
qzzz-linuxdo
2026-09-05
AI
7
kwiskr
AI
GLM 5.3-flash和qwen3.8-flash 哪个写代码适合。
热
刚刚在qoder里面用3.8flash要排队四分钟 ^-^,订阅用户一样排队的只见过这一家
伪装
2026-09-04
AI
19
cat
AI
GLM 5.3-flash和qwen3.8-flash 哪个写代码适合。
热
QWEN 3.8 FLASH很舒适,可以用,但是自己部署的比较爽,官方的几个渠道都不太行,贵和卡都沾一点
伪装
2026-09-04
AI
19
cat
AI
所以...Astra 发布是为了什么?
热
5.6Sol 不也是这样。先是安全评估又是通过商务部审核又是先给企业开放 现在 A\反而学乖了,A\倒是不提前炒作直接发 fable5.1
OpenAI_Q-Star
2026-09-04
AI
16
SamAltman1
AI
Astra的效率太可怕了,跟那些拉皮超频雷霆大思考的货色就不是一个时代的
热
没必要贷款赢,实际体验和跑分还是有区别的。 即使这图这里看起来 sol max token 效率也不低,真写代码做实验就开始checksum,sha256 ,硬编码全给你上一遍。真实场景里面,sol high 照样雷霆大思考,也就 codex 把思考工具给你缝一起看不出来罢了 想想为什么 opus 明明跑分榜单里输出更多的 tokens,但是实际体验大家都觉得 gpt 慢,claude 快?
ikb
2026-09-04
AI
19
jcc
AI
财经在Opencode测出来实际上 ChatGPT的20x的token plan才是性价比最高,性价比碾压国内一众模型
热
这咋测的,k3 699 才 7 亿?周额度都不止吧?
Laplace9
2026-09-04
AI
19
weq
AI
Omen Alpha 鹈鹕测试(似乎有点猛啊)
 秦始皇骑北极熊,这个熊有点恐怖了 ^-^(什么大秦四足自走机器人)
Kassdin
2026-09-04
AI
6
Dc18
AI
Opencode Go 上线 GLM 新模型(匿名模型)
热
GLM 怎么产能这么高,牛来还没过多久又掏出来一个 ^-^
Clancy_Wang
2026-09-04
AI
19
apomnz
AI
纯水 dsh的缓存命中率好高
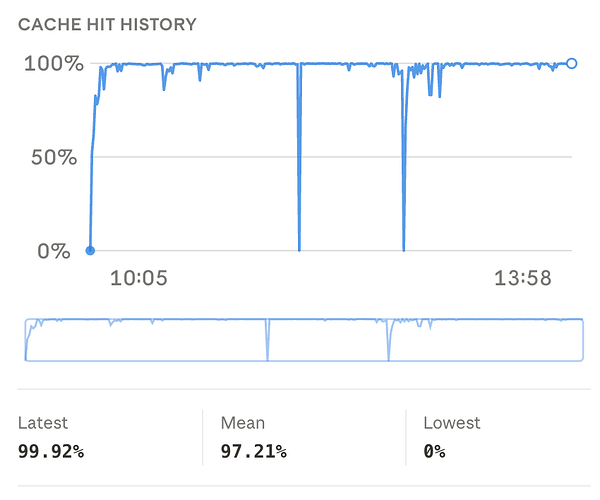 重点是上游不能抽风,本地客户端都差不多,顶多是工具调用轮次的区别。轮次越多总体缓存命中率就越高。另外上下文长度开的长,每次新写的 tokens 和写入缓存之比就低,每次缓存命中率就高,导
libreisme
2026-09-04
AI
5
hackclaw
AI
目前模型的智能下全局的CLAUDE.md、AGENTS.md 还很重要吗
热
反而是越来越重要,模型越聪明就越需要约束
baigy
2026-08-31
AI
16
吴亦Fan?
AI
听说 hy4 数学很强
热
deepseek上一次主动汇报数学能力还是在v3.2吧
sparklydream
2026-08-29
AI
10
ℬ𝒶𝒾𝒲𝒶𝓃
AI
暴论:DSV4-Flash比GLM-5.3-Flash便宜
热
这有很多需要讨论的,也和模型行为有关 - 比如我用100-200k的上下文完成一个小需求就切新对话,此时大概总token小号在5-6M,命中率可能90%左右,但是总token量少,所以计价便宜 - 假设已经使用100k上下文,A模型倾向于串行调用工具,5个工具连续调用,每次都会读取100k+工具结果的缓存token。B模型倾向于并行工具调用,5个工具同时执行只接受一次结果,总共就100k的缓存to
Midsummer
2026-08-27
AI
16
randname
AI
小说不知道写的咋样,根据gpt的建议,找了几部喜欢的作品生成大纲让他在不知道具体作品的情况下盲评大纲
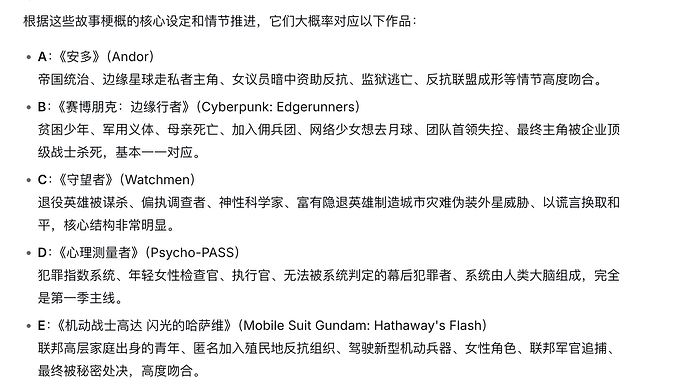 AI一眼就能看出来这些情节对应的作品,信息给的很足了。可以找一个有思维链的模型,看看思维链里是如何看待F的
拉_瑞
2026-08-24
AI
9
拉_瑞
AI
在fable用不了的情况下,论写文章,Opus5,Opus 4.6和Kimi K3哪个强?
热
最近用k3讨论方案,感觉k3是最顺眼的。5.6 Sol 太喜欢分点和赘述,opus5 的不符合中文习惯的词用的很多
ppp1234forwork
2026-08-23
AI
13
Amireux
AI
Qwen3.8 27B agent能力不行呀
热
应该是部署和权重出问题了,这种一般先让别的AI排查下部署的参数吧,大概率不是模型本身的问题
JJ-linuxdo
2026-08-23
AI
11
Jchenpku
AI
深夜打飞机大赛第二届
热
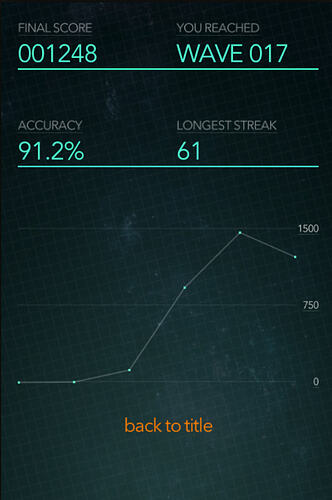 到了17已经完全按不过来了 ^-^
白夜
2026-08-23
AI
19
FloodSung
AI
GLM涨价25倍
热
涨价了就不支持了,转投codex ^-^
JamesCheng
2026-08-21
AI
13
miyami
AI
Sonnet日常开发够用不?对比国模呢?
热
Sonnet5就是区,跑分和glm5.2缠斗。并且雷霆大思考 Opus5大概率能做到花更少的额度消耗完成sonnet5的任务
Yiyabo!
2026-08-21
AI
14
ArthurW
AI
完整梳理: ds 路由 claude 模型的五个可复现论点
热
模型认知没啥意义吧,但是其他的都是很实锤的论点
Xixuer
2026-08-21
AI
19
impouo
AI
火山codingplan测评9.9/月
112k就用完了也太变态了,基本属于不可用状态
Pig-linuxdo
2026-08-20
AI
6
心雨
AI
deepseek灰测又来了?
热
^-^继续灰测,我倒要看看DeepSeek多久能拿出来灰测水平的模型,现在的旗舰还在这和27B小模型扭打呢
你是什么东东
2026-08-19
AI
19
David_Colin
AI
预购了影之刃零
^-^不跳票就好了,不跳票那简直近在眼前
weifengl
2026-08-19
AI
4
chenlongwen
AI
deepseek v4 pro正式版 和 GLM5.2 还有Qwen3.8 max哪个编码强
热
Qwen3.8 MAX 用上的人太少了,很难评价。但Qwen3.8 27B 挺好用的 ^-^
GC
2026-08-18
AI
19
Zachary_H
AI
Deepseek v4 Flash涨价后,没想到3.7 Flash意外不错
热
muse spark 1.2 这么拉吗,看AA上的跑分还以为挺厉害
Eeevan
2026-08-18
AI
19
Yi-linuxdo
AI
Qwen3.8-27B 跑分已出,agentic 得分超过 Deepseek-V4-Flash
这么强的吗?差点把Pro都干掉了
qilme
2026-08-18
AI
4
Lieben
AI
我看好多佬买了grok heavy年付,哪怕薅羊毛也得接近1000刀了,真舍得啊
不给grok爆米也得给gpt、claude爆米,一个月折下来600还是很值的。而且可以拼车降低成本
linganshi
2026-08-18
AI
9
二树
AI
国模真的和GPT体感差异很大
热
几个月前我用Trae用佬友写的byok用的GPT,上下文干一半都没开始动手。同样的prompt给codex分分钟干完了,Trae本身问题也蛮大的
zara
2026-08-17
AI
18
Shawn_Aaron
AI
国模真的和GPT体感差异很大
热
我的GPT怎么和你不一样,也是写一堆测试脚本,还喜欢跑模型前编造一堆我没说过的数值gate,一没通过就说“这条道路封死了”。拉的这些脚本还会污染后续接手的其他模型,让他们模仿写gate脚本恶心人
zara
2026-08-17
AI
18
Shawn_Aaron
AI
ChatGPT 5.6 Luna 迈入百万上下文普惠时代
openrouter直接用api就是,价格和以前api用v4pro差不多
北极之大
2026-08-17
AI
4
polaris
AI
大反转?!Deepseek v4 pro 练出焚决 (J-Space) 超越 Fable5 ??一看不怎么相信
热
全面暴打fable5,感觉不如信我是秦始皇 我说想要多少分自己填 ^-^
Nolan
2026-08-16
AI
19
Morli
AI
上一页
1
2
3
4
5
6
下一页
提示
×
