lao1 me
AI
服务器
日常
推广
公告
搜索
主题
回帖
收藏
【祛魅claude】体验opus5.5后端编码感受--和Astra平分秋色,客户端拉跨
热
我当然需要向社区(佬友、Twitter)求证了,因为从去年开始,我整个AI编程都没有碰过 claude ,大多数都是在用 GPT。所以我的求证渠道就只能是榜单和社区反馈。 我作为社区一员,给出的 opus5.5 和 Astra 的实际体感就是平分秋色。 至于 Astra 和 Fable 5.1 在 后端编码上谁更强。我只能求助社区的实际体感反馈。而不是纯纯的反驳。
大空
2026-10-14
AI
18
大空
AI
【祛魅claude】体验opus5.5后端编码感受--和Astra平分秋色,客户端拉跨
热
所以,我帖子的约束就是在后端编码上的体验,没有把前端纳入到体验范畴来。我日常确实参考artificialanalysis 多一些,但我刚刚又参考了其他的榜单。 **所有的榜单都说 opus 5.5 比 GPT Astra 强。甚至比opus 5.5 比 Fable 5.1 都强。所以,我拿 opus5.5 跟 Astra 我觉得是合理的。** 除非就像你说的,所有的榜单都不可信。不如大家实际的真实
大空
2026-10-14
AI
18
大空
AI
【祛魅claude】体验opus5.5后端编码感受--和Astra平分秋色,客户端拉跨
热
GPT降智和慢这两个问题我也无法忍受,而且你说GPT今天很蠢的情况我也发现了。 Codex 昨天下午开始降智了,昨天下午Astra high就开始堆屎,我现在在打扫"公共厕所”。 Gemini 真是不争气啊,但凡 Argon 争气点,OpenAI 还能有所忌惮…
大空
2026-10-14
AI
18
大空
AI
【祛魅claude】体验opus5.5后端编码感受--和Astra平分秋色,客户端拉跨
热
你怎么得出 Astra 和 Fable 是“同价格”的???我贴的图不可信是吗? 我看了一下artificialanalysis 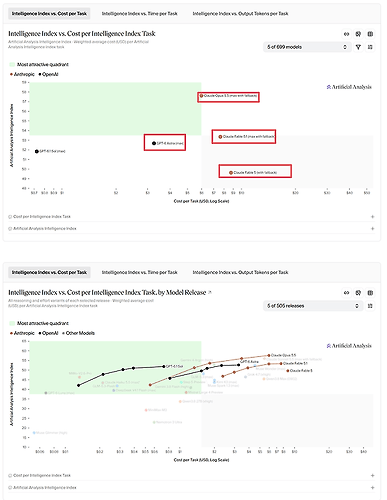
大空
2026-10-14
AI
18
大空
AI
【祛魅claude】体验opus5.5后端编码感受--和Astra平分秋色,客户端拉跨
热
请问是后端场景吗???前端的话我承认 claude 模型的品味和审美高于 GPT。 后端场景我看 Twitter 上的反馈,claude 有时候不如 GPT 严谨认真肯干活。 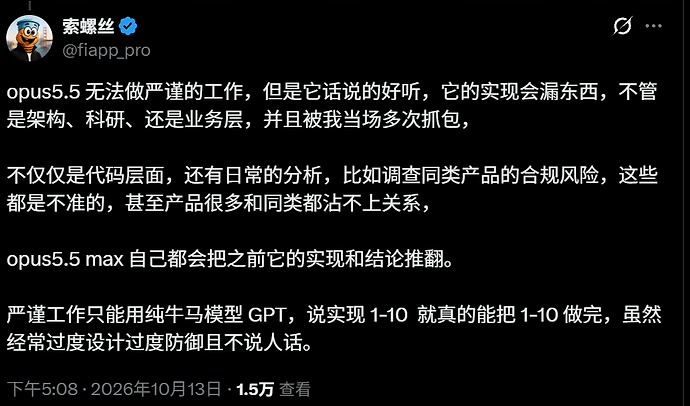
大空
2026-10-14
AI
18
大空
AI
【祛魅claude】体验opus5.5后端编码感受--和Astra平分秋色,客户端拉跨
热
> opus5.5 的对比对象是 6.1sol 这个比较又是怎么得出的?看一个模型是否好用,不应该是从性价比上去衡量吗? 价格我觉得还是一个重要的权衡项。 你前面还说要看价格,我贴出价格图你又说“不重要”了。
大空
2026-10-14
AI
18
大空
AI
【祛魅claude】体验opus5.5后端编码感受--和Astra平分秋色,客户端拉跨
热
确实是忘记用 Fable 了,主要是 Fable 之前的调性太高,我觉得我的任务都不配用 Fable. 而且,是我看错了吗?? 我看了一下artificialanalysis Fable 5.1 和 Fable 5 同任务的消耗要比 Astra 贵上不少。 
大空
2026-09-08
AI
7
大空
AI
写给想要从GPT Plus 升级到Pro 5x 的朋友们的真实体感
热
我其实一直想要尝试Grok,还是得找个机会上车亲测一下。
大空
2026-08-31
AI
19
wayned
AI
写给想要从GPT Plus 升级到Pro 5x 的朋友们的真实体感
热
所以看起来,ChatGPT App 把 Max 隐藏起来是有原因的
大空
2026-08-31
AI
19
wayned
AI
写给想要从GPT Plus 升级到Pro 5x 的朋友们的真实体感
热
不知道你说的差异是什么? 思考质量?**我目前的体感在思考质量上没有明确的差异**。但我 Pro 思考更慢了是我的感受。
大空
2026-08-31
AI
19
wayned
AI
写给想要从GPT Plus 升级到Pro 5x 的朋友们的真实体感
热
订阅限额和 Token 消耗量似乎不成正比,还取决于你选择思考强度,速度等等。而且 OpenAI 也没有给出一个衡量标准出来。 而且我从来不关心 Token 消耗了多少,只关注周限额够不够使用。也只关注对话结果产生了多少有用的代码或者结果,我觉得这才更有意义。
大空
2026-08-31
AI
19
wayned
AI
写给想要从GPT Plus 升级到Pro 5x 的朋友们的真实体感
热
我也纠结对比了,我发现没有比ChatGPT更好的可选项。 Cursor 我没调研明白; Claude 使用苛刻没考虑过; Kimi K3 到现在也订阅不上; Grok 4.6实操据说也很差; 其他的模型调研下来似乎更差。 实话说,在选择模型订阅上我比较保守: - Codex/ChatGPT App 的产品体验做得非常好; - 我个人不喜欢用 CLI 和 TUI; - 我会等某一个模型整体的舆论风评
大空
2026-08-31
AI
19
wayned
AI
提示
×