lao1 me
AI
服务器
日常
推广
公告
搜索
主题
回帖
收藏
半夜 CodeX 额度离奇失踪?
已收到官方补偿 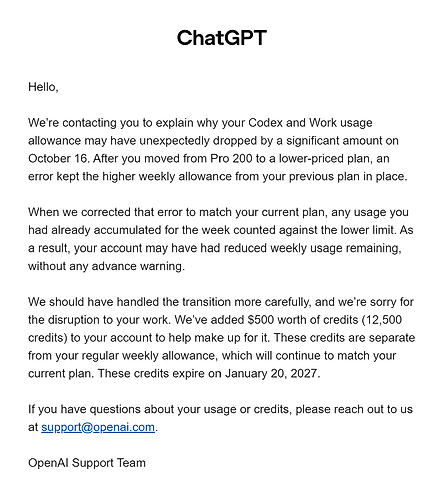
c.1
2026-10-21
AI
7
c.1
AI
半夜 CodeX 额度离奇失踪?
综合了更多消息,看来真的是草台班子 https://linux.do/t/topic/3008252
c.1
2026-10-17
AI
7
c.1
AI
下载了两个星期的数据,被 kimi 全删了
热
现阶段的办法应该就是在 AGENTS.md 定义清楚“清理”是什么意思
nclp
2026-09-28
AI
19
JinWw
AI
开源一个在 A100 80GB × 4~5 条件下部署原版 DeepSeek V4.1 Flash 的配方
打错了,已更正
c.1
2026-09-27
AI
7
loong
AI
开源一个在 A100 80GB × 4~5 条件下部署原版 DeepSeek V4.1 Flash 的配方
Engram 卸载到 RAM 以后,剩余的权重 + KV Cache 可以勉勉强强塞下
c.1
2026-09-27
AI
7
loong
AI
O/ 5x 和 20x 改名了
5x 的内部名称是叫 pro lite,看来要变成大杯、超大杯的思路了
bomsw
2026-09-27
AI
0
AI
O/ 5x 和 20x 改名了
热
5x 的内部名称是叫 pro lite,看来要变成大杯、超大杯的思路了
bomsw
2026-09-27
AI
19
萧瑟
AI
学生怎么办招商的【visa卡】
热
学校合作的银行有的可以线下办理用于留学的信用卡
qiang0129
2026-09-23
AI
17
c.1
AI
为什么这么快?《DeepSeek V4.1 技术报告》可视化、交互式 AI 解读
希望未来 DeepSeek 视觉能力起来以后,可以自己解析自己 现在 Astra 的额度消耗量太恐怖了
c.1
2026-09-18
AI
5
c.1
AI
小米 mimo-v2.6-pro和2.6flash
直播训练 LLM,至少大厂好像还没干过 --- 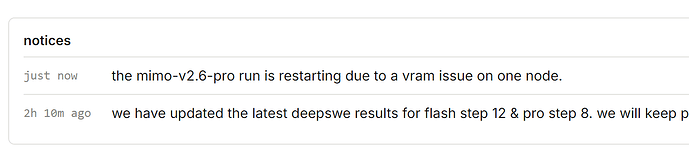 显存用爆了? ---  有可能会还给你
undefined
2026-09-10
AI
2
c.1
AI
deepseek预计将要降价
热
难道这是在用二分法探索让用户负载刚好匹配服务能力的价格嘛 ^-^
peop
2026-09-08
AI
19
soul0932
AI
佬友们大概隔多久/聊几轮开新对话?
热
如果只是交接文档的话,可以当成日志、按日期命名,这样旧的自然就不去多注意了。 如果更像 wiki 的话,那确实需要有一个机制定期维护一下。
Fyrestone
2026-09-08
AI
12
koksaver
AI
佬友们大概隔多久/聊几轮开新对话?
热
主观上感觉不一样的事情,就可以开一个新对话了。 个人建议更好的做法是在 AGENTS.md 规定一套让 AI 自己记录工作进展的机制。这样哪怕是做到一半的工作,开新对话也不会有负担。 毕竟压缩的本质就是把当前的工作情况给浓缩成一段文字。而你有一整套记录库的话,更不容易丢失信息,还可以人工检查记下来的有没有偏离正确方向。
Fyrestone
2026-09-08
AI
12
koksaver
AI
Astra 输出十六进制机器码,生成可玩的《打砖块》EXE
或许更准确的理解是:用 Python 写了汇编代码和工具,再用这个工具生成机器码
Blade
2026-09-08
AI
5
wangcccccct
AI
snowshot作者用rust+qt重构了,用起来还不错
热
在作者官网下载 Snow Shot | Work elegantly and efficiently, every time 怎么有杀毒软件报警了 VirusTotal
Domye
2026-09-07
AI
19
loshine
AI
(无人角)科大讯飞星火 X2.5 模型正式发布:293B-A30B MoE,全国产平台训练(转)
热
之前小模型的上下文是 1M,大模型反而变成 256k 了?
Silence
2026-09-07
AI
15
心尘
AI
GPT6随手做了个猫屋,效果居然如此惊艳!
热
慢慢看了一下,里面细节还挺多的。 顺便一提,用 WebP 动图就能在论坛的限制范围内上传了: 
小爬的老粉丝
2026-09-07
AI
19
cooljser
AI
基于 GPT Pro 的自学方式:以 DeepSeek DSpark 技术为例
做了第2版,看看如何 提示词: 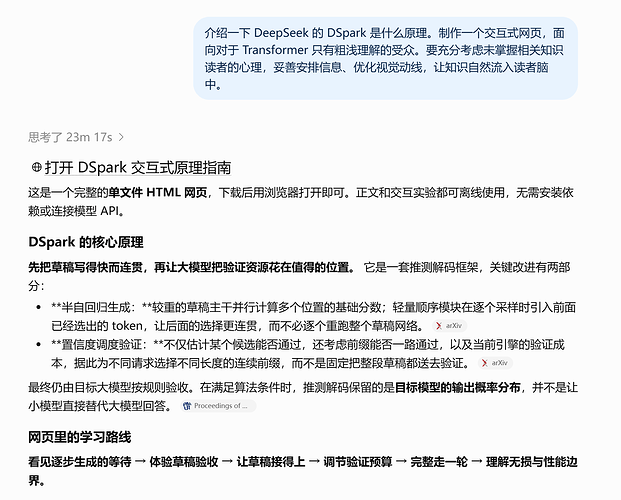 GPT 5.6 Pro (v2): share.concentrate1.com DSpark 原理交互课|让大模型少跑几趟 面向 Transformer
c.1
2026-09-06
AI
7
pan_iron
AI
基于 GPT Pro 的自学方式:以 DeepSeek DSpark 技术为例
我也有类似感觉,直到搞明白了正确的阅读顺序以后,才逐渐变得清晰。我再试试看能不能通过提示词优化一下。
c.1
2026-09-06
AI
7
pan_iron
AI
codex上下文拓展的问题与求助
热
方法没问题,这就是官方推荐的 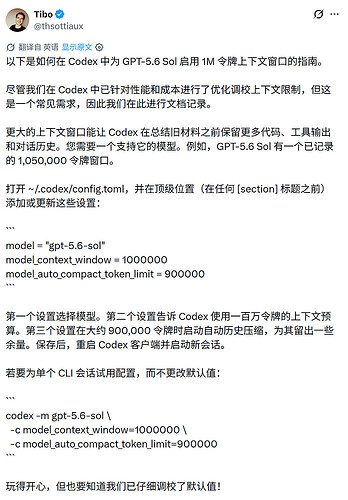 额度消耗要具体问题具体分析,比如一个任务如果在原来压缩上限稍多一点就能完成,那这样算下来可能还会省一点额度
wtk
2026-09-05
AI
10
bozzli
AI
GPT-6-AStra 降智测试
热
2026年以后都不太稳定,有时候连着问、分开问都会不一样,不同推理强度也有区别 > 首先是最简单的直接问: > [image] > [image] > 显然,这不像是靠谱的样子。 > 于是,我换了种问法: > [image] > 可以看出,到2025年6月就停了。 > 再把推理强度拉到极高试试看: > [image] > 截止时间变到了2025年底。 > 然后我再去问轻度思考,也继续问出来直到20
tseRay
2026-09-05
AI
15
edition_elder
AI
知识库截止日不准!
热
研究了一下,实际截止时间在今年年初到5月左右 > 首先是最简单的直接问: > [image] > [image] > 显然,这不像是靠谱的样子。 > 于是,我换了种问法: > [image] > 可以看出,到2025年6月就停了。 > 再把推理强度拉到极高试试看: > [image] > 截止时间变到了2025年底。 > 然后我再去问轻度思考,也继续问出来直到2025年底的新闻。 > 那么这就是极
GoogleDragon-linuxdo
2026-09-05
AI
10
HelsingenMosken
AI
OpenAI 官网上了两个关于 Astra 的博客,但还没正式发布?[更新: 文章没了]
难道是官方出现了什么紧急情况,导致其他定时发布的措手不及了 搞不好可能不仅仅是技术问题
timmm
2026-09-04
AI
3
DioBrando
AI
淦oai酿,等了一晚上等出个有限开放,睡觉!!!
热
thenewstack 虽然不是最有名的,但好歹也是正经的媒体
ZRainbow
2026-09-04
AI
14
Nebula1
AI
淦oai酿,等了一晚上等出个有限开放,睡觉!!!
热
现在报的这些都是正经的美国主流媒体
ZRainbow
2026-09-04
AI
14
Nebula1
AI
gpt 5.6 luna 子代理上免费运行 fable 5.1 这玩意有人在用没?效果咋样?
热
你可能被翻译坑了。实际的意思是,用近乎免费的 Luna 干活,让 Fable 作为指导,从而在节省费用的同时发挥旗舰模型的能力。 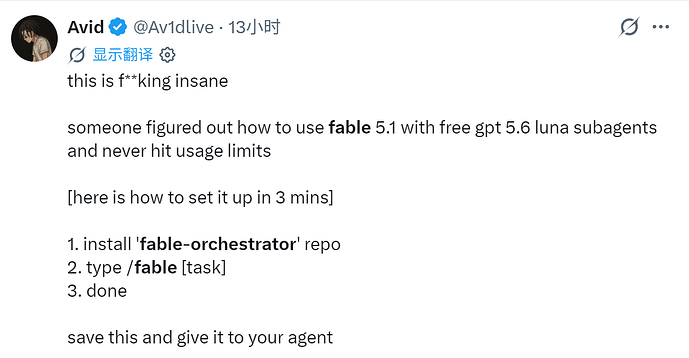
筑基佬
2026-09-03
AI
11
jimygo
AI
小模型品鉴:讯飞 Spark-X2.5
估计是因为讯飞没啥存在感,所以就算出事了很多人也不知道 不过这里讨论的是本地模型,除非往里面故意投毒,不然商业层面的事情也没啥影响吧
c.1
2026-09-02
AI
4
c.1
AI
大家win 版本的codex还能正常打开吗?昨晚更新一版打不开了
我研究了一下,可能是草台程序把全局配置里的 config.toml 写错了 解决方法是把这个文件备份、改名。这个时候应该就能启动了。 启动之后再让AI自己检查具体错在哪里(或者发到网页会话里也行)。
张张与陈陈
2026-09-02
AI
4
c.1
AI
提示
×