lao1 me
AI
服务器
日常
推广
公告
搜索
主题
回帖
收藏
qwen-flash 哪个级别好用
自己使用strata本地部署的UD_Q4_K_XL量化,挺好用的
NimbleComet92
5天前
AI
2
NimbleComet92
AI
qwen3.8 flash 本地部署飞起
热
你看下主板上有没有两个显卡插槽,如果没有的花,消费端大部分普通主板显卡应该不支持通道拆分的,估计搞不了
落寞书生
2026-09-18
AI
15
zengraoli2012
AI
qwen3.8 flash 本地部署飞起
热
测试下了200k上下文左右的时候,prefill还能达到1300,真是恐怖如斯. 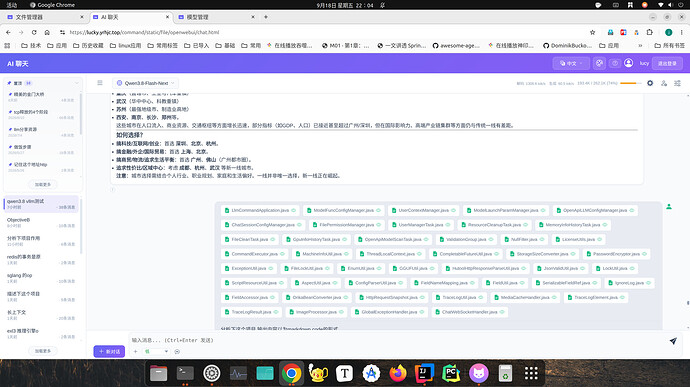
落寞书生
2026-09-18
AI
15
zengraoli2012
AI
qwen3.8 flash 本地部署飞起
热
ubuntu系统,windows系统下不稳定
落寞书生
2026-09-18
AI
15
zengraoli2012
AI
qwen3.8 flash 本地部署飞起
热
模型本身支持,他这个版本而不支持
落寞书生
2026-09-18
AI
15
zengraoli2012
AI
qwen3.8 flash 本地部署飞起
热
我是两个魔改3080跑qwen3.8 flash next,3张2080ti魔改跑qwen3.8 27 q 8
落寞书生
2026-09-18
AI
15
zengraoli2012
AI
qwen3.8 flash 本地部署飞起
热
足够了,我就是双卡3080 一共40gb,内存要大点
落寞书生
2026-09-18
AI
15
zengraoli2012
AI
qwen3.8 flash 本地部署飞起
热
我也是之前没想到vllm性能这么炸裂,gpu基本能够跑慢,他的官方文档是两张3090,能够跑到100t/s
落寞书生
2026-09-18
AI
15
zengraoli2012
AI
qwen3.8 flash 本地部署飞起
热
这个模型就有一个问题,不支持多模态呀
落寞书生
2026-09-18
AI
15
zengraoli2012
AI
贼code,我真是无语了,这种公司真是无耻
热
还是自己本地部署用着放心,不知道这些三方模型会不会偷偷上传自己系统文件
累趴的怪蜀黍
2026-09-18
AI
18
impeach7
AI
佬们现在用什么模型?
热
qwen3.8 27b qwen3.8 flash next
gooog_chang
2026-09-16
AI
12
HiuZzz
AI
佬友们java线程这块有学习教程或者项目吗
推荐这个博客,写的挺好https://www.cnblogs.com/skywang12345
xymopi
2026-09-14
AI
7
ted
AI
小米pro思考了10分钟画的鹈鹕
看效果还不如qwen3.8 flash,网页版效果 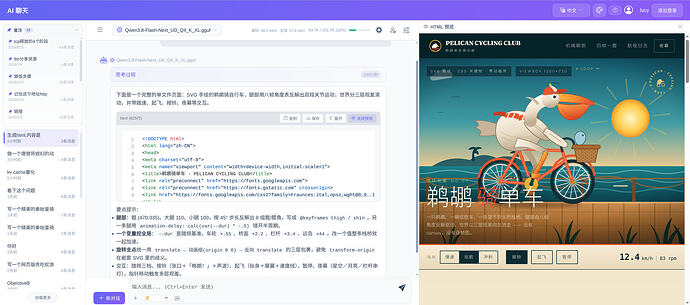
Eugene
2026-09-10
AI
1
落寞书生
AI
Qwen3.8-27B vllm Pro6000D部署问题,如何优化生成速度
这个速度太慢了,我用的llama.cpp部署的unsloth ud q8量化,3个魔改2080ti 开启mtp和sm tensor都能跑到45t/s,峰值60t/s左右,vllm理论并发应该更快
LLLLLL
2026-08-23
AI
2
落寞书生
AI
Qwen3.8-27b无审查版相比原版会降智吗
热
这个版本我也用过,相比原版编码能力还是有下降
hyi
2026-08-22
AI
14
hyi
AI
会不会有qwen 3.8的moe小模型
比较高性价比的用魔改卡跑,我用的是3张魔改2080ti
coupile
2026-08-22
AI
6
a179
AI
会不会有qwen 3.8的moe小模型
希望来个120b左右的moe,智商比27b高点就更好
coupile
2026-08-22
AI
6
a179
AI
花巨资测试:Qwen3.8-27B_RTX5090-32G_Ollama_上下文对比
编码能力很强,垃圾显卡也能跑,27b适合本地部署
jeffccie
2026-08-22
AI
4
落寞书生
AI
提示
×