- ZRainbow2026-07-31
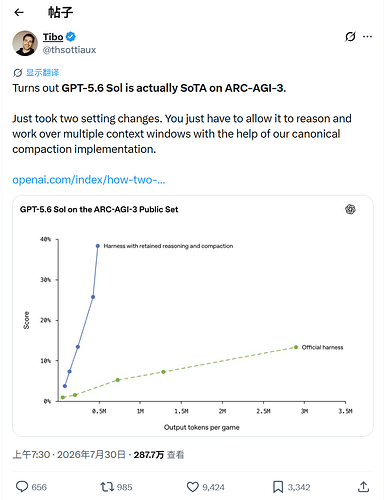
如图,Tibo的推特表示,开启两个选项能让GPT 5.6 Sol的能力大幅提升
我很好奇,点开了原文看,很短
How enabling two settings tripled our scores on the ARC-AGI-3 benchmark | OpenAI
感觉像API的推销,原文直接说:
如果你是想最大化性能的 API 开发者,我们建议使用我们在自家产品中部署的相同设置:
- 请使用我们的Responses API,而不是我们传统的Chat Completions API
- 保留推理
- 使用压缩
回到Tibo的推特,它明确指出:
work over multiple context windows
在充分理解后,这里应该指的是
同一条用户指令尚未完成时,Codex 可以在上下文快满后原地压缩、切换到下一个上下文窗口,然后继续执行工具和推理。
而不是真的开多个窗口
这时候再来看文章的这段话:
ARC-AGI-3 线束通过滚动截断解决上下文限制。当对话上下文超过175,000字符时,最早的消息会被丢弃。
滚动截断有两个缺点。首先,模型丢失了之前的观察和操作。其次,它在大部分任务中使用更完整的上下文窗口,这可能会稍微影响性能。
当我们在ARC-AGI-3上启用压缩功能时,GPT-5.6 Sol能够更好地保存其在较长时间运行中学到的每个游戏内容,并以更少的输出令牌获得更高分数。大概会有新的体会。
因为在Codex cli中,一条用户指令会进入
run_turn()。这个函数内部本来就是一个持续循环:```
模型推理
→ 调用工具
→ 把工具结果交回模型
→ 再推理
→ 再调用工具
→ 直到任务完成
``Codex cli的代码明确说明,同一个ModelClientSession` 会在整个 turn 内复用;每次采样前,Codex cli 从当前 history 构造新请求。关键代码逻辑可以简化成:```
loop {
let result = sample_model(history).await;
execute_tool_calls(result).await;let needs_follow_up = model_needs_follow_up || has_pending_input;
if needs_follow_up && token_limit_reached {
run_auto_compact(
CompactionReason::ContextLimit,
CompactionPhase::MidTurn,
).await?;continue;
}if !needs_follow_up {
break;
}
}
``实际源码中,在模型仍需继续工作、同时 token 阈值已到达时,Codex 会调用:``
run_auto_compact(
...,
CompactionReason::ContextLimit,
CompactionPhase::MidTurn,
)
``压缩成功后直接执行continue,回到同一个run_turn()` 循环,不会结束当前任务。所以真正发生的是:```
用户下达一条大型任务
↓
窗口 1:分析、读文件、改代码、测试
↓ 快满
Mid-turn compaction
↓
窗口 2:沿用压缩状态继续修改、测试
↓ 快满
Mid-turn compaction
↓
窗口 3:继续执行
↓
最终完成并回答
```只要任务尚未完成并且压缩成功,这个流程就能重复触发,不仅限于两个窗口。所以大概在这里,Tibo指的是我们在设置config.toml时常常会手动设置的```
model_auto_compact_token_limit = 175000
model_auto_compact_token_limit_scope = "total"
``选项,但这个确实没有必要,**不填写model_auto_compact_token_limit`,让模型自己的默认阈值生效可能才是最好的选择,因为这会导致滚动截断的发生**当前Codex Cli的
main分支已经把:```
remote_compaction_v2
``标记为:``
Stage::Stable
default_enabled: true
```而且源码注释明确写的是:Enable remote compaction v2 over the normal Responses API.
所以也无需在config.toml中单独开启它
总之读完之后感觉对ChatGPT的压缩魔法有了更深的认识吧。
主楼 - ZRainbow2026-07-31
省流:关掉
model_auto_compact_token_limit的设置 - SharkyMew2026-07-31
OpenAI的压缩挺高科技的,它有专门的一个compact API接口,具体发生了什么不知道,反正GPT系列模型针对这个压缩方式有专门优化,上下文剪短了但都还记得
- ZRainbow2026-07-31
这个推文和文章大概就是侧方面说明:我们的压缩魔法超级牛逼,用API会更牛逼
- SharkyMew2026-07-31
理论上来说开的套餐(Plus、Pro)也一样,API用不起 ^-^
- 花季无言2026-07-31
确实是很牛逼,claude的压缩都没这个狠
- ZRainbow2026-07-31
claude…先把缓存弄明白再说吧…
- ZRainbow2026-07-31
 Angel2026-07-31
- ZRainbow2026-07-31
- 渐忘2026-07-31
省流:关掉
model_auto_compact_token_limit的设置Codex 的上下文默认 373K,而 GPT 5.6 Sol 在超过 272K 后按照 输入 2 输出 1.5 的倍率进行计费。
佬,这个关掉设置是不是会消耗额度变多 ^-^怎么取舍好
- kkgllor2026-07-31
长文计费是谣传,之前 Tibo 辟谣过了。那是给 API 设置,不是给 Codex 套餐 的。如果你用的就是 Codex 套餐,随你喜欢用不用长文都行,用长文的话,即使是有缓存,肯定消耗也是比短的多点嘛。但是确实没有多加收费。
- Decidable64712026-07-31
魔法个什么 最近 codex 老回复远古的时候我的发言 比 Claude cli 差多了