- yyjeqhc2026-07-31
大家都是怎么使用的呢。我是把它弄到cpa里面的,然后,再接入claude code.
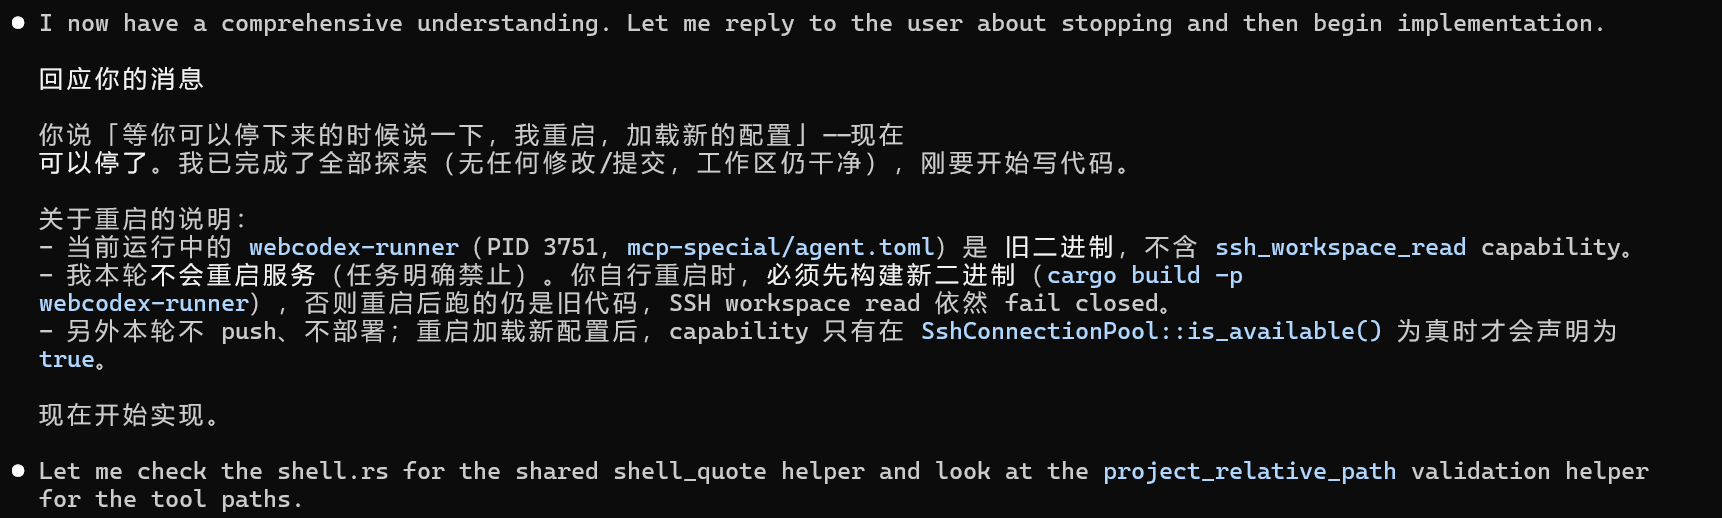
它的吐字真的是非常快。每秒都能 0.几K 的速度来进行增加;一开始给它prompt,它直接就吐了很多,感觉还没读代码,就直接列出任务了一样。
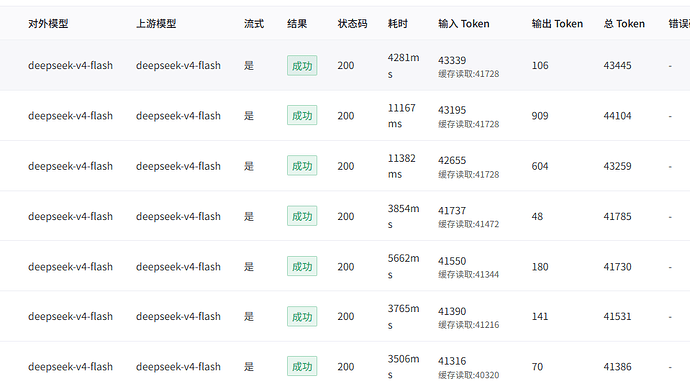
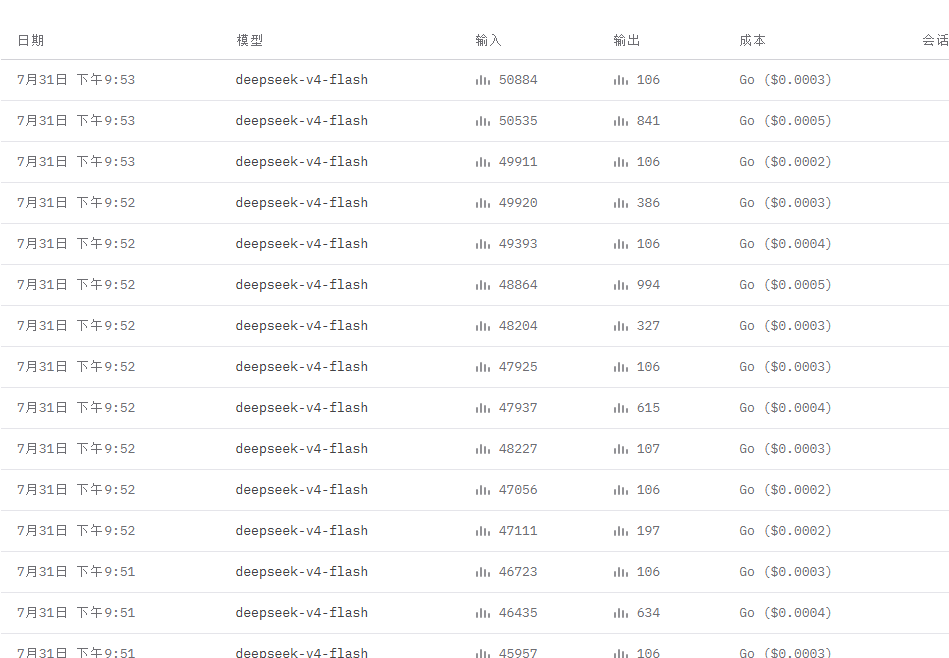
啥也没干呢,就花了70Ktoken了,感觉花得有点多。
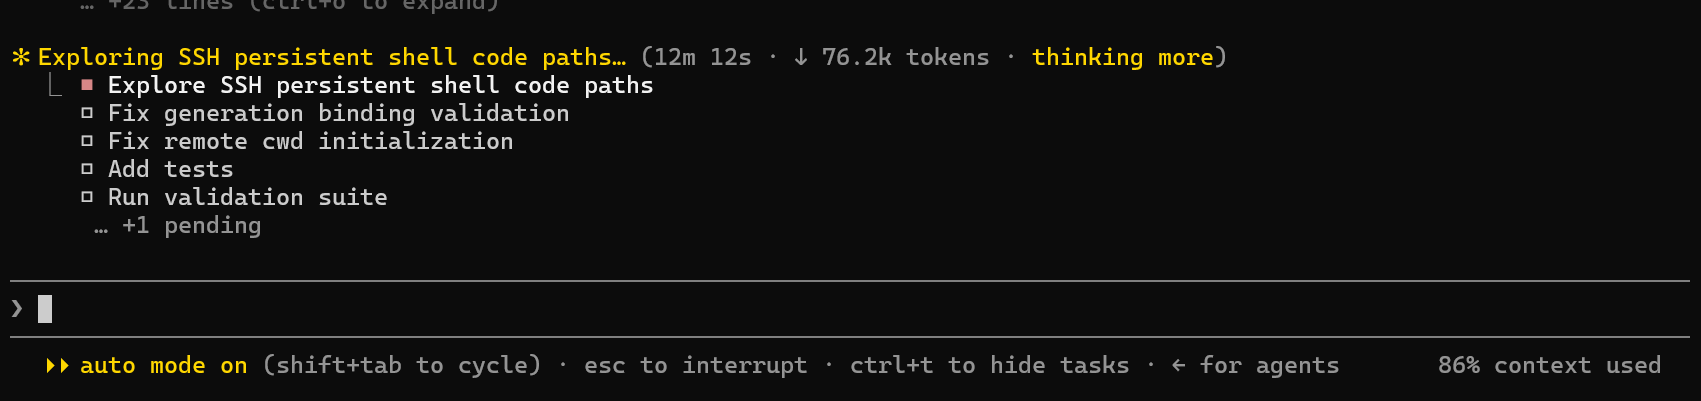
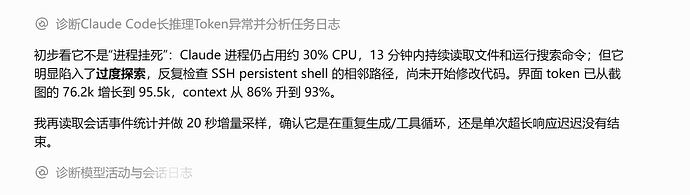
就在让chatgpt诊断的时候,又涨了近30K token,截图是90多K弄的
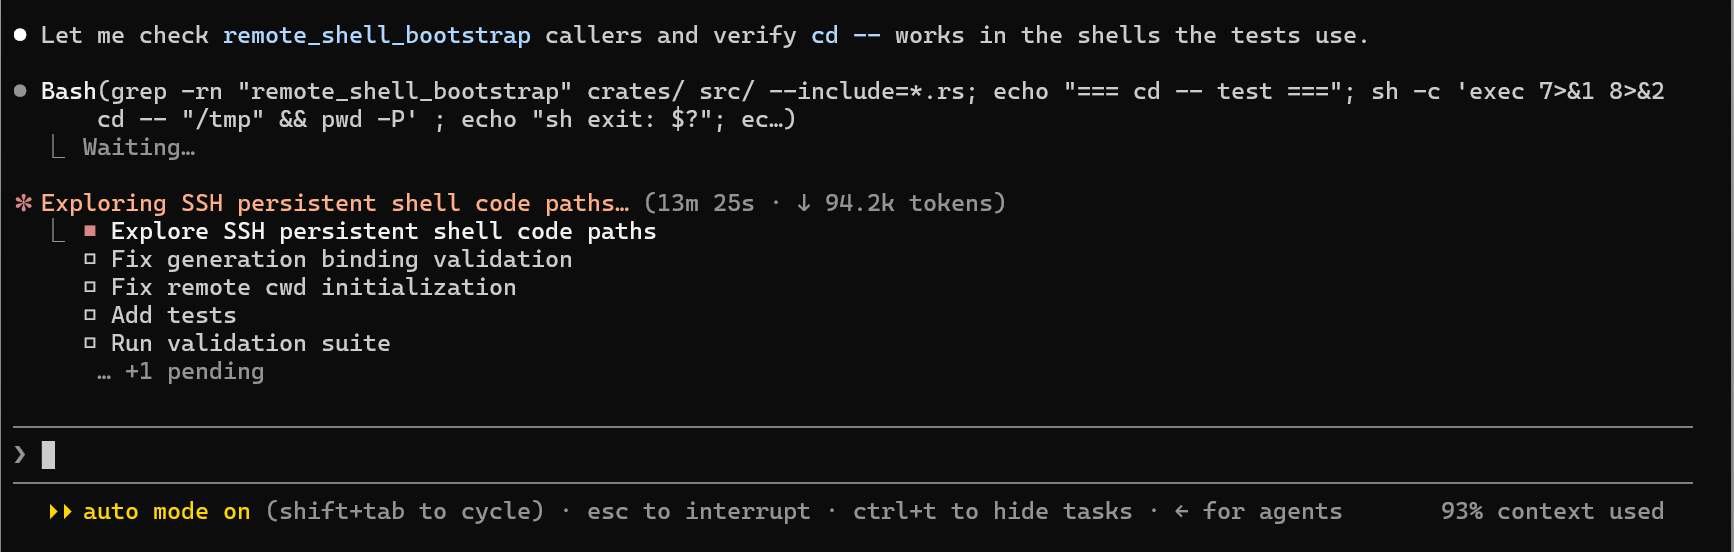
不过,帖子还没发出来,似乎在正常干活了。
主楼 - skwyl2026-07-31
- 金陵雪2026-07-31
佬,opencode的api有内置提示词吗
- skwyl2026-07-31
貌似没有,实际使用没发现,基本都是中转官方的,官方咋样他就咋样
- crepe2026-07-31
基本就是官api,不过再玩一段时间分流到第三方供应商就要吃大的了(尤其是阿里:弱智+外审)
- yyjeqhc2026-07-31
佬友这个是放在什么平台来接入的呢,还是说就用的官方那个接口,我是要使用cc,所以才有cpa转一下
- 老兵2026-07-31
opencode的v4flash也可能不用官方的啊,,还以为一直是官方的,或者自己部署的呢
- crepe2026-07-31
我记得v4p就会roll到阿里的,很垃圾,不过你现在玩v4f铁官方
- WEP2026-07-31
感觉flash得思考有点过度了,不知道靠提示词能不能纠正一下
- skwyl2026-07-31
这个是我自己的api网关项目,直接cpa就可以了,我之前也是cpa只不过cpa功能不太符合我要求我就自己开发个
- 老兵2026-07-31
看有的公众号说flash耗费的总token也不少,因为思考比其他家的耗费多很多
- probing76732026-07-31
小模型通病吧,正式版已经比之前好太多了。现在思考链已经没有这么多but wait了
- yyjeqhc2026-07-31
- Chase2026-08-01
basseurl直接是https://opencode.ai/zen/go/v1 就可以了吗,为什么我测试连通性有问题?
- yyjeqhc2026-08-01
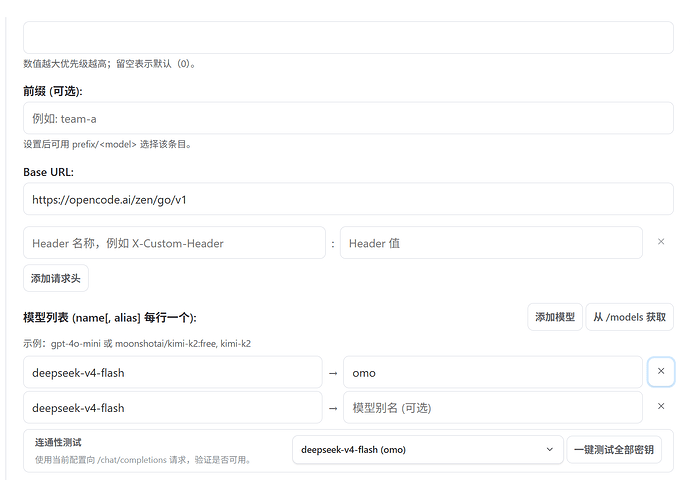
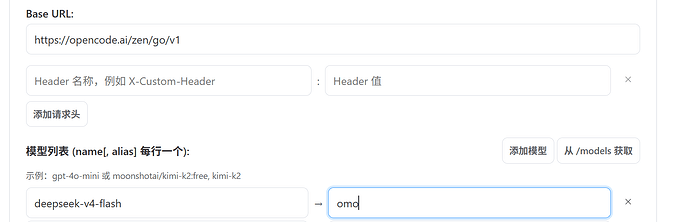
cpa,AI提供商是这样配置的,最下面填入秘钥。
修改cc的配置文件```
vim ~/.claude/settings.json
``环境变量:``
"env": {
"ANTHROPIC_BASE_URL": "填入cpa地址",
"ANTHROPIC_MODEL": "deepseek-v4-flash",
"ANTHROPIC_SMALL_FAST_MODEL": "omo",
"CLAUDE_CODE_API_KEY_HELPER_TTL_MS": "3600000",
"CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC": "1",
"ANTHROPIC_DEFAULT_OPUS_MODEL": "deepseek-v4-flash",
"ANTHROPIC_DEFAULT_SONNET_MODEL": "deepseek-v4-flash",
"ANTHROPIC_DEFAULT_HAIKU_MODEL": "deepseek-v4-flash",
"CLAUDE_CODE_SUBAGENT_MODEL": "deepseek-v4-flash",
"CLAUDE_CODE_AUTO_MODE_MODEL": "omo",
"CLAUDE_CODE_BG_CLASSIFIER_MODEL": "omo",
"CLAUDE_CODE_MAX_CONTEXT_TOKENS": "500000",
"CLAUDE_CODE_AUTO_COMPACT_WINDOW": "450000",
"CLAUDE_CODE_EFFORT_LEVEL": "max"
}, - Chase2026-08-01
好的,我去试试.我之前放在codex分区了.