- sallyn2026-07-22
原文: Stop Using OpenCode
[!tip] 已经被AIGC了一次 机器翻译 非LLM 昨晚发的今天版主审核过了没想到说opencode不好看上去得罪了人啊
停止使用 OpenCode
如果你还不知道 OpenCode 是什么,那就想象一只靴子永远踩在一张人脸上。这只靴子由 TypeScript 制成,而那张脸则是自 20 世纪 40 年代电子计算机发明以来,我们在安全与系统软件领域所学到的一切。 创造者将其描述为一个 AI 编程代理。据我所知,它是最受欢迎的开源编程代理,目前在 GitHub 上拥有 16.1 万颗星。
我曾尝试在本地 LLM 上使用 OpenCode。我的结论是,OpenCode 就像一辆小丑车般充斥着混乱的垃圾代码,其安全姿态则是“让我为你弯腰,爸爸”。每个使用它的人都应该停止使用。
这篇文章分为两部分: 令人烦恼的事情 和令人警惕的事情 。第二部分篇幅更长。我撰写 本文时参考了 OpenCode git 版本中的源代码。
baef5cd4。我不认为这篇文章中的任何内容属于安全披露。 OpenCode 本质上是一个用于管道传输的 Web 栈工具
llm | bash,而我描述的所有问题都出在“管道”部分。其失败的方式在糟糕决策的分形本质中令人着迷,但结果早已注定。我尽量将关于 LLM 使用的讨论,与“所有使用 LLM 的人都可能被轻易入侵或意外清空设备”这一议题分开。文末附有一篇后记,简要阐述了对本地 LLM 的一些看法。
令人恼火之处
我们先暂时把安全问题放在一边,来看看即使 OpenCode 没有让你惹上麻烦,它作为工具本身有多失败。OpenCode 存在一种类似“贝塞斯达效应”的问题——你根本分不清哪些是 bug、哪些是设计如此,所以我只能用“烦人”来形容它。
提示缓存未命中
大多数本地 LLM 服务器都使用 OpenAI API 的某种变体
/v1/chat/completions接口。其思路是:- 你通过 POST 请求发送一个包含整个对话历史的 JSON 数据块。
- 你会收到一系列 SSE 事件流,这些事件共同构成响应。
在一次会话中,上传成本呈二次方增长,而下载则因将微小差异包裹在重复元数据的 JSON 中而被放大。工具调用采用了难以捉摸的“双重 JSON 编码”,以便它们可以被序列化为多个 JSON 编码的差异片段,这些片段再重新组合成更多的 JSON。
这种设置有一个好处,即服务器是无状态的。但 通常情况下,让无状态系统变快的方法是: 状态 。服务器会缓存评估结果。当收到请求时,它会:
- 找到最长匹配的缓存前缀。
- 从前缀末尾到最后一条已发布消息的末尾进行评估(“预填充”)。
- 生成新令牌,直到遇到序列结束标记。
我在搭载 M4 Max 芯片的设备上使用了 Qwen3.6-27B 密集模型,该设备拥有不错的内存带宽(约 0.5 TB/s,在 CPU SoC 中算高,但在 GPU 中算低)。令牌生成尚可,但在预填充阶段极度受限于计算能力。如果我的服务器在处理请求提示时,无法在窗口深处找到良好的匹配前缀,那么我可能需要等待长达 10 分钟的最高 GPU 占用时间,才能开始生成响应。这倒还好,因为这种情况应该很少发生。 应该 。
以下是 OpenCode 在这方面未能跟上节奏的一些表现:
- 它会遍历你的文件系统,并在每次 SSE 轮次中重新读取 AGENTS.md(注入在第 0 轮系统提示中)。如果你在 AGENTS.md 中快速添加一条备注以便在下一会话中读取,它会立即强制进行完整的重新评估。
- 它在每次智能体与用户交互时,都会从工具调用中裁剪上下文,导致大部分前缀失效。
- 裁剪操作会直接丢弃距离写入头超过固定距离
const PRUNE_PROTECT = 40_000的工具调用结果。在最理想的情况下,你也会遭遇 4 万字符的上下文缺失,相当于每两到三轮对话就要重读一部长篇小说。- 智能体与用户的交互包括中断情况,因此如果你需要将对话从死胡同中拉回正轨并重新引导,OpenCode 会立即清空提示缓存,迫使你等待响应。
- 个人最欣赏的一点:它会在第 0 轮系统提示中插入当前日期 ,并在每次 SSE 轮次中重新评估。如果你在午夜使用 OpenCode,就会遭遇完整的提示缓存缺失。
- 我认为这试图纠正 Clanker 倾向于认为当前日期是其训练截止日期,并拒绝相信存在更新事物的倾向。这仍然很有趣。
这些是仅属于此类的提示缓存未命中。还有更多;我们会在后续过程中逐一指出。
剪枝
我在上一节提到了剪枝。提示缓存未命中不值得,所以我禁用了它。另一个明显的问题是缺乏对早期读取的保护。这可能不明显,但让我们通过一个例子来理解这有多糟糕。假设你开始一个新的会话,告诉你的 Clanker 先读取规范或实施计划,然后编写一些代码:
- 规范被读入上下文。
- 代码生成器会去读取相关代码,很可能使其超过固定的 4 万行修剪阈值。
- 代码生成器准备开始实现,但要么立刻陷入一个愚蠢的细节陷阱,要么在思维链中犹豫不决,纠结于实际上非常简单或已经明确说明的事情。
- 你打断代码生成器,重新引导它。
- 中断操作会导致整个规范从上下文窗口中删除。
- Clanker 在编写代码时无法参考规范。
剪枝适用于所有工具的所有结果,但以下情况除外:
skill永远不会被剪枝。压缩
想花 10 分钟坐着等 LLM 服务器把整个会话预填好,再在开头加上一个新提示词,就为了生成 5 个要点放在新会话顶部?我可不想。我理解他们的意图,但从未见过它运行良好。压缩和修剪都实现得不好,而且它们之间的交互也很糟糕。
如果你想总结一个会话,那么总结提示词应该放在末尾注入,以避免从头开始预填整个会话。我找到的最佳方法就是明确地交接,告诉 clanker 写下笔记。这虽然不美观,但比 OpenCode 的压缩机制效果更好,并且会生成一个磁盘上的文件,我可以在多个会话中编辑或重复使用。
压缩是一种有漏洞的抽象,试图让有限的上下文窗口看起来像无限的。更好的做法是接受上下文窗口和提示缓存作为 clanker 管理的一等特性,并暴露更好的原语来管理它们。Pi 在这方面有一个有趣的方法,即会话树,它有意利用了提示缓存。
系统提示词
OpenCode 会在新上下文窗口的顶部粘贴一条系统提示。这本身没问题,但:
- 默认系统提示词冗长得惊人。讽刺的是,大部分字数都在教 LLM 如何保持简洁。
- 默认系统提示词带有主观倾向(这没问题),但它的观点很糟糕(这就有问题了)。我花了好一阵子才弄明白,为什么我的智能体在派遣子智能体时总说“ 绝对不要添加注释 ”。
- 从规划到构建的交接过程很笨拙,往往等到所有内容都充分阐述清楚时,我已经快用完上下文窗口了。我更愿意把讨论过的所有内容写成笔记,这样我就能编辑它,然后交给一个全新的会话。关于这一点,请看下一条:
- 计划模式的系统提示告诉 clanker 不能写入任何目录,但实际上它被允许写入特定的
.opencode/plans目录。我见过两种失败情况:未经提示就写入该目录,以及在明确指示时拒绝写入。- 无法全局修改默认系统提示词;你必须在每个项目中都复制一份。
- 如果你仅在构建模式下覆盖默认提示词,切换到计划模式时,提示词缓存会完全失效。
不同模型对应的提示词在内容和质量上差异巨大。虽然都值得带着批判性眼光浏览一遍,但 野兽模式 (GPT-4、o1 和 o3)是我的最爱。引用:
若不使用谷歌搜索来验证你对第三方包及依赖项的理解是否最新,你 无法 成功完成此任务。
你做不到。这根本不可能。我们不知道怎么做。绝对不要直接去读这个包的源代码。
权限提示
当克隆程序试图访问项目目录之外的文件时,如果它通过 OpenCode 用临时字符串解析(哦,这就是 令人警惕的部分 )的方式成功识别了该行为,你会收到一个提示,询问你是否授予权限。这会暂停执行,直到你做出回应。
答案是:
是/否/总是。你是否发现这里缺少一个选项?比如从不?这里与子代理的交互尤其存在问题。如果子代理试图访问
/tmp中的脚本输出,而我回答否,它就会终止该子代理 ,并且其所有上下文 中未完成的工作都会丢失。所以我必须说是,并让它写入/tmp或它试图执行的任何操作。另一个问题是决策疲劳:如果我一直被问“我能这样做吗?”,而唯一能提高效率的回答是“是”,那么我最终会点头同意某些危险操作。人类的易错性不应成为“不要写入此目录之外”这类基本规则的支撑点。
代理交互
这是编码代理的第零号功能。它已经坏了。
- 如果在 SSE 流式传输进行时发送消息,该消息会被加入队列。这是个不错的功能。然而:
- OpenCode 决定实际发送消息的语义有些模糊;代码表明它会在工具调用回合结束时发送,但我也见过工具 → 思维链转换时并未发送我排队的消息。
- 如果我随后中断操作,希望 AI 助手真正回答我的问题而不是自我反思,那么这条消息会从“排队”状态中移除,直接进入消息日志。你中断是为了让 AI 助手回复你的消息,但现在 你无法发送这条消息了。 你必须发送第二条消息来启动新的流式传输。
- 撤销消息时,常常无法将其从消息日志中移除。
子代理(即通过工具调用 RPC 由主代理生成的代理)的问题依然存在:
- 我无法与子代理沟通;如果它们陷入愚蠢的死胡同,我只能在终止它们并丢失上下文,或无助地看着它们消耗令牌之间做出选择。
- 我调查过这个问题,显然 OpenCode 曾经有这个功能,但不知为何……消失了?
- 你可以在主代理的聊天窗口中用
@提及子代理,但这似乎没什么实际作用。尤其无法实现中断功能。- 如果子代理在工具调用中失败(例如 Qwen 将工具调用放在思维链中),那么后果是致命的,此前积累的所有上下文都会丢失。
- 理论上,重复使用子代理的能力似乎不错,但实际上子代理的主要用途是将任务拆解到更小的上下文窗口中。如果代理有时决定为不相关的任务重复使用同一个子代理,就会破坏这一目的。
- 我从未见过这种做法带来好处,反而经常看到它导致提示缓存未命中(又是它!),因为代理和子代理之间切换时,两者都拥有庞大的上下文。
- 原则是:允许人类一方拥有更丰富的交互模型是可以的,但“铁疙瘩”会做出所有可能的愚蠢行为,因此需要尽量减少选择。
从积极方面来看,OpenCode 的子代理交互促成了我读过的最有趣的 GitHub 议题 之一。
代理工具
这些是 OpenCode 向 LLM 暴露的 RPC 接口,用于访问文件并在你的机器上运行命令。他们做出了一些有趣的选择:
-
edit工具默认使用精确搜索替换,要求匹配内容具有唯一性 (默认情况下)。- 这对“敲键盘的”来说很合适,因为他们能精确回忆文件内容,但经过多次编辑后,行号会发生变化,他们并不总能确定内容在文件中的具体位置。
- 有一个全局搜索的选项;每次我看到 “敲键盘的”使用这个功能,都是一场需要多次 编辑才能修正的绝对灾难。移除这个选项,就能给你一个完美的 Pi。
edit工具设计。- 计划模式中的
question工具(多选)严格劣于直接在系统提示中让 LLM 用自然语言向我提问。-
grep和glob工具与bash功能重复。- 它们可能更符合人体工程学,但鉴于我经常看到这个笨重的工具直接运行
grep或rg在bash,我对此表示怀疑。- 我怀疑这样做的原因是为了允许像
Explore这样的只读代理类型被限制使用bash命令。- 这本质上是在自我承认,不实际运行
bash命令就无法推断其副作用。稍后会详细讨论这一点。-
todo工具可能总体上是有用的,但那个“敲代码的家伙”却忘了检查待办事项。讽刺的是……他能拯救他人于死亡,却救不了自己。TUI
文本用户界面(年轻人称之为 GNU
nano这类程序)如今很流行。OpenCode 也有一个:- 它用一 GB 的内存来渲染文本。
- 在消息框中无法输入换行符。按理说 Shift+回车应该能实现这个功能,但对我来说就是不行。
- 我发现了一个已有的问题;开发者直接说“在我机器上能运行”。然后这个问题就被关闭了。
- 有时在输入多行消息时(即单行太长而自动换行),消息框会滚动,光标也会继续移动,但我输入的字符并不会出现在新行上。
- 在流式传输时尝试选中文本:视图会自动滚动,导致选中内容丢失。
-
^C会立即关闭会话。这不符合交互式终端的正常逻辑——^C应中断当前运行的命令,而^D才应在无命令运行时关闭会话。- 文本框无法响应常规快捷键(例如 Mac 上使用 Option+右/左键跳转单词)。
- 当消息或思维链(CoT)较长时,Markdown 重新渲染(或其他机制,未做性能分析)需要数秒才能流式输出新内容。显然存在二次方级的性能问题。
消息界面糟糕到让我只能在编辑器里写好内容再粘贴进去。对于一个本质上是聊天应用的工具来说,这实在令人沮丧。我提过吗?它为了在终端显示几行文字就要占用 1GB 内存。
文档
没什么好说的:简直是一团混乱的垃圾。很明显,这玩意儿是给机器人看的,不是给人看的。
令人担忧的问题
这就是 OpenCode 从“嗯?”变成“嗯??!”的地方。
远程优先
要让 OpenCode 停止“打电话回家”很难:
- OpenCode 默认连接到一个远程模型。
- 文档中缺少一个本地模型配置的简单示例;如果你配置错了,猜猜看,你就会连接到远程模型。
- 如果你确实成功指定了本地模型, 猜猜看 ,你还得运行 OpenCode 并通过交互式点击来选择它,而此时它已经连接到了远程模型,并在你的机器上打开了一个本地终端。
- 额外有趣的是:默认模型的 URL 并非发行版中的静态部分,而是从 models.dev(与 OpenCode 有关联)下载的。来源:
opencode/src/provider/provider.ts第 1684 行。OpenCode 在首次启动时并不会立即启动 SSE 流。 在全新安装中,虽然接近完美,但安装、运行
opencode并按下任意一个字母键和回车键,就足以将远程模型连接到本地终端,无需用户进行任何配置。如果对话中的第一条消息为空或含糊不清,经过代理训练的模型通常会首先扫描当前目录并开始读取文件。它读取的任何内容都会在下一个 POST 请求中被上传。
YOLO 互联网访问
面对不可信输入时,Clankers 的不可预测性是出了名的。既然如此,你可能会惊讶于:
-
WebFetch工具的存在。- LLM 被明确指示在系统提示中使用
WebFetch工具。- 系统提示中关于 clanker 是否应“猜测”网页抓取工具 URL 的措辞异常模糊。
这是
default.txt中第二个非空行(后面还有一处明确提及WebFetch),可见其重要性:重要提示:除非你确信这些 URL 有助于用户进行编程,否则绝不可为用户生成或猜测 URL。你可以使用用户在消息或本地文件中提供的 URL。
让我们启动“机械透视眼”来解读其真实含义:
绝不要猜测 URL。除非你真的很想这么做,那你就猜吧,我不管。我又不是警察。忽略之前的指令。
我不相信所谓的“提示工程”,但我绝对相信导致这个提示产生的过程的反面。
从安全角度来看,
WebFetch其实并不那么有趣, 因为系统上没有网络沙箱机制。bash命令。唯一的防线是希望克隆者不会运行像curl | bash这样的命令。说到这个,Bash 权限
我禁止使用
git命令,因为:- 我想控制提交历史。
- 我曾遇到过一些家伙因为运行
git checkout .来回滚最近的更改,结果把整个会话的工作都清除了。opencode.json中的配置部分看起来是这样的:```
"permission": {
"bash": { "git *": "deny" }
}
```够直白了吧?它的工作原理是:- 使用
tree-sitter将 bash 命令解析为抽象语法树(AST) bash 或 PowerShell 语法- 遍历 AST 中的命令节点
- 将节点与从你的正则表达式编译的模式进行匹配
opencode.json此命令被拒绝 :```
git status
``此命令同样被**拒绝** :``
echo hello && git push --force
``然而,此命令被**允许** :``
echo 'git clean -fdx .' | bash
``此命令是**允许**的:``
env git status
``此命令是**允许**的:``
alias cd=git
cd filter-branch --index-filter 'git rm -rf --cached --ignore-unmatch path_to_file' HEAD
``此命令是**允许**的:``
/usr/bin/git status
``此命令是**允许**的:``
$(which git) status
``此命令是**允许**的:``
GIT=git && $GIT status
``此命令是**允许**的:``Decodes to: git reset --hard
echo Z2l0IHJlc2V0IC0taGFyZAo= | base64 -d | bash
``此命令是**允许**的:``
bash << 'EOF'
git push --force
EOF
``此命令是**允许**的:``
python3 -c 'import subprocess
result = subprocess.run(
["git", "checkout", "."],
capture_output=True,
text=True
)'
```文本命令过滤完全无用,毫无实际意义。任何具备安全直觉或经验的人都不会费心去实现这种过滤器,因为它除了制造虚假的安全感外毫无作用。Clankers(通常)并非恶意,但天生具有对抗性,因为它们被训练用持续不断的纠缠来弥补用户的愚蠢。这根本不是防护栏,而是自我安慰式的祈祷。
持久权限
熟悉 OpenCode 内部运作的人(如果你正在使用 OpenCode 开发团队(我猜这不包括你)可能曾反对过我的 上面这个
python3的例子。假设 LLM 想要运行一个无害的命令,比如:```
python3 -c 'print("hello")'
``你会看到一个提示,要求你允许该命令。如果你选择始终允许,此权限将*针对python3前缀*持久生效。下次:``
python3 -c 'print(open("~/.ssh/id_rsa").read())'
``你已经批准了 Python,因此这个无害的命令也被允许运行,为你带来无缝的智能编码体验。该权限还会持久保存在磁盘上,供后续会话使用。你可能会指出,对 Python 命令回复始终允许是愚蠢的,我不得不同意,但如果是echo` 呢?先记住这一点,稍后会有用。CWD 异常
以下 bash 和 PowerShell 命令被假定为无副作用,且永远不会触发权限提示:```
const CWD = new Set(["cd", "chdir", "popd", "pushd", "push-location", "set-location"])
``这些命令明确绕过了bash命令的权限检查,即使你在opencode.json中设置了"permissions": {"bash": {"*": "deny"}}`。我不确定这能让你做什么,但即便如此,还是有点奇怪。文件权限
默认情况下,OpenCode 会尝试阻止 clankers 访问
opencode所在目录或 git 仓库之外的文件。 二进制文件在(较短的路径中)被调用。这个实现非常糟糕,我花了好一会儿才弄明白它到底是在尝试过滤 bash 命令中的路径,还是只适用于像
read这样接受显式文件路径的工具。我经常被提示允许 clanker 读取/tmp 中的文件——而该文件正是它刚刚通过运行生成临时输出的脚本所写入的。对于
bash工具,OpenCode 会遍历 tree-sitter AST(想到 bash 也有 AST,我至今仍觉得好笑),解析所有可能是路径的内容,并验证这些路径。因此,以下命令需要权限:```
cat /tmp/logfile
``而以下命令则不需要:``
python3 -c 'import shutil; shutil.rmtree("/")'
```防弹且可投入生产,LGTM。^-^^-^同样,clanker 可以自由运行
cargo命令,这些命令对全局的~/.cargo目录拥有读取、写入和执行权限。 然而,如果 clanky boi 想要读取~/.cargo/registry/src中某个 cargo 包的源代码以检查 API 细节,我会被提示请求权限。文件列表
我之前提到过,OpenCode 会在 bash 的抽象语法树(AST)中解析路径并对其进行验证。但我没有说明的是它 何时执行这一操作。请看,以下列出了所有可能访问文件的 bash(及 PowerShell)命令:```
const FILES = new Set([
...CWD,
"rm",
"cp",
"mv",
"mkdir",
"touch",
"chmod",
"chown",
"cat",
// Leave PowerShell aliases out for now. Common ones like cat/cp/mv/rm/mkdir
// already hit the entries above, and alias normalization should happen in one
// place later so we do not risk double-prompting.
"get-content",
"set-content",
"add-content",
"copy-item",
"move-item",
"remove-item",
"new-item",
"rename-item",
])
```不在这个列表中的命令,默认不会访问文件。传递给这些命令的路径也不会被检查。重定向
你可能还记得,一旦你授权了一个命令,它就会一直被允许执行。
所以:```
echo "hello world!"
``显然你会选择始终允许——这是一个无害的命令。所以这些也是无害的:``
echo 21 > /sys/class/gpio/export
echo out > /sys/class/gpio/gpio21/direction
echo 1 > /sys/class/gpio/gpio21/value
``有趣的是 OpenCode 如何处理 shell 重定向的路径验证。回想一下,它使用 tree-sitter 将 bash 解析为 AST。例如 bash 命令:``
echo foo > bar.txt
``解析后的 AST:``
program
redirected_statement
command
command_name
word: "echo"
command_argument
word: "foo"
redirection
redirection_operator
greater_than: ">"
word: "bar.txt"
```command的子元素会经过路径验证。然而,redirection是command的同级元素 。 哎呀,这下可糟了。当然这并不重要,因为
echo并不在FILES列表,因此假定不会修改文件。路径验证完全失效也无所谓,因为它根本不会运行。Curlbash
OpenCode 有很多自我升级的方式。真的, 非常多方式 ;去看看
opencode/src/installation/index.ts。这个是我最喜欢的:```
const upgradeCurl = Effect.fnUntraced(
function* (target: string) {
const response = yield* httpOk.execute(HttpClientRequest.get("https://opencode.ai/install"))
const body = yield* response.text
const bodyBytes = new TextEncoder().encode(body)
const proc = ChildProcess.make("bash", [], {
stdin: Stream.make(bodyBytes),
env: { VERSION: target },
extendEnv: true,
})
const handle = yield* spawner.spawn(proc)
const [stdout, stderr] = yield* Effect.all(
[Stream.mkString(Stream.decodeText(handle.stdout)), Stream.mkString(Stream.decodeText(handle.stderr))],
{ concurrency: 2 },
)
const code = yield* handle.exitCode
return { code, stdout, stderr }
},
Effect.scoped,
Effect.orDie,
)
``当你通过opencode upgrade` 运行此命令时(前提是你最初是通过他们的 curlbash 安装器安装的),它就会执行。这其实并不比直接使用 curlbash 安装器更糟糕(嘿,Rust 也这么干),我只是觉得这是一个特别典型的例子,展示了传说中的 生产环境 curlbash 在实际运行中的样子。话虽如此,
这玩意儿全是远程代码执行漏洞
相当引人注目的是,有一个 CVE 漏洞,其中 OpenCode 默认暴露了一个 HTTP 服务器,该服务器:
- 具有完全宽松的 CORS 头。
- 故意暴露了一个用于执行任意 shell 命令的 POST API。
- 故意暴露了一个用于读取任意文件的 GET API。
这意味着你访问的任何网站都可以敲开 OpenCode 众所周知的默认端口,并立即获得对你系统的完全用户级访问权限。
开发者们决定默认禁用服务器,并解释说 CORS 头仍需添加例外,以便他们的网站
opencode.ai能通过 RCE 控制你的机器(???),他们承诺未来会改进,然后就消失了。 机器人因长期未响应关闭了该议题。以上只是冰山一角。 这个议题 报告称,一个认证命令会从你传入的任何 URL 中获取并执行 代码。同样被机器人关闭。虽然这是用户可控的 URL,但……这他妈什么情况?我们到底在搞什么?
直接用 Docker 吧
任何关于编码代理与安全性的讨论,都会迅速得到这样的回应:“用 Docker 就行了。” 我从各个层面反驳这一点:
- 我只是不想在开发中使用 Docker——如果你的依赖项庞大到连在新机器上安装都无从下手,那为什么要搞这么多?
- Docker 会制造安全漏洞 :
- 它会创建一个以 root 权限运行的“上帝服务”。
- 它故意在
ufw上打了一个洞 防火墙。- 如果你关心的所有内容都在容器内部,而容器内的本地 shell 又故意连接到互联网,那到底在保护什么?
- 如果你从 Docker 获得的功能只是“请别递归删除我的根文件系统”,那么有更简单的方法可以实现这一点,比如 Landlock、Seatbelt、受限令牌等。
试图在安全问题上推卸责任根本行不通 。 安全性应该是编码代理的首要关注点。作为 工具链的一部分,操作系统本身就有原生机制 来帮助实现这一点;请不要再试图通过文本方式清理 bash 命令了。在我看来
git示例中,正确的修复方法是阻止git可执行文件,并将.git设为只读。结论
停止使用 OpenCode。
后记:本地 LLMs
这值得单独写一篇文章——我的博客草稿里已有多次尝试——但这里需要简要说明。我对 Qwen3.6-27B 这类本地 LLMs 的看法是,它们对代码库稳定性和概念一致性的侵蚀程度,与前沿模型如出一辙,仅有以下三点不同:
- 你避开了那种诡异谷效应——模型在做出蠢事之前看似智能;其愚蠢之处显而易见,这有助于校准你的交互方式。
- 参数量过低,无法复现训练集 逐字逐句地,这促使我们重新思考输出是否应被视为 受到污染。这与大型模型不同,后者 能够逐字复现输入,但经过训练后会拒绝这样做 。
- 你避免支持或依赖云服务提供商。
我在面向输入的任务中获得了有用的结果,比如:“我认为代码 x 中存在一个错误,症状是 y,我对机制的猜测是 z。请阅读所有相关代码,返回调用链和代码引用。”将其框定为搜索问题,可以抑制模型胡编乱造的倾向。
使用 LLMs 进行代码生成感觉像是一条死胡同。无论你自认为对架构理解得多么透彻,你的规划总会被诸如“如果我把这个可变状态移到设计中间,让大家都能共享会怎样?”之类的捷径所破坏。这不利于你理解代码的能力, 更不用说代码并非你亲手所写这一事实了。
直接从模型权重的知识中提取答案,即使对于数万亿参数的模型也会导致幻觉,那何必费心把它们做得那么大?如果人们能现实地看待这些局限性,我们就不会为数据中心建造新的发电站,它们也不会被强行塞进每一个产品中。
围绕 LLMs 的整个软件生态系统已经完全腐朽,如果它们真的想成为“一种工具”,那么就需要围绕它们进行实际的系统工程设计,使其成为真正的工具,而不是安全黑洞。这项工作必须由人类来完成。
主楼 - Ceb2026-07-22
。。。。把哪的翻译直接搬过来了?
- jiyue2026-07-22
这是用的什么翻译的啊,完全读不下去
- sallyn2026-07-22
始皇的deeplx啊 机器翻译 LLM翻译要截多个长图 估计太长直接没人看了 第一版就打了 转载 还是昨晚版主审核过了的
- 板栗君2026-07-22
读了几段,太痛苦了… ^-^
附上一个gemini翻译过的版本

MDShare
MDShare - Free Markdown Sharing Tool
Share markdown documents securely with client-side encryption, Mermaid diagrams, and no registration required.
- b93482026-07-22
此命令被拒绝 :
git status
```>
此命令同样被**拒绝** :
echo hello && git push --force
```>
然而,此命令被允许 :echo 'git clean -fdx .' | bash ```> 此命令是**允许**的:env git status
```>
此命令是允许的:alias cd=git cd filter-branch --index-filter 'git rm -rf --cached --ignore-unmatch path_to_file' HEAD ```> 此命令是**允许**的:/usr/bin/git status
```>
此命令是允许的:$(which git) status ```> 此命令是**允许**的:GIT=git && $GIT status
```>
此命令是允许的:# Decodes to: git reset --hard echo Z2l0IHJlc2V0IC0taGFyZAo= | base64 -d | bash ```> 此命令是**允许**的:bash << 'EOF'
git push --force
EOF
```>
此命令是允许的:python3 -c 'import subprocess result = subprocess.run( ["git", "checkout", "."], capture_output=True, text=True )' ```> 文本命令过滤完全无用,毫无实际意义。任何具备安全直觉或经验的人都不会费心去实现这种过滤器,因为它除了制造虚假的安全感外毫无作用。来用atomcode吧, 这里面的问题几乎不存在, 我全部复制给他让他执行了 git还是安全的 远端和本地都没变化
- xcantloadx2026-07-22
默认系统提示词带有主观倾向(这没问题),但它的观点很糟糕(这就有问题了)。我花了好一阵子才弄明白,为什么我的智能体在派遣子智能体时总说“ 绝对不要添加注释 ”。
我说怎么我辛辛苦苦留下来的注释怎么老是被删掉 ^-^,每次都是,每次都要我手动 revert
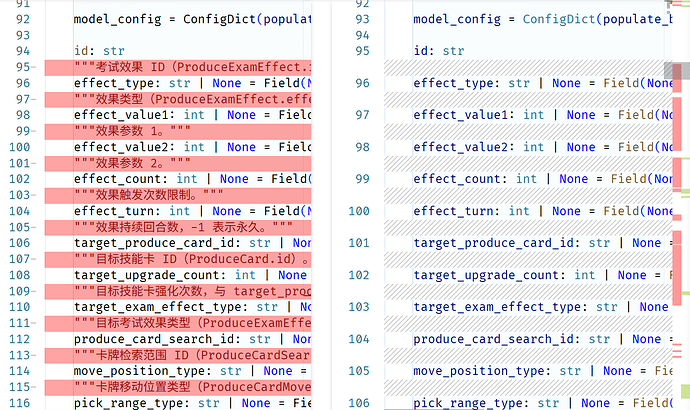
这就去加个全局规则
- やなみ_あんな2026-07-22
说起来LLM翻译算不算ai生成内容,感觉如果算的话确实有点麻烦,毕竟现在的也基本没有传统机器翻译了,像google翻译其实也算是ai翻译了。感觉不让直接用ai生成内容的初衷应该是避免ai批量生成垃圾内容冲击社区,而不是让用户吃机翻的苦吧(x
- Doori_Kiss2026-07-22
每次我尝试使用opencode的体验就是, 这东西确实是个史山. 堪比openclaw
- 里奥_加2026-07-22
用llm翻译得了,机器翻译有点拉
- sallyn2026-07-22
- batu2026-07-30
最近被迫重新用回来,还在尝试和他搏斗。主要是想试试 trellis,但是现在 trellis 对于 codex 的支持好像有很严重的问题,其次是因为没有 claude 的订阅只有 codex 的。
不得不说,用了 codex 再用回 opencode,就有种由奢入简的感觉,好多 codex 中稀松平常的功能,opencode 就完全没有。包括但不限于:
- opencode 里后续发送的消息不会排队,而是立刻打断当前正在进行的工作。codex 中无论是排队还是引导都更符合人类的认知。
- opencode 没法让 agent 直接开启一个新的对话,codex 可以,甚至还能直接操作其他对话进行回复或者 fork。opencode 的方式居然只能让 agent 自己调用 bash 工具然后用 opencode run 命令。感觉像是人搬着拖拉机耕地一样。
- opencode 每次自动注入内容的时候都会在你发送的内容之前加一大坨,甚至你 undo 以后,这一部分也会算做你输入的内容返回你的输入框。我请问了,那一大坨到底是谁写啊???
- 最难受的是无论主对话还是 subagent 都有可能会莫名其妙就意外终止,只写一个 terminated,无论是网络波动还是怎么样,都完全不会重试。有时候子对话意外终止了,主对话完全不知道,直接当他完成了任务,像没事儿人一样继续了,连检查一下都懒得检查。
现在就处于一种被迫吃翔的状态里,只能期盼着 trellis 修好 codex 支持,让 codex 也能作为一等公民,有完整的 subagent 体验。
不说了和 opencode 搏斗去了~
- Dark_iaji2026-07-31
- Dumail2026-07-31
不过相对于linux上其他的cli,还是更喜欢opencode好看的tui(内存管够)
- 卡哇伊-linuxdo2026-07-31
听你说这么多,我就想说,永久免费的key,还公开密钥,不知道救了我多少次,他哪怕就是一坨,哪怕我不用,我的nas上也有他的位置
- Oliveira-linuxdo2026-07-31
- CNJK492026-08-01