- 岚2026-08-04
事先声明:Deepseek 用的是Opencode Go的 且所有测试均在windows Terminal上进行单次实验,可能存在严重误差,并且每个人设置不同,测试内容不同也会导致测试结果完全不同.omp2是认为omp存在问题的重试.同时,cc等几乎是原配置,所以测出来可能并不好看,详情可见各个Harness的插件或设置
提示词
开发一个“项目任务管理与实时统计看板”的全栈应用。不要询问我任何技术选型细节,全部按你的最佳实践直接生成代码。
一、功能需求(业务逻辑)
- 用户认证:实现注册与登录,使用 JWT 管理会话。用户角色区分
admin和member,未登录无法查看任何内容。- 任务 CRUD:
- 创建:标题、描述、优先级(P0/P1/P2)、指派人(选择已注册用户)、截止日期。
- 更新:支持修改所有字段。
- 状态流转:任务状态为
待处理 -> 进行中 -> 已完成 -> 已验收,不允许跳跃(例如不能从待处理直接跳到已验收)。- 删除:仅管理员可删除任务。
- 统计看板(核心难点):
- 提供看板 API,一次性返回以下三个聚合数据:
- 个人画像:当前登录用户负责的所有任务按状态分组计数。
- 团队负载:按“指派人”维度统计未完成任务(待处理+进行中)的数量与占比(百分比)。
- 趋势:近 7 天(含今天)每天的新增任务数量(若某天无新增,应返回 0)。
- 前端页面需将上述三个数据分别用表格、柱状图(CSS 绘制即可,不强制引入图表库)、折线图清晰展示。
- 并发防护(并发修 Bug 类难点):
- 更新任务接口必须实现乐观锁。数据库表中需包含
version字段。- 当并发更新同一任务时,若提交的
version与数据库不一致,必须返回 HTTP 409 错误码及提示“数据已被他人修改,请刷新重试”。- 异步审计:每次任务的创建和状态变更,必须使用 FastAPI 的
BackgroundTasks异步记录一条操作日志到数据库task_logs表(包含操作人、时间、旧状态、新状态)。二、技术约束(工程化)
- 后端:FastAPI + Pydantic v2 +
aiosqlite(异步 SQLite)。- 前端:React + Vite 构建工具(使用
npm create vite@latest标准模板),UI 使用 TailwindCSS 或干净的 Flexbox/Grid。- 启动:编写根目录下的
start.sh脚本,能够一键安装依赖、初始化数据库表结构,并分别启动后端(uvicorn)和前端开发服务器(npm run dev)。三、关键代码质量约束(严防 Harness 作弊)
- 统计看板的 SQL 查询:严禁在 Python 代码中先把所有数据查出来再循环计算(即内存计算),必须使用 SQL 的聚合函数(GROUP BY + COUNT) 在数据库层面完成统计。
- 数据库初始化:启动脚本中应包含自动建表逻辑(使用 SQLAlchemy Core 或原生
sqlite3均可)。- 跨域处理:请正确配置 FastAPI 的 CORS 中间件,允许前端
localhost:5173访问。请根据以上所有要求,直接生成完整的项目文件树和所有文件源码。
先说结论:Grok Build 时间与代码质量都领先
而类似pi,omp2,cursor这些由于大量的测试占据了大量时间,本身写代码时间并不长.
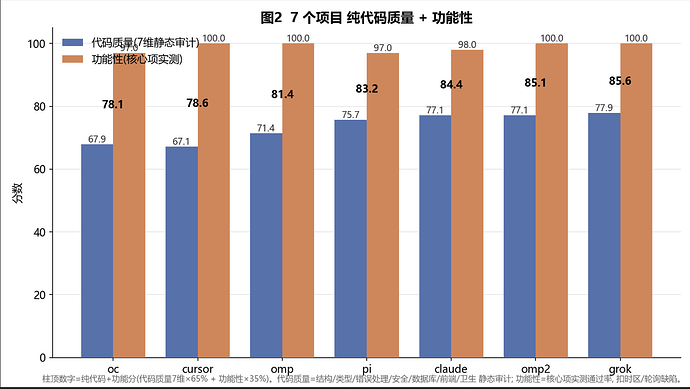
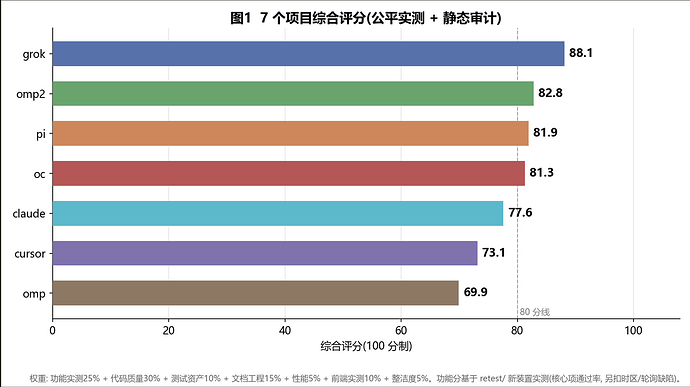
注意:图的上下文是对话框实时上下文,一般由插件显示,不代表总上下文
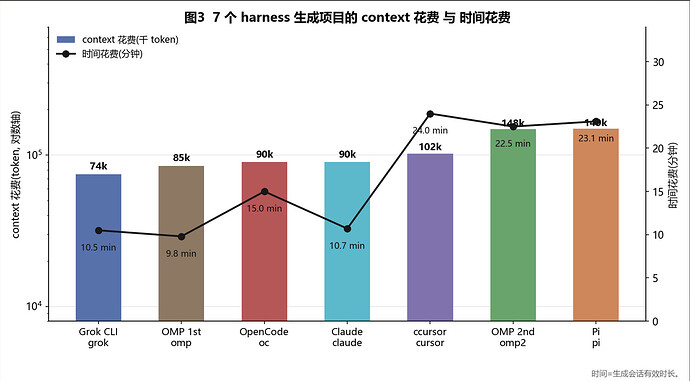
总上下文(由于未接入第三方网关统计,Grok被覆盖,OC,Cursor看不了)
CC:397.9k input, 70.9k output, 990.3k cache read, 0 cache write
PI:↑89k ↓103k R7.1M
OMP:↑30k ↓62k R1.5M
OMP2:↑58k ↓111k R10.8M完整的上下文
OMP:omp session
OMP2:omp session
OC:OpenCode
GROK,CLAUDE,CURSOR不知道咋搞
各个Harness的插件或设置
Grok原版仅基础设置/
omp原版仅基础设置/
omp2,重试omp1/
ClaudeCode几乎原版/
cursor用cursor++接入/
OpenCode @tarquinen/[[email protected]](https://feedbbs.com/cdn-cgi/l/email-protection) @franlol/[[email protected]](https://feedbbs.com/cdn-cgi/l/email-protection)/
Pi依据个人喜好大量改动(如图)
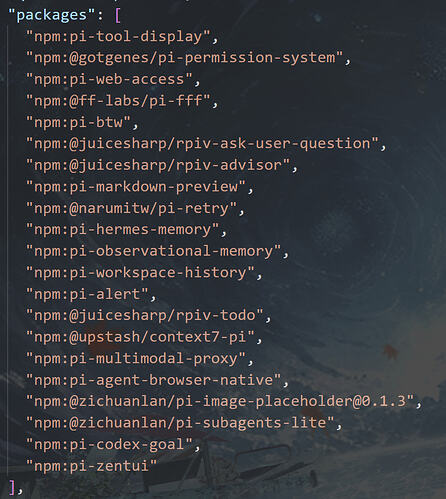
总结:在同一模型同一harness下的不同插件会导致误差
甚至同模型同harness下也会测出误差
真要看还是模型能力大于一切harness.
论开箱即用grok build保持了高水准
仅在全栈方面
前端我就不展示了,大差不差
主楼 - NeKo_fatcat2026-08-04
Grok Build 的话 提示词 真的很少 但是还是保持着 让ai使用 mcp 的频率大于 claude code , codex 之类的 (体感上
- 一2026-08-04
前不久我发了一个帖子说,建议在grok build里使用ds4f,虽说适配了codex,但是我体验了一下并不好用,grok build的内置提示词远远少于claude code,能够充分发挥出模型本身的能力,综合处理速度也是优于claude code
- chanyidong2026-08-04
harness作用有限么?还是要依赖底层使用的大模型?在考虑要不要更深入harness ^-^
- wilsons2026-08-04
非常有意义,马上换 build 试试
- wilsons2026-08-04
我觉得 Harness 的作用不是有限,而是很重要。如果没有 Agent,那么大模型它就没有办法获取本地文件和调用工具,所以它是必不可少的。而且一个好的 Harness 能更高效精确地为大模型找到它想要的关键信息,好的材料,精准内容,自然可以让大模型得出更高质量的结果。并且好的 Harness 还能引领大模型走正确的方向,防止误入歧途。
系统效果≈模型能力×上下文质量×工具与环境能力×执行控制×验证可靠性