本地部署大模型方案请教
2614
- 胖虎-linuxdo2026-08-10
小白求助,我想在公司一台电脑部署本地大模型并且使用cli,具体配置是双卡3090,512G内存,双CPU Xeon(R) Gold 6240R,主要用来写代码,请问目前最适合这套配置的部署什么开源模型,能使用Claude code或者codex吗,如何部署较佳
主楼 - soul09322026-08-10
- 落寞书生2026-08-10
个人使用的话,推荐llama.cpp,部署个ubuntu系统,qwen3.6 27b模型,开启sm tensor 和mtp,decode 速度应该能达到50t/s以上,也可以安装个deepseek-v4-flash-0731 ,速度可能比较慢,看你的内存通道数,我自己的2个魔改20gb 3080和8通道2666mhz ddr4大概decode 16t/s. code agent 可以使用opencode
- 同学,能吃一口你的泡面吗2026-08-10
正如一楼说的,关键信息 显存 你没说。
- 顾迪2026-08-10
部署Qwen3.6-35B-A3B-W8A8模型,我已经试过了,3090单卡24g可以部署起来,使用docker加vllm-openai。驱动版本为580.159.03
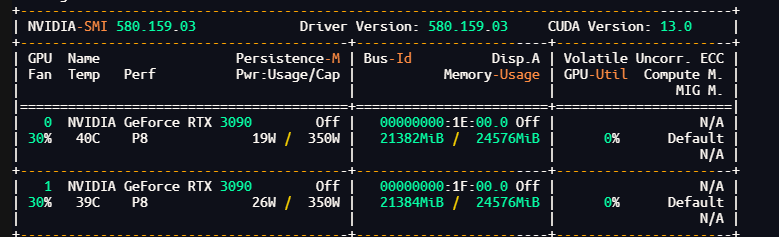
如果你想部署更强的模型建议升级显卡吧
- 人不能至少不应该2026-08-10
Qwen3.8-27B应该快来了,可以期待下
- Lemonade2026-08-10
vllm ,剩下教程问 GPT。但是两张 3090 估计够呛能部署能实际使用的
- 休息的风2026-08-10
性能感觉不如Deepseek。如果有隐私需求,就申请增加预算。小模型不行。
- PoliceBoy2026-08-10
双卡3090 显存不大,内存512g,可以考虑用llamacpp这种,速度上应该比vllm要快不少。
- 胖虎-linuxdo2026-08-10
单卡 24G,有没有nvlink我还需要看一下
- uglyBug2026-08-10
这个配置,本地部署的模型代码能力还是太弱吧,搞着玩行,生产力估计够呛。不如把512G内存咸鱼买了,把钱买coding plan ^-^
- 0ops2026-08-10
24g显存感觉有点吃力,可以先试试量化模型
- 胖虎-linuxdo2026-08-10
哈哈哈哈如果可以,我想把老板公司也给他卖掉
- kobe_zack2026-08-10
vllm、LMdeploy,这些都可以做部署,从huggingface上下载模型,没加速的话就用国内的ModelScope下载。具体能部署多大参数的得看你的显存,大概计算就是假设模型参数7B*fp16/8byte,大约最少就得14GB的内存,其他kvcache以及框架运行加载所需资源,7B的大概占用2GB,最少得16GB显存能运行起来7B的FP16的模型。
- Rainbovv2026-08-10
3090不支持nvlink,nvlink是需要有物理插槽的