- Axon2026-08-11
环境与版本
- 服务器:Ubuntu 22.04
- 显卡驱动:CUDA 13.3
- 依赖管理:uv
- 下载工具:
modelscope==1.39.1- 推理引擎:
lmsysorg/sglang:latest-cu130- 模型:
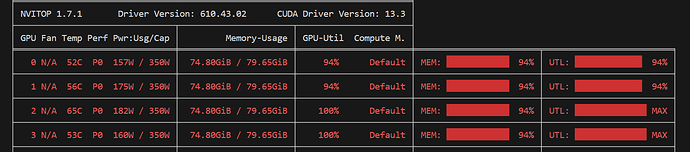
deepseek-ai/DeepSeek-V4-Flash-0731(48 个分片,约 156GB,混合精度)- 部署规模:4 张 H800(TP4)即可完整跑
1. 下载模型
使用 ModelScope 将模型下载到本地。大文件下载建议绕过本地代理,避免代理限制大文件并发导致极慢:```
env -u HTTP_PROXY -u HTTPS_PROXY -u http_proxy -u https_proxy \\
-u ALL_PROXY -u all_proxy \\
uv run --python 3.12 python -m modelscope download \\
deepseek-ai/DeepSeek-V4-Flash-0731 \\
--local-dir "$MODEL_DIR/DeepSeek-V4-Flash-0731" \\
--max-workers 4
``2. 拉取 SGLang 镜像``docker pull lmsysorg/sglang:latest-cu130
```3. 启动服务先清理可能存在的同名容器,避免冲突:```
docker stop -t 60 deepseek-v4-flash-0731 2>/dev/null
docker rm -f deepseek-v4-flash-0731 2>/dev/null
``启动容器,可以参照我这个启动命令(4 卡,端口 8000,建议先建立缓存目录$MODEL_DIR/sglang-cache):``mkdir -p "$MODEL_DIR/sglang-cache"
docker run -d \\
--name deepseek-v4-flash-0731 \\
--restart unless-stopped \\
--gpus '"device=0,1,2,3"' \\
--ipc=host \\
--shm-size=32g \\
--cap-add SYS_NICE \\
-p 8000:8000 \\
-v "$MODEL_DIR/DeepSeek-V4-Flash-0731":/model:ro \\
-v "$MODEL_DIR/sglang-cache":/root/.cache \\
-e SGLANG_DEFAULT_THINKING=true \\
-e SGLANG_DSV4_REASONING_EFFORT=high \\
-e SGLANG_ENABLE_UNIFIED_RADIX_TREE=1 \\
lmsysorg/sglang:latest-cu130 \\
sglang serve \\
--model-path /model \\
--served-model-name DeepSeek-V4-Flash-0731 \\
--trust-remote-code \\
--tp 4 \\
--moe-runner-backend marlin \\
--fp4-gemm-backend marlin \\
--speculative-algorithm DSPARK \\
--context-length 1048576 \\
--chunked-prefill-size 4096 \\
--swa-full-tokens-ratio 0.1 \\
--max-running-requests 4 \\
--mem-fraction-static 0.90 \\
--radix-eviction-policy lru \\
--enable-cache-report \\
--enable-metrics \\
--enable-hierarchical-cache \\
--hicache-ratio 2 \\
--hicache-write-policy write_through \\
--hicache-io-backend kernel \\
--hicache-mem-layout page_first \\
--reasoning-parser deepseek-v4 \\
--tool-call-parser deepseekv4 \\
--api-key sk-local \\
--host 0.0.0.0 \\
--port 8000
``首次启动需要十几分钟编译 CUDA Graph / DeepGEMM,看到以下日志即就绪:``Uvicorn running on http://0.0.0.0:8000
The server is fired up and ready to roll!
``4. 验证服务``列出模型
curl --noproxy '\*' http://127.0.0.1:8000/v1/models \\
-H "Authorization: Bearer sk-local"
对话测试
curl --noproxy '\*' http://127.0.0.1:8000/v1/chat/completions \\
-H "Authorization: Bearer sk-local" \\
-H "Content-Type: application/json" \\
-d '{
"model": "DeepSeek-V4-Flash-0731",
"messages": \[{"role": "user", "content": "你好,请介绍一下自己"}\],
"max_tokens": 512
}'
- H800/H100 属 Hopper,Marlin 是官方 W4A16 路径:`–moe-runner-backend marlin --fp4-gemm-backend marlin`。 - 默认开启高思考(DeepSeek 原生 `high`);如需 `max`,请求体传 `"reasoning": {"effort": "max"}\`。 实测速度 快的惊人,梁圣牛逼 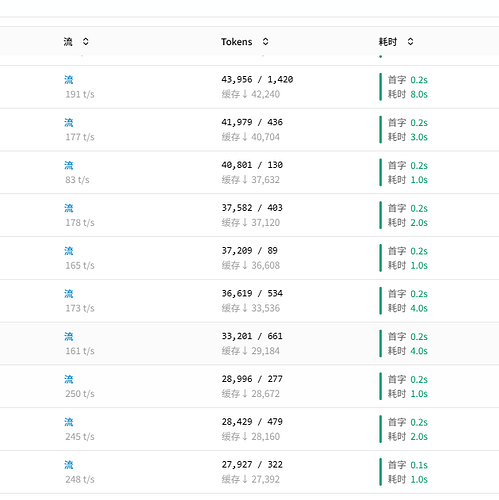主楼 - 白发苍2026-08-11
- Axon2026-08-11
- 蛋蛋2026-08-11
这个使用4张H100是不是也可以部署?请问这个是满血的,不是量化的吗?
- Axon2026-08-11
那肯定可以啊,满血的。DeepSeek 原生就是 fp4 和 fp8 混合精度的
- Axon2026-08-11
还有补充一下,这台服务器没有nvlink,如果有的话速度应该会再快一些。
- GPLer-linuxdo2026-08-11
看到佬的帖子瞅了眼 vLLM 和 SGLang 对 A100/A800 的支持,好像有一些相对靠谱的第三方版本了,下午试试 ^-^
- Axon2026-08-11
A800我也有,部署不了原生版本的,因为A系列显卡不支持FP4。你得下载INT4量化的
- GPLer-linuxdo2026-08-11
wtdcode/vllm-backport 这个 vLLM 分支好像可以,没说要下特殊格式的权重
Hakureirm/dsv4-on-ampere 这个 SGLang 分支提到了要 W4A16 重新量化