- yeyucca2026-08-11
背景信息:4张5090(单卡32G显存),用的是unsloth的dv4f_0731_UD_8_DXL gguf,162GB权重加上10.9GB的DSpark draft草稿模型,选的是q8_0的gguf。
为了开启deek v4 flash的thinking max(384k起步),上下文开到392K,我觉得有这个速度已经能用了。
优化心得:
1.显存吃不下大模型权重时,想着offload到cpu,这时需要有大内存支撑,比如128GB以上的内存,用好–n-cpu-moe参数
2.要熟悉对应模型的层数,适合gpu的重型的layer尽可能多的留给gpu,gpu毕竟适合这个,每张卡在调整时,显存尽量不要到适量程度,不能太空闲,又不能过于紧绷,预留2GB显存空间支撑burst,甚至为了更稳可以有3.5GB显存以支撑burst,
3.llama.cpp与先进模型是相辅相成,互相成长的,llama.cpp尽可能的追新,因为AI变化太快了,基本上出一款,就适配一款,先进框架在0day适配的也有,但通常需要时间适配,所以要留意大的Feature被合入的情况。
4.如果1:1:1去水平切分到多卡导致实际占用不充分时,就要结合当前模型的layer来手动划分合适的层次,这是个动态调协的过程,tuning performance,手艺人工作~
5.选对合适的Draft模型,刚好DeepSeek出了在Dflash上改进的DSpark先进草稿模型,如果用于编码,效果会更加明显
6.如果显存足够豪横,肯定都放到GPU一侧,如果达不到,又稍显富裕,可以调整ubatch-size到2048或者4096,加速prefill的速度。
7.如果公司和富人部署,建议两个GB10的DSpark(7w元以内的选择),如果有服务器(上卡)和机房(隔音且供电能跟上),那就两张6000pro,都是朴实无华的起飞方案,硬件真心建议5090系列起步,毕竟Blackwell的硬件nvfp4红利要吃到。nvfp4>fp8>fp16
心得就是AI时代适当保持技术敏感性,这个领域追新没有坏处,毕竟谁都不成熟,模型和框架两手抓,两手都要硬,同样的,适用于先进的harness,比如最近听说的Grok build就不错,后面试试。
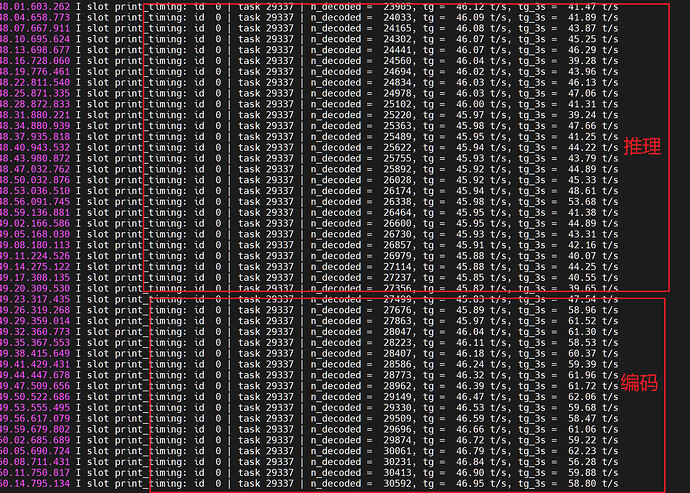
在草稿模式下,抓到了从推理到编码decode的速度爆发的过程,可以看到峰值可以干到60toks/s
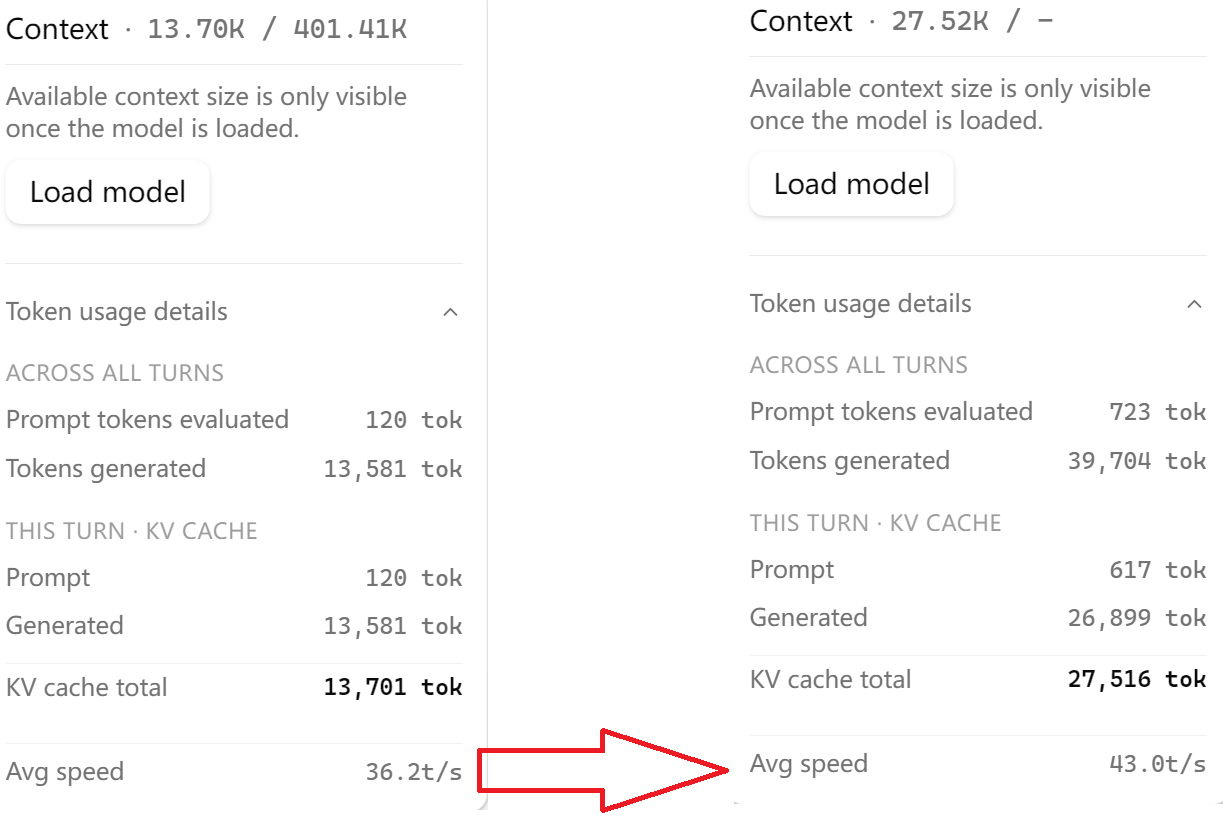
附上启动脚本,可以取自己需要的部分:
export CUDA_VISIBLE_DEVICES=${GPU_DEVICES} &&
export LLAMA_ATTN_ROT_DISABLE=1 &&
export LLAMA_ARG_FIT=${FIT_ARG} &&
“$LLAMA_SERVER_BIN”
-m “$MODEL_FILE”
${DSPARK_ARGS}
–alias “DeepSeek-V4-Flash-0731-UD-Q8_K_XL”
-c $CTX_SIZE
-ngl $NGL_LAYERS
–n-cpu-moe $N_CPU_MOE
–split-mode layer
${TS_ARG}
-ctk q8_0 -ctv q8_0
-fa on
–parallel 1
–ctx-checkpoints 0
–temp 1.0
–top-p 1.0
–min-p 0.01
–chat-template-kwargs ‘{“enable_thinking”:true,“reasoning_effort”:“max”}’
–host $SERVER_HOST --port $SERVER_PORT
2>&1 | tee “$LOG_FILE”"
LLAMA_ARG_TENSOR_SPLIT=‘19,7,8,9’ bash deploy_deepseek_v4_flash_q8.sh 0-1-2-3 16
主楼 - bake2026-08-11
最近公司有计划要本地部署一下v4给用,但是实际还是一头雾水
- yeyucca2026-08-11
想要省心,可以看看第7条,有劲儿,不折腾
- JeremyGE2026-08-11
- bake2026-08-11
- yeyucca2026-08-11
4090除非是那种魔改的,单卡48G显存,那4卡192G显存,理论上没啥问题,要是24G显存,还是太捉襟见肘,当然接受量化损失就可以部署更低比特的,或者上Qwen 3.8 27B,明天就发了,
理论上硬件其实还是要追新,毕竟blackwell这代开始nvfp4,4090想吃也吃不上
- 40老汉敲代码_@codex_reset2026-08-11
羡慕死我了, 算了 还是老实用官方的。。。。
- fcten2026-08-11
在家试了下 rtx pro 6000 + 4090 48g 部署 ds v4 flash,llama.cpp + UD_8_DXL + dspark,推理速度大概 30~40 token/s。也还算能用。估计主要还是 pcie 4.0 和 ddr4 内存的带宽拖了后腿,换成 3bit 版本应该能快很多。
只能指望 qwen3.8 出个 122b 的版本了,fp4 量化之后正好能塞进单张 pro 6000 里
- yeyucca2026-08-11
- bake2026-08-11
佬友的意思,是推荐上5090吗,确实相差也不到1万,也不知道领导咋想的说想上4090
- GlitterX2026-08-11
就喜欢看你们这些有实力的折腾 ^-^
- yeyucca2026-08-11
试试这个,刚出来的,97GB+1M上下文,TQ3_4S,如果起飞了,期待回音~
huggingface.co
YTan2000/R2-DeepSeek-V4-Flash-0731-TQ3_4S at main
We’re on a journey to advance and democratize artificial intelligence through open source and open science.
- yeyucca2026-08-11
看中的是底层的先进架构设计,这价差不止1w,有钱肯定是RTX 6000 pro啊,单卡96GB显存,我敲着键盘都流口水
- 小耿_伊2026-08-11
也是Q8版本在4个A40部署,只有20多toks/s,感觉好慢
- Aurora2026-08-11
没部署过大模型,有设备的情况下 推荐从哪里入门学习一下部署呢
- yeyucca2026-08-11
4*48,全能扛住啊,已经加了Dspark(记得要更新llama.cpp)了么,仅需增加10.9GB显存,你的也够了
- yeyucca2026-08-11
大模型的基本知识,底层硬件CPU,内存,GPU,NPU,磁盘IO等一些通识架构知识作为储备
准备Linux服务器,当然windows上可以加wsl,结合自己的显卡情况,A家/黄家(llama.cpp/SGlang/VLLM找个适合的框架),mac(MLX框架),从4B,9B,27B开始练手,当然取决于你的显存,找个vibe coding搭子跟你一起打怪,一定要自己动手上~
- 小耿_伊2026-08-11
是全部署在gpu,就是感觉有点慢,Dspark小模型也用了,llama.cpp用的是llama.cpp-server-cuda-b10276;可能是A40显卡太老了,不是很适合部署模型
- ensemble2026-08-11
毕竟是Ampere架构,吃不到fp8加速,在推理方面确实吃亏
- 小牛不算牛2026-08-11
在dgspark上面部署v4 flash竟然能跑到60这个速度么?之前评测说这个东西除了显存大效果很一般呢,要是v4能跑到这个速度6w买两台那非常有性价比了。
仔细一想,v4的token花掉6w也是得花到猴年马月才能花的完6w的token啊
