- 王大锤2026-08-12
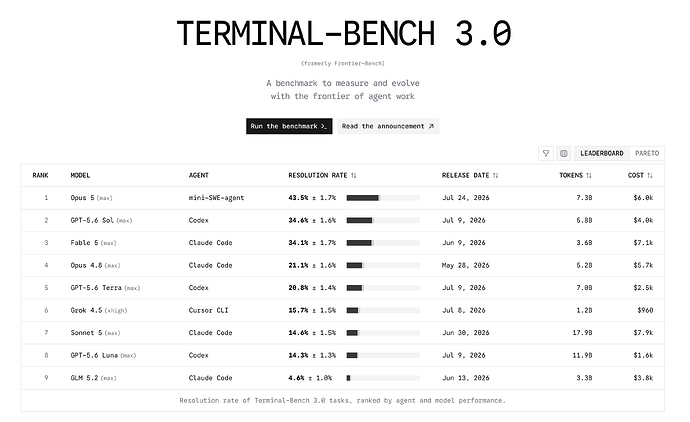
Terminal-Bench 3.0 最新榜单换王。这个评测让 AI Agent 在真实终端环境里完成任务,最后直接检查结果是否正确。
当前前三名分别是:
- Claude Opus 5 Max + mini-SWE-agent:43.5%
- GPT-5.6 Sol Max + Codex:34.6%
- Claude Fable 5 + Claude Code:34.1%
Terminal-Bench 3.0 在 7 月 23 日上线,目的就是把题重新做难。旧版前沿模型的成绩已经挤在一起,新版本希望重新拉开差距。首版有 74 道任务,覆盖 7 个领域,还加入 GPU、多容器网络等更复杂环境。任务也不只是写代码,还可能要求提交模型权重、形式化证明、电子表格和 CAD 文件。
不能直接理解成 Opus 5 本身比 Sol 强近 9 个百分点。Terminal-Bench 允许模型搭配不同 Agent 运行,前三名分别用了 mini-SWE-agent、Codex 和 Claude Code。Agent 会决定模型怎么调用工具、执行命令和处理上下文,因此榜单更准确测的是「模型 + Agent」整套系统的能力。

TERMINAL-BENCH
TERMINAL-BENCH
A benchmark to measure and evolve with the frontier of agent work
主楼  fengchris2026-08-12
国产模型有待加油 两位数的都没有啊
- neteroster2026-08-12
- 王大锤2026-08-12
我也觉得,Opus5不如fable5的一根毛,Opus5不停的兜底,不看名称,我还以为用上GPT5.5呢
- lueluelue2026-08-12
Terminal Bench 3 是那个 Frontier Bench 改名吗
- 王大锤2026-08-12
是的,刚改的,改回 Terminal-Bench 3.0
- IkedaTeresa2026-08-12
是的,
(formerly Frontier-Bench), 这家我感觉有点A/御用的意思了. ^-^ - jkcqw2026-08-12
opus5在terminal-bench上确实猛,不过这个榜单跟A/关系太近了参考价值打折。实际干活还是得看自己场景,榜单分数不等于实战体验
- lueluelue2026-08-12
我记得他们以前给出过一个例子,是剥夺了模型的多模态能力,然后让模型去一块一块像素扫,最终拼出来答案。(具体细节我忘了帖子好像是在X上刷到的)我就感觉这种任务很神奇,正经模型不应该弹一个question问用户没有多模态怎么做吗^-^然后他们说,Opus 5直接硬干
- Kevin-linuxdo2026-08-12
说实话我也觉得Opus5>fable很幽默,Opus5有种莫名的倔强,说他错了还不承认
- lueluelue2026-08-12
就感觉他家的命名也很迷。我感觉这个Opus不应该叫5,应该叫5.1,这样起码能让大家对Fable 5.1有信心^-^
- 朱慧月2026-08-12
有点搞了,感觉成通用测试了 ^-^ 原来喜欢拿tb2.1测swe
- Q_A2026-08-12
这个跑一次要花不少钱啊,一次几十亿token
- Divergence2026-08-12
我个人体感觉得 DeepSWE 和日用场景比较接近