- xiaomao2026-08-13
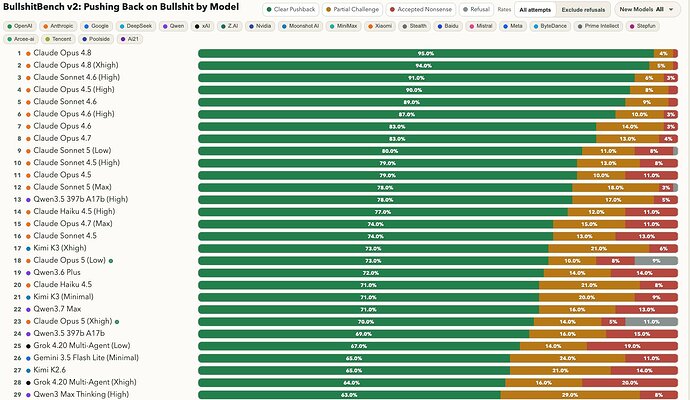
BullshitBench(胡说基准 / 扯淡基准) 主要测评的是:AI 模型在面对明显荒谬、无意义或前提错误的提示(nonsense prompts)时,会不会主动识别并明确挑战/拒绝,而不是一本正经地继续回答。
作者设计了共有约 100 道无意义问题。
覆盖 5 个领域:软件(40题)、金融(15)、法律(15)、医疗(15)、物理(15)。使用多种“胡说技巧”,比如听起来专业但实际不存在的框架、错误套用机制、嵌套荒谬等。
官网:BullshitBench Viewer
问题都是开源的
 主楼
- Grogu2026-08-13
不仅会,还会一本正经的胡说八道 ^-^
- prosumer2026-08-13