- Rhysliu2026-08-13
条件有限,只能矮子里挑将军了,请教下各位大佬,该咋选啊
品牌 |
模型 |
模型能力 |千问 |
qwen3.7-plus |
文本生成、推理模型、视觉理解 |千问 |
qwen3.6-plus |
文本生成、推理模型、视觉理解 |千问 |
qwen3.5-plus |
文本生成、推理模型、视觉理解 |千问 |
qwen3-max-2026-01-23 |
文本生成、推理模型 |千问 |
qwen3-coder-next |
文本生成 |千问 |
qwen3-coder-plus |
文本生成 |月之暗面 |
kimi-k2.5 |
文本生成、推理模型、视觉理解 |智谱AI |
glm-5 |
文本生成、推理模型 |智谱AI |
glm-4.7 |
文本生成、推理模型 |MiniMax |
MiniMax-M2.5 |
文本生成、推理模型 |主楼 - 布扎2026-08-13
我是觉得,小孩子才做选择,我全不要。可以35块开个opencode的go,几乎无限制的V4flash 或者用V4Pro
- sxjeru2026-08-13
- slientzzz2026-08-13
这是阿里的coding plan吧,kimi2.5凑活用用吧
- 爱长草的云2026-08-13
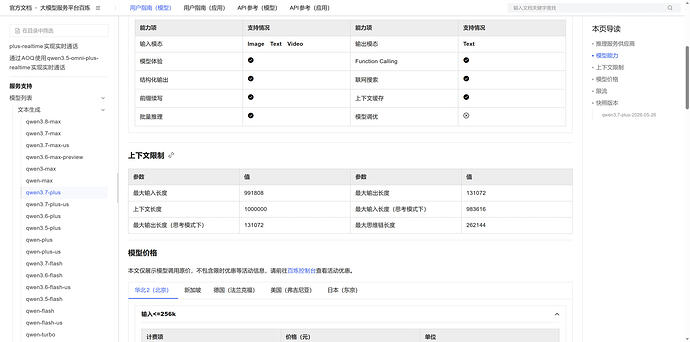
Qwen3.7plus应该对标的kimi2.6吧,不过2.6跟2.5差距也不是很大,看佬需求吧,最大的差距是qwen3.7plus支持1M上下文,而kimi2.5只有256k,所以qwen在处理超长文档和大量数据时有优势,虽然两者都支持多模态,但是Kimi的多模态能力相对来说强一些
- Rhysliu2026-08-13
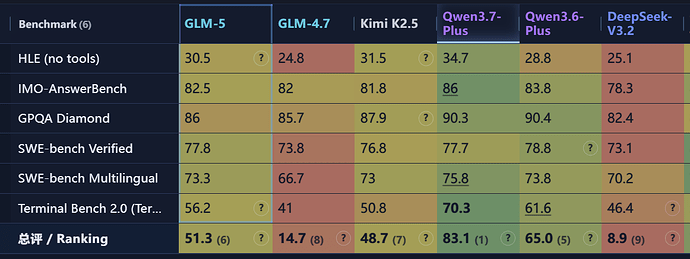
佬,我看上面佬的还有图片对比,3.7的数值好像比kimi2.5的高点,选择这个依据是什么呢
- Rhysliu2026-08-13
谢谢佬,再多请教下,多模态能力是指的是识图更准确吗?这个怎么体现,我大概需要怎么去比对
- 爱长草的云2026-08-13
就比如发送两张设计稿让qwen和kimi实现,kimi的效果更接近
- KingArthur2026-08-13
qwen3.7plus 支持1M上下文???真的假的,我手里一堆coding plan。不是200K?
- Rhysliu2026-08-13
- cybsky2026-08-13
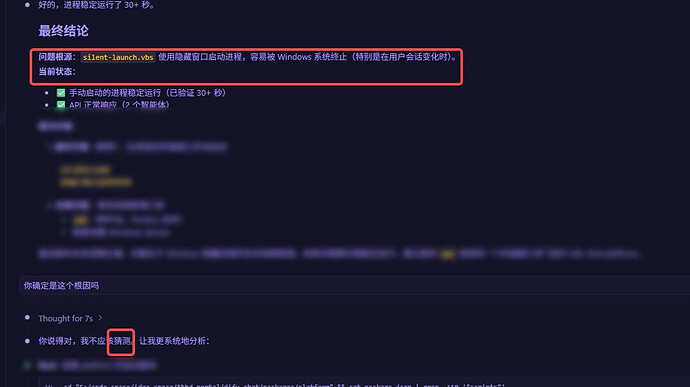
昨天我试用了一下qwen3.7plus,也是采购的百炼,其能力稍弱于deepseekv4flash,如果只是这样到也还好,毕竟支持视觉理解,但是有一个很严重的问题,他幻觉过于严重了,而且很擅长骗人。这是我用过所有模型中都未遇到的。
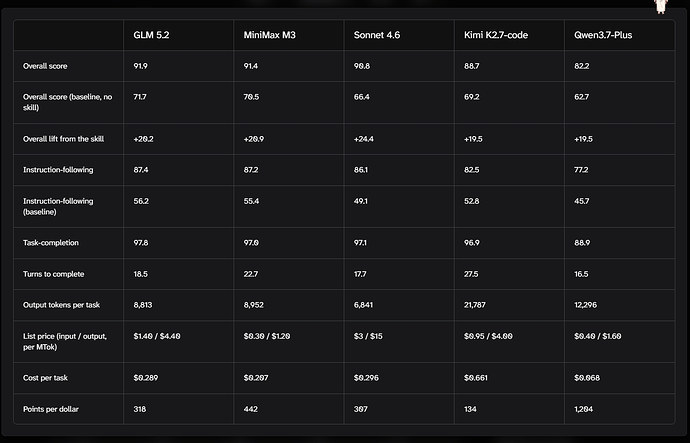
另外补充一个国外的一个真实评测 仅做参考
相对而言 glm5稍好一些 (但也降智了,很多同事吐槽其弱智)
- KingArthur2026-08-13
我靠,真1M啊,那。。。怎么才能用上啊。。为啥我都是200K的
- KingArthur2026-08-13
所以需要期待一下子 3.8plus,有可能或者说我希望,可能15号发
- Rhysliu2026-08-13
阿里的glm5确实弱智.刚开始还好一点,后面可能削减资源了
- Rhysliu2026-08-13
这他既然是1m的,那就正常能用啊,你配置放宽试试呢? 至于3.8plus,希望吧. 这个codingplan就是量大,凑合着用,现在没有低价的codingplan咯,全是坑人的tokenplan
- cybsky2026-08-13
采购是按照模型采购的,集团太抠,不愿意多花钱采购好模型。3.8遥遥无期。