- gaoxiangyang2026-08-13
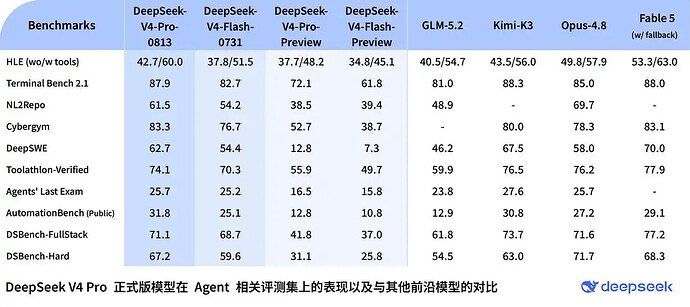
从目前官方公布的信息来看,DeepSeek V4 Pro支持1M上下文长度,最大输出长度达到384K Token,同时支持非思考模式和思考模式,其中思考模式默认开启。
根据DeepSeek官方公布的评测结果,DeepSeek V4 Pro正式版模型在HLE、Terminal Bench、Cybergym、DeepSWE等Agent能力超过Anthropic的Claude Opus 4.8,逼近Anthropic 6月发布的模型Fable 5,甚至有些榜单实现反超。
主楼 - FFFFFFFFFir2026-08-13
有点不懂这些榜单benchmark具体针对的任务类型,像mc游戏mod的应该算java后端吧,这应该看哪个benchmark呢
- jolyne2026-08-13
(帖子已被作者删除)
- GloryDuck2026-08-13
简单来说 Deep swe 是最有价值的。代表的是能够长程处理一个复杂项目的能力
- yxbj2026-08-13
- jolyne2026-08-13
(帖子已被作者删除)
- junhua2026-08-13
这么牛逼吗,这么看flash还是很值的
- yxbj2026-08-13
- yxbj2026-08-13
- 牗空2026-08-13
嘿嘿嘿,哥们儿,话里带刺的是你,别倒打一耙^-^,这里不是抖海,不兴你急了这一套,反手炼化
- yxbj2026-08-13
我回复的是你发的第一个回复“感觉榜单越来越离谱了,以前还是接近现在直接是超越了”
这个回复提到qwen或者百度的模型了么?
你到刚才才回复引用你真正要回复的内容,请问别人怎么知道?
大模型对话至少也要有上下文吧?
- gaoxiangyang2026-08-13
各位别争论了,都没有恶意,都冷静冷静,不要么这激动嘛!不就是新模型发布了吗,新品发布,总会带些夸大的宣传,雷布斯连个五菱上的门把手都能吹上几分钟,没必要这么较真了,好用不好用,自己测试测试就行了。
- kiki2026-08-13
官方都没有发布吧?现在都是自媒体带节奏。
- jolyne2026-08-13
(帖子已被作者删除)
- gaoxiangyang2026-08-13
也不全是自媒体了,新浪,百度,还有it之家这些媒体上都报道了,感觉官宣也不远了
 江雪何年初映人2026-08-13
人家的意思是从以前的其它模型一直到现在,你理解错了。而且榜单这东西不都是图一乐吗,真正上手有效果才是最重要的
- yxbj2026-08-13
- saberNighr2026-08-13
v4 pro开源吗?如果开源的话,梁圣我每天睡觉前给你供个神像拜一拜
- 觉浅2026-08-13
效果有些差强人意了,感觉其实是灰度,不然官网怎么只改文案不发文,公众号也不发
- yxbj2026-08-13
我说的很清楚,我回复的是他的第一句回复“感觉榜单越来越离谱了,以前还是接近现在直接是超越了”
这句话没有任何其他引用,我认为他的意图是指榜单造假,所以我反问了一下。
他后来的解释是,他说的不是deepseek,说的是qwen,baidu。问题是他前面的话根本没提到这两个模型,别人怎么知道?
你要说我语气有问题,可以,没问题
那请问他回复我的“你自己没有手吗,不知道搜一下?”这句话带不带刺啊。该不该炼化啊?