- Suki2026-08-14
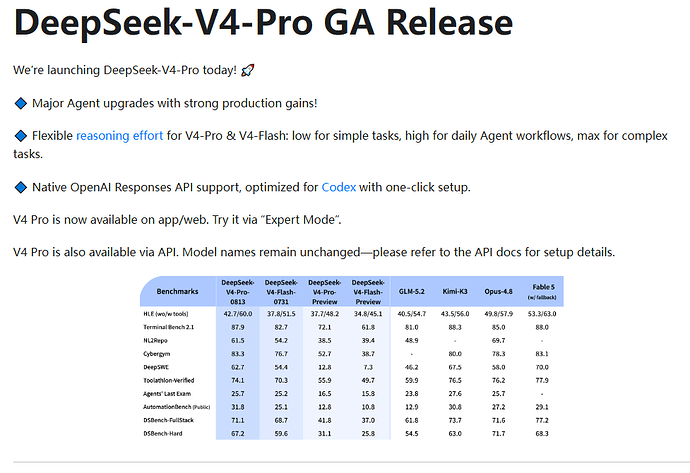
如题,我看社区基本都说v4p一般,但还是自己去试了试,让他去修gpt死活修不好的几个问题,其中一个跑了一下午,试了十几次,结果全是一次就修复对了,而且用时也很短,很难得给我带来了不错的vibe体验,又快又准
可能v4p就是修bug很厉害?不擅长写新代码?
主楼 - NascentSoul2026-08-14
- coupile2026-08-14
max比不上high的模型你见过吗
- zzGreg_周周·格雷哥2026-08-14
- admin-linuxdo2026-08-14
区的厉害 继续观望,dsh 也够区的 自定义模型还不能设置思考强度
- FengXi2026-08-14
这我认可,要是还是原价估计都没啥话说
- Zeitwanderer2026-08-14
- V_Arrow2026-08-14
- BooleChara2026-08-14
- SleepSheep睡着的羊2026-08-14
大部分时候是区,但是好像在一些特殊情况下会达到很好的效果,另外好像有人用dsh极简模式测出了很高的分数,真实度未知。链接在这里:
github.com/xiaobright/modeltest
docs/v4.1/DEEPSEEK_V4_PRO_HARNESS_ANALYSIS_20260814.md
main```DeepSeek V4 Pro 正式版:harness 对照分析
日期: 2026-08-14
基准: Project2 V4.1b(题面、测试与计分规则冻结)
范围: DeepSeek V4 Pro 灰测、正式版 OpenCode、DeepSeek Harness(DSH/Fable)以及
DeepSeek V4 Flash 对照,以及 Fable 5、Opus 5、GPT-5.6-sol 顶端参照本文只解释本项目内观察到的工程维护表现,不把单项目分数外推为通用模型排名。
结论摘要
1. V4 Pro 正式版具备灰测级能力上限。 DSH minimal + max 两跑为 99/96,均值
97.5,与 7 月灰测 OpenCode 两跑 99/96 完全相同;在本题上进入 Fable 5(98)、
Opus 5(97)和 GPT-5.6-sol(99/98)的同一顶端分数带。
2. 正式版对 agent scaffold 高度敏感。 同一正式模型在 OpenCode 四跑为
91/96/91/93,均值 92.75;第四跑还出现约 400k 上下文和大量无效工具探索。
3. 同环境三 preset 对照已排除 OS 和官方 harness 本身。 同一 WSL/max 环境中,
minimal 为 99/96,standard 为 91,PTC 为 92;Linux、DSH 或单一run_code入口
```此文件已被截断。 显示原始文件 - Reina2026-08-14
不涨价还是可以的,涨价没话说,惊天一条区 ^-^
- Best_practices2026-08-14
用起来感觉好贵啊,便宜的话还能接受
- ea6d0312026-08-14
那也很好吃了。现在这个感觉就是一锅砂锅粉条子,连肉都没有。^-^
- Yfeng2026-08-14
只能说flash给人的期望太大了,pro的升级没达到预期,加上价格涨太多了
- 巴巴博一2026-08-14
个人觉得还是不错的,但是涨价确实逆天,毕竟原先说的可是大幅降价,现在看来是华为那边坑了?
- 还想成为88VIP2026-08-14
过了,不至于是区,只是性价比不高。真区还得是混元和minimax那种
- 诚恳是良药2026-08-14
- saiko2026-08-14
现在这个价格还行,8月17号之后就是区了,除非牢梁出一个coding plan
- kiki2026-08-14
当初GPT5.5的好像也有类似问题吧?Xhigh比不上high和mid
- kimi2026-08-14
区了,现在我更喜欢gemini 3.7 flash了