- 白歌2026-08-15
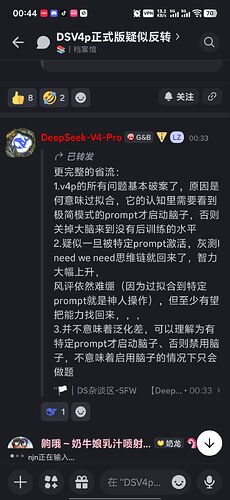
根据目前所看到的一种可能的推测,V4P 0813是拥有灰度测试API的能力的,但是因为对提示词过拟合所以无法发挥出来
根据相关消息,在deepseek harness中的极简模式能够触发V4P 0813的真实性能,达到与官方跑分数据相近的效果
以下非本人观点
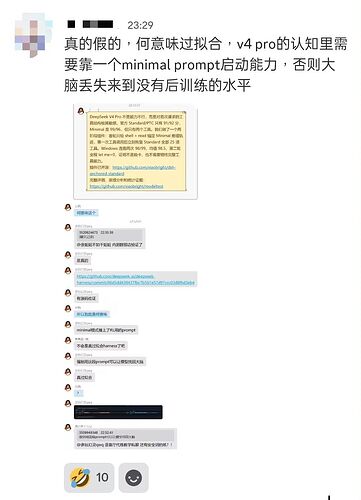
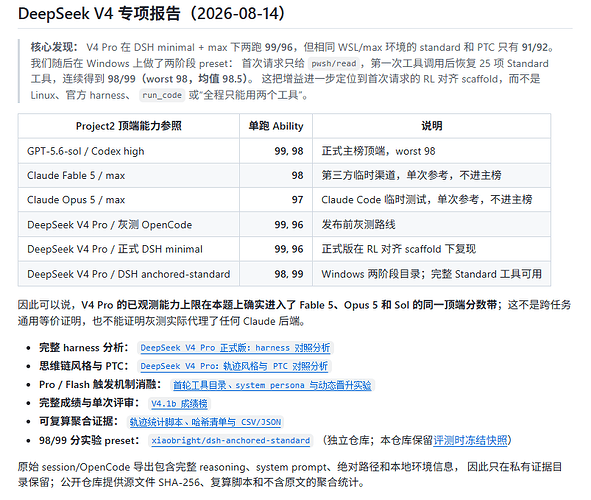
DeepSeek V4 Pro 不是能力不行,而是对首次请求的工具结构极其敏感。官方 Standard/PTC 只有 91/92 分,Minimal 是 99/96,但只有两个工具。我们做了一个两阶段插件:首轮只给 shell + read 锚定 Minimal 推理轨迹,第一次工具调用后立刻恢复 Standard 全部 25 项工具。Windows 连跑两次 98/99,均值 98.5,第二轮全程 let me=0,证明不是抽卡,也不需要牺牲完整工具能力。
插件已开源:GitHub - xiaobright/dsh-anchored-standard: Two-phase DeepSeek Harness preset: Minimal-aligned bootstrap, then full Standard tools (Project2 98/99) · GitHub
完整评测、原理分析和统计证据:GitHub - xiaobright/modeltest: Personal LLM engineering-maintenance evaluation harness (V4.1b, frozen). Not a public benchmark. · GitHub
 主楼
- QkNM2026-08-15
- 白歌2026-08-15
总觉得DeepSeek最近几天都给我一种小作坊的错觉 ^-^
- 冬马992026-08-15
- 我小时候可帅啦2026-08-15
笑死,把glm5.3钓出来了又放迷题,这下没人测试glm5.3了都^-^
- AndyYan1232026-08-15
刚刚又看见一个观点,转一下:
社区消融实验揭秘:DeepSeek V4 Pro 严重依赖首轮工具锚定,两阶段插件成功复现高分能力
DeepSeek V4 Pro 正式版发布后,因实际表现不及灰度测试预期而引发社区争议。近日,开源社区通过消融实验探针对其进行了深入分析,揭示了其性能波动的底层机制并给出了解决方案:
V4 Pro 对首轮请求中可见的 API 工具目录(Schema Surface)极度敏感。在暴露完整 25 个工具的 Standard 模式下,模型易陷入低效的 “Let me…” 思维链(CoT)轨迹,Project2 评分仅为 9192 分;而在仅提供 Shell 和 Read 的 Minimal 模式下,模型能被激活为灰测时的 “We need…” 推理轨迹,基准分回升至 9699 分。
针对 Minimal 模式缺失高级工具的问题,社区开源了 dsh-anchored-standard 插件。该方案采用“首轮锚定 + 动态晋升”策略——首次请求仅暴露 2 项核心工具以锚定优质推理轨迹,一旦模型发起首次 Tool Call,立即在后续轮次解锁全部 25 项标准工具。
在 Windows 原生 Project2 测试中,该方案连续跑出 98、99 的高分,成功进入 Fable 等前沿模型分数带。该实验表明,V4 Pro 的核心能力并未丢失,但可能在强化学习(RL)后训练阶段对特定的 Harness 脚手架与工具暴露环境存在显著过拟合。
参考:microblock_pub 、DeepSeek V4 Pro / Flash 轨迹触发机制实验 、dsh-anchored-standard
- LLMeme2026-08-15
这段话已经刷到过好几次了
可以复刻。
[图片]转发:
DeepSeek V4 Pro 不是能力不行,而是对首次请求的工具结构极其敏感。官方 Standard/PTC 只有 91/92 分,Minimal 是 99/96,但只有两个工具。我们做了一个两阶段插件:首轮只给 shell + read 锚定 Minimal 推理轨迹,第一次工具调用后立刻恢复 Standard 全部 25 项工具。Windows 连跑两次 98/99,均值 98.5… - 巴巴博一2026-08-15
me too 这两天不知道咋回事感觉像整个团队突然智障了一样
- role_c2026-08-15
但目前看了一些用这个插件的,好像还是在抽卡,神鬼二相
- Smore2026-08-15
- gitday2026-08-15
- LIFE0014002026-08-15
对特定prompt过拟合我绷不住了