- ezios2026-05-20
本人手头有两张4060,一直很想跑稍大一些(相比9B 4B)的模型,基于最近llama.cpp支持的一些新功能运行35B A3B模型测试。
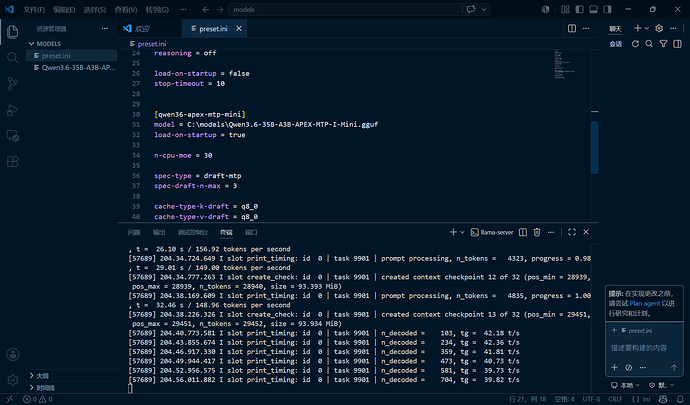
模型Qwen3.6 35B A3B APEX-MTP
Qwen3.6-35B-A3B-APEX-MTP-I-Mini.gguf -》13.7 GB
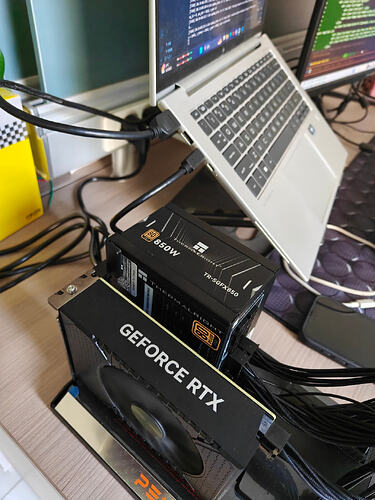
省流:
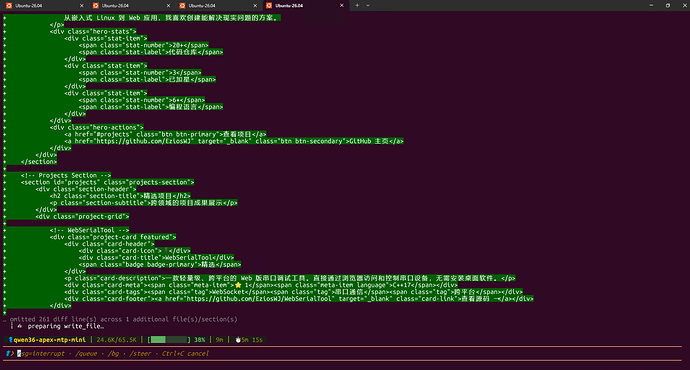
- 台式机和USB4拓展坞都可以跑在8g显存的显卡上,MTP的速度挺快的,30+tokens/s,代码能跑到45-50
- 因为显存不够,上下文prompt太多了以后处理起来很慢,拓展坞情况比我的台式机慢3-4倍
补充:
- 台式机后续尝试了I-Compact和I-Quality,发现速度有下降,但是不明显
- 4060还是玩9B吧…跑起来还快点,当然不嫌慢,等这个慢慢跑也行(我记得特总视频也提过这一点)
右键,新标签页打开查看。 ^-^
 主楼
- ezios2026-05-20
如果有进一步优化提升效率的办法,请各位大佬指点指点 ^-^
- muggle_e2026-05-20
- acai2026-05-20
3060 12G显存,很容易跑到40~52/t/s
- ezios2026-05-20
啊?下面只是总结,这个也会被举报吗?
- ezios2026-05-20
我看有个阿三的视频是用1060跑的,不过确实能行,moe不往gpu卸载,跑起来才4g..
- admini-linuxdo2026-05-20
我以为 4060 是 16GB ,2 张有 32 GB VRAM 呢。如果那样可以使用 vllm 部署。
- acai2026-05-20
是的,激活参数少,比9B的稠密模型快多了,最占显存的反而是预开辟的上下文
- ailelezhe2026-05-20
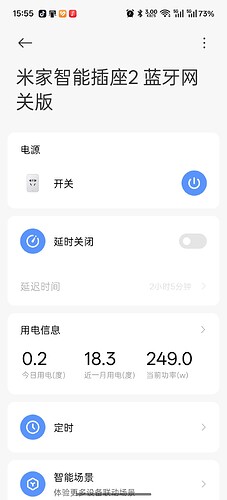
这样每天挂的电费不贵吗?大概一天能有多少电费?mac应该少点吧 我也挂下
- ezios2026-05-20
- su_po2026-05-20
可以再优化试试,老哥试试这个参数G:\llama.cpp\llama-b9222-bin-win-cuda-13.1-x64\llama-server.exe -m Carnice-Qwen3.6-MoE-35B-A3B-APEX-MTP-I-Mini.gguf --host 0.0.0.0 --port 8080 -ngl 999 --n-cpu-moe 36 --no-mmap --mlock --cache-type-k q8_0 --cache-type-v q8_0 -c 102400 -b 4096 -np 1 -t 12 -fa on
 冰冷的烤鸡翅2026-05-20
现在拓展坞已经没有性能损耗了吗?
- ezios2026-05-20
好的,我回去试试,你这个后面两个参数是干嘛用的
- ezios2026-05-20
有,总结里面写了,涉及到显存数据不够,需要去内存读的时候,就慢了,但是如果模型能完整的放在显存内,似乎没有任何区别
- LenGary2026-08-15