- DT2026-08-17
最近手里搞到一台DGX Spark,上周看见Qwen3.8-27B出来了就顺手部署了一个,一开始直接用vllm跑了一下,感觉性能太差,decode只有个位数,就用ds调了几天,现在感觉差不多了,拿出来给大家分享下配置,有更好方案的佬友也可以给点建议
1. 核心配置
- 镜像:
lmsysorg/sglang:qwen38-27b- 主模型: Qwen3.8-27B-NVFP4
- draft 模型: RadixArk/Qwen3.8-27B-DSpark
- 投机算法: DSPARK,block size 7
- KV cache: fp8_e4m3 · dtype: bfloat16 · 上下文: 262,144
- 注意力: flashinfer · prefill: chunked 8192
- 内存: mem-fraction 0.88
2. 测试结果
周末部署完成后又去找了几个官方测试用例,跑了一晚上,贴一下测试结果:
Workload |
请求数 |
Acceptance length |
输出 tokens |
Spec verify ct |
耗时 (s) |
吞吐 (tok/s) |HumanEval |
128 |
3.410 |
160,818 |
49,858 |
5,410 |
29.73 |GSM8K |
128 |
4.468 |
58,531 |
14,682 |
1,611 |
36.30 |MATH-500 |
128 |
4.105 |
109,152 |
30,530 |
3,323 |
32.85 |MBPP |
128 |
3.608 |
114,996 |
34,364 |
3,735 |
30.79 |MT-Bench |
128 |
3.165 |
114,089 |
41,035 |
4,454 |
25.61 |AIME 2025 |
128 |
3.308 |
242,796 |
76,575 |
8,288 |
29.30 |LBPP |
128 |
3.048 |
233,374 |
80,234 |
8,690 |
26.86 |Alpaca |
128 |
3.364 |
40,478 |
15,401 |
1,688 |
23.99 |AIME 2026 |
128 |
3.087 |
259,032 |
86,288 |
9,337 |
27.74 |合计 |
1,152 |
— |
1,333,266 |
428,967 |
46,536 |
— |受 DGX Spark 硬件 内存带宽 限制,似乎最高只能达到这个效果了
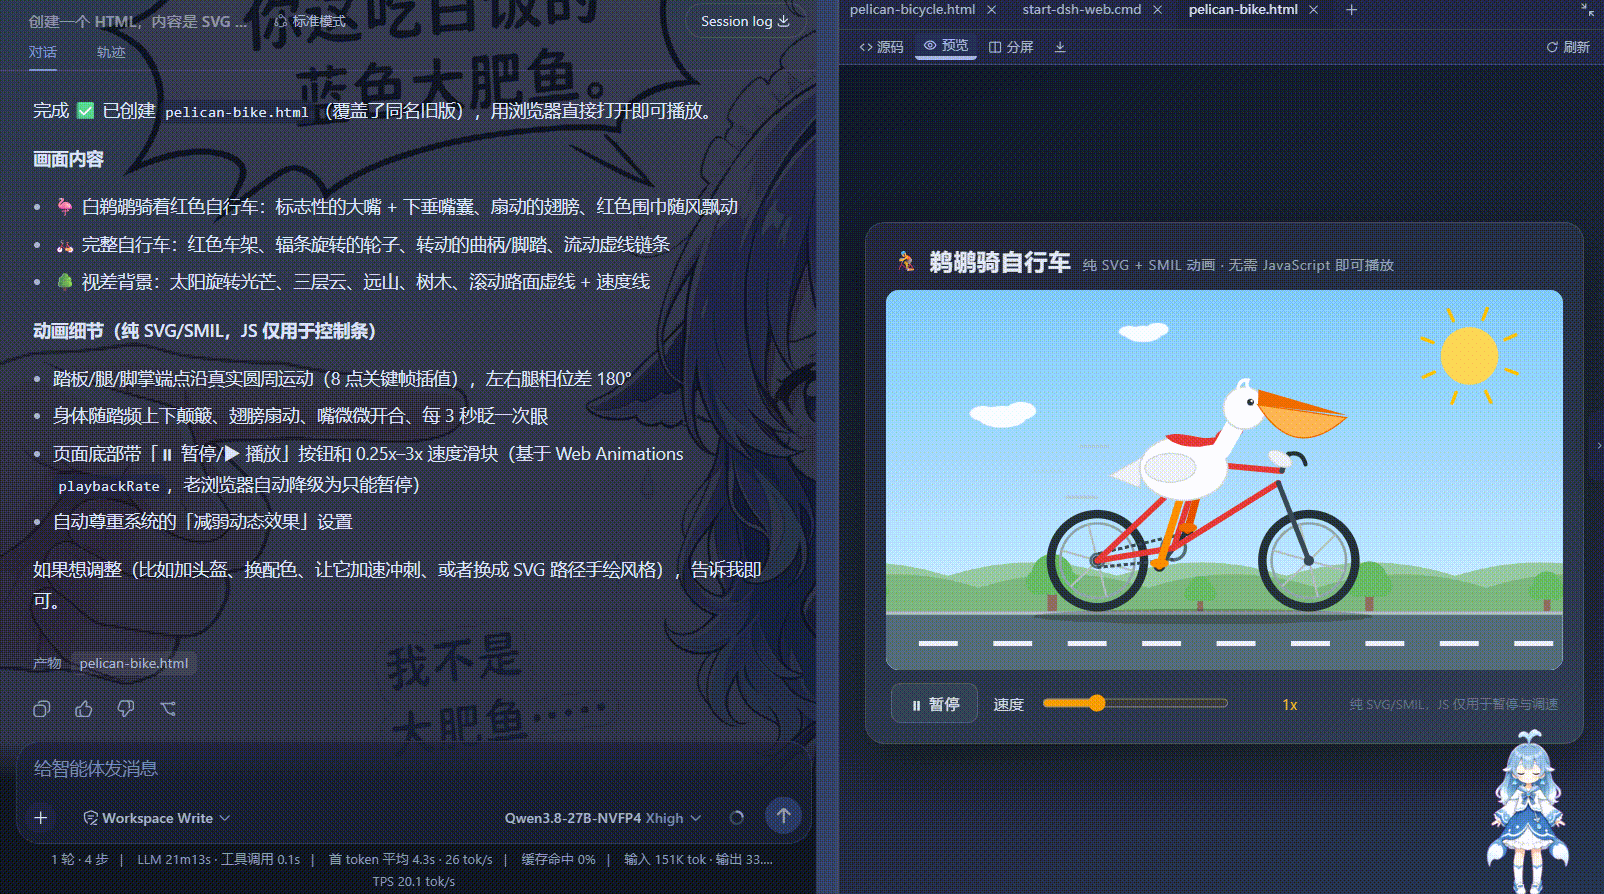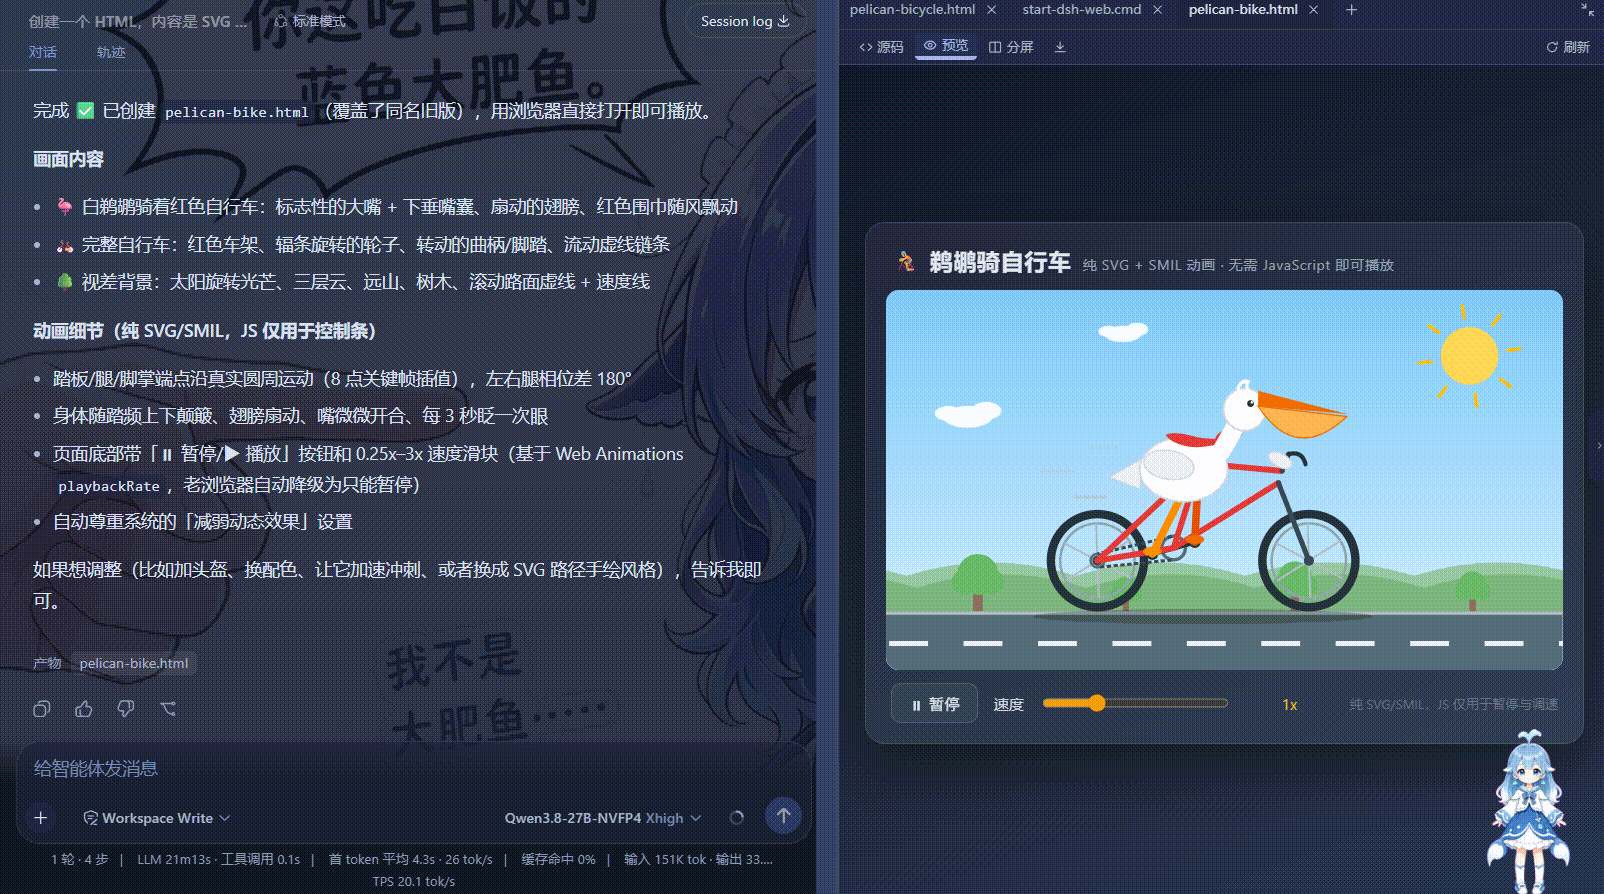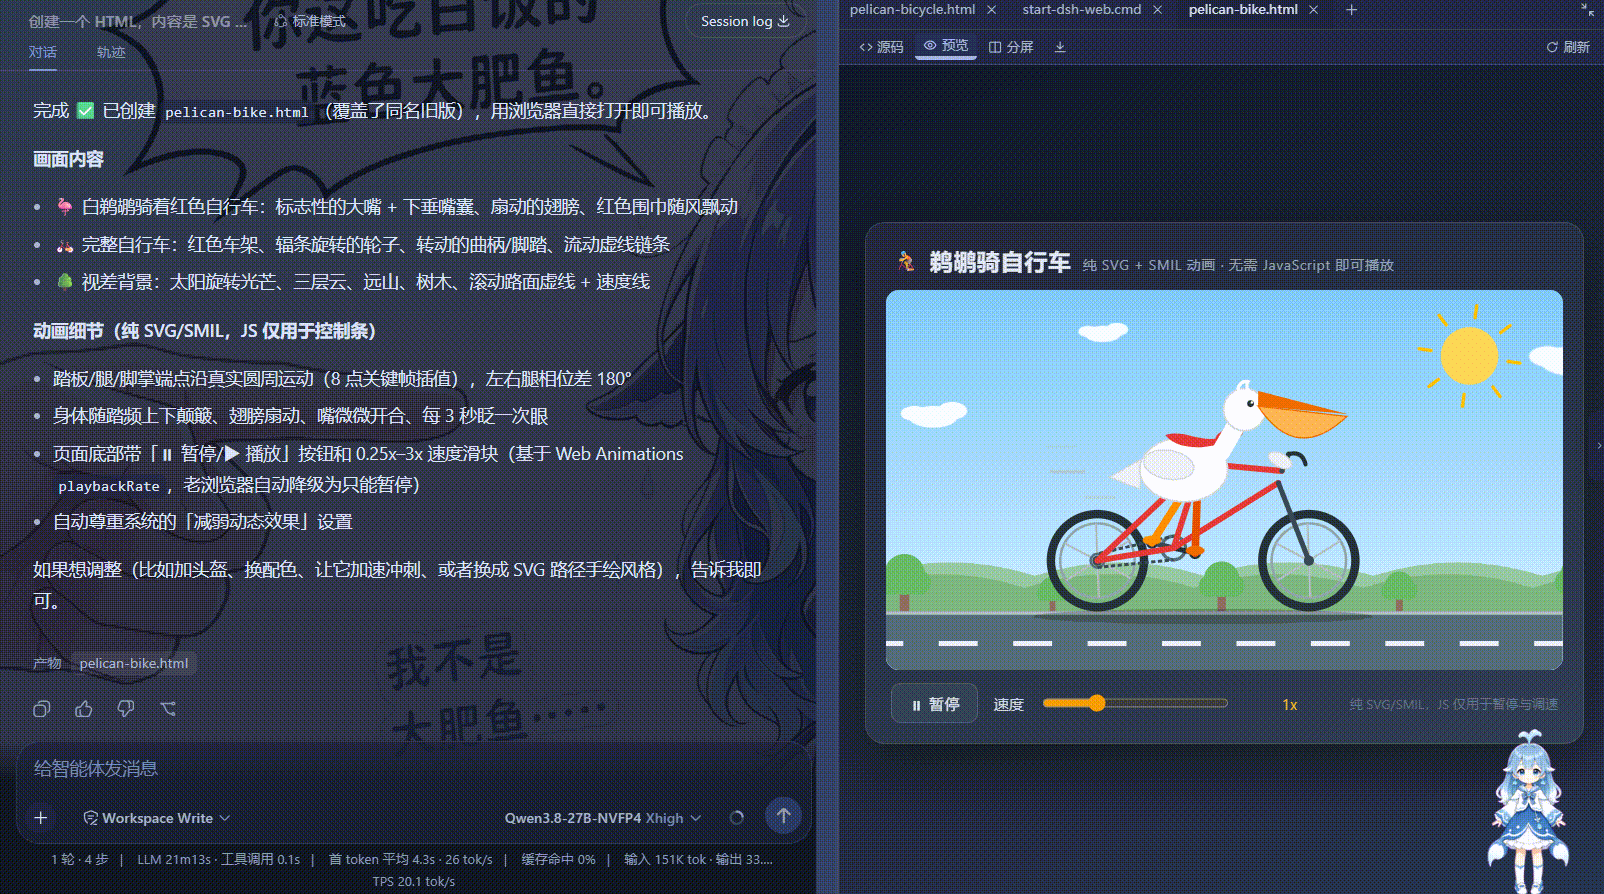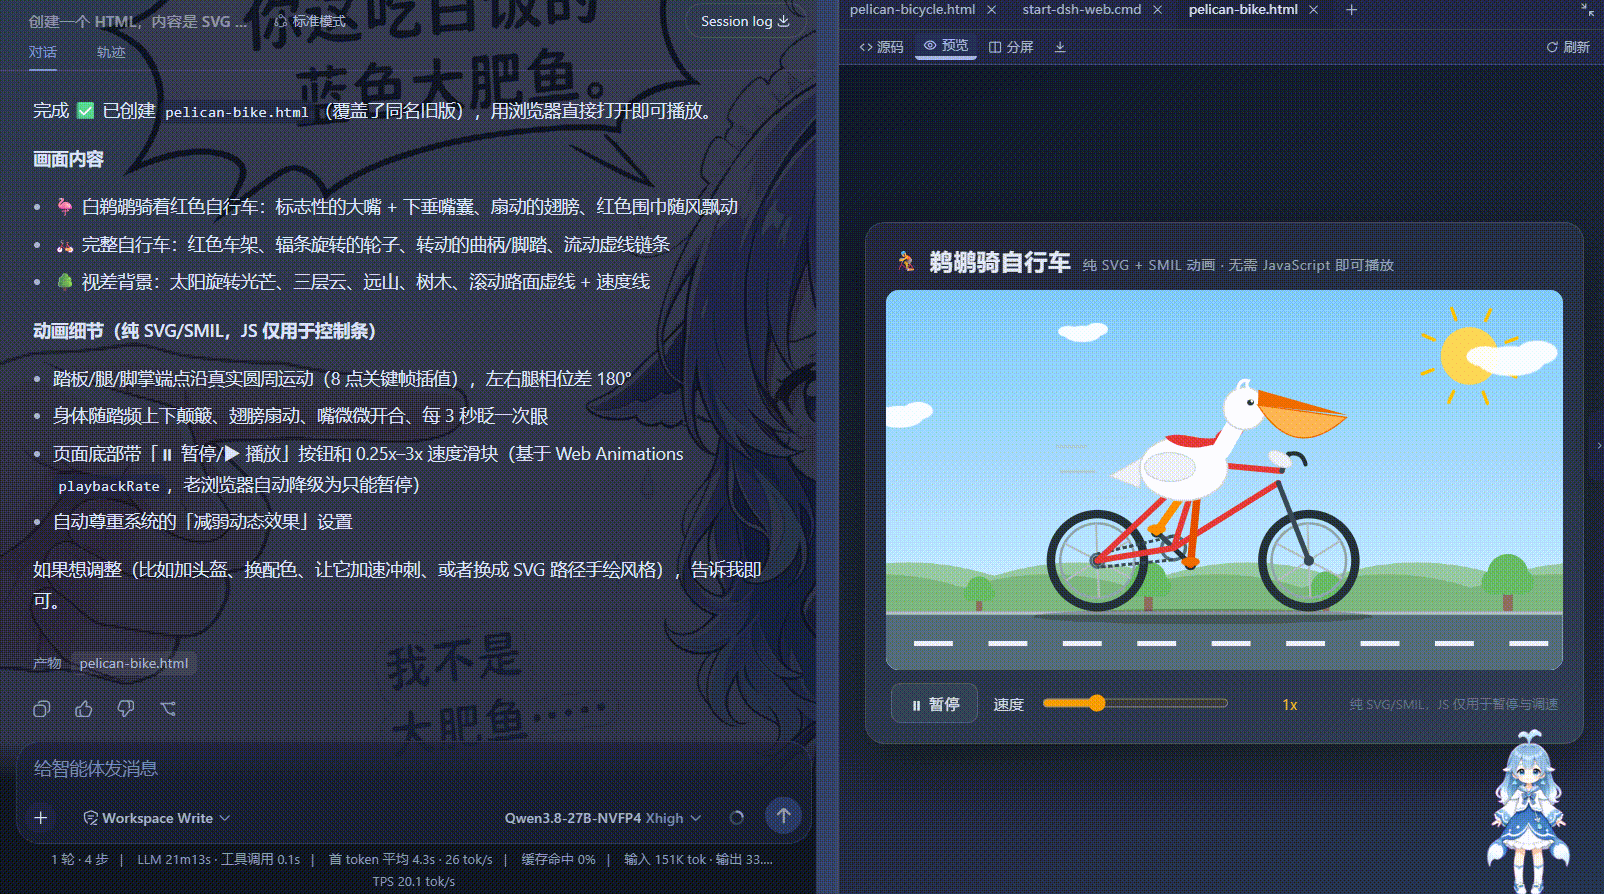
按照惯例跑一下鹈鹕:
3. 附件
最后附上完整启动脚本,有需要的佬友可自行尝试:
serve-qwen38-dspark.sh```
#!/usr/bin/env bash============================================================
Qwen3.8-27B-NVFP4 + DSpark 投机 单节点 DGX Spark (GB10/SM120) SGLang 启动脚本
依据: PR #34966 官方验证命令 (NVFP4 + DSpark) + SGLang cookbook GB10 适配
- SM120 native FP4 runner (不需要 --fp4-gemm-backend marlin, 那是 SM89 用的)
- KV cache 用 fp8_e4m3 减半 (官方验证命令), 否则 bf16 KV 50GB 会爆内存
- --mamba-ssm-dtype bfloat16 减半 Mamba state
- --mem-fraction-static 0.88 (官方验证命令, 之前 0.95 是爆内存主因之一)
============================================================
set -euo pipefail
MODEL_DIR=${MODEL_DIR:-/data/models/Qwen3.8-27B-NVFP4}
DRAFT_DIR=${DRAFT_DIR:-/data/models/Qwen3.8-27B-DSpark}
IMAGE=lmsysorg/sglang:qwen38-27b
NAME=sglang-qwen38
PORT=8000 # 统一 8000 端口 (与旧 vLLM 接入一致)DSpark 投机 (PR #34966 官方验证命令参数, 减去镜像不支持的 --speculative-draft-kv-cache-dtype)
SPEC_ARGS="--speculative-algorithm DSPARK \
--speculative-draft-model-path /models/Qwen3.8-27B-DSpark \
--speculative-dspark-block-size 7 \
--speculative-draft-model-quantization unquant \
--speculative-draft-attention-backend flashinfer"echo ">>> 启动前检查"
docker ps -a --format '{{.Names}}' | grep -q "^${NAME}$" && { echo "残留容器, 删除"; docker rm -f $NAME; }
ss -tlnp | grep -q ":${PORT} " && { echo "端口 ${PORT} 被占用!"; exit 1; }
free -h | head -2echo ">>> 启动 Qwen3.8-27B-NVFP4 + DSpark via SGLang on :${PORT}"
docker run -d --name $NAME \
--gpus all --ipc=host --shm-size 32g \
-p ${PORT}:30000 \
-v ${MODEL_DIR}:/models/Qwen3.8-27B-NVFP4:ro \
-v ${DRAFT_DIR}:/models/Qwen3.8-27B-DSpark:ro \
${IMAGE} \
python3 -m sglang.launch_server \
--model-path /models/Qwen3.8-27B-NVFP4 \
--served-model-name Qwen3.8-27B-NVFP4 \
--host 0.0.0.0 --port 30000 \
--dtype bfloat16 \
--context-length 262144 \
--mem-fraction-static 0.88 \
--max-running-requests 2 \
--kv-cache-dtype fp8_e4m3 \
--attention-backend flashinfer \
--mamba-ssm-dtype bfloat16 \
--mamba-radix-cache-strategy extra_buffer \
--disable-prefill-cuda-graph \
--chunked-prefill-size 8192 \
--reasoning-parser qwen3 --tool-call-parser qwen3_coder \
--enable-cache-report \
--trust-remote-code \
${SPEC_ARGS}echo ">>> 监控日志 (等 server ready)"
for i in $(seq 1 90); do
sleep 10
docker logs $NAME 2>&1 | grep -qE "server is ready|fired up" && break
done
docker logs $NAME 2>&1 | tail -20echo ">>> 验证"
curl -s http://localhost:${PORT}/v1/models | head -c 300
echo
echo ">>> 推理验证"
curl -s http://localhost:${PORT}/v1/chat/completions \
-H 'Content-Type: application/json' \
-d '{"model":"Qwen3.8-27B-NVFP4","messages":[{"role":"user","content":"Count 1 to 30, one per line"}],"max_tokens":60,"chat_template_kwargs":{"enable_thinking":false}}' | python3 -m json.tool | head -25主楼 - 某*2026-08-17
效果看着还不错啊,可惜只能是富哥的玩具。