- TomMao232026-08-17
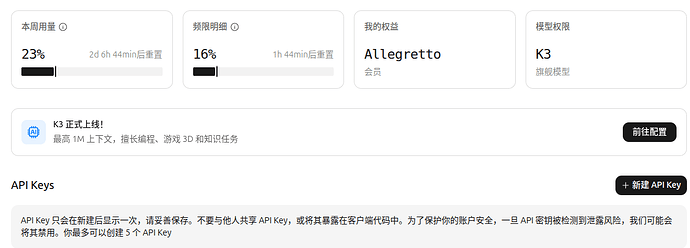
套餐:199
众所知kimi的额度是一个固定的rmb额度,缓存命中越高则可用tokens更多,k3和k3-256k的价格在256k以下是一样的,但是大于256k的上下文下额度消耗速度应该更快。
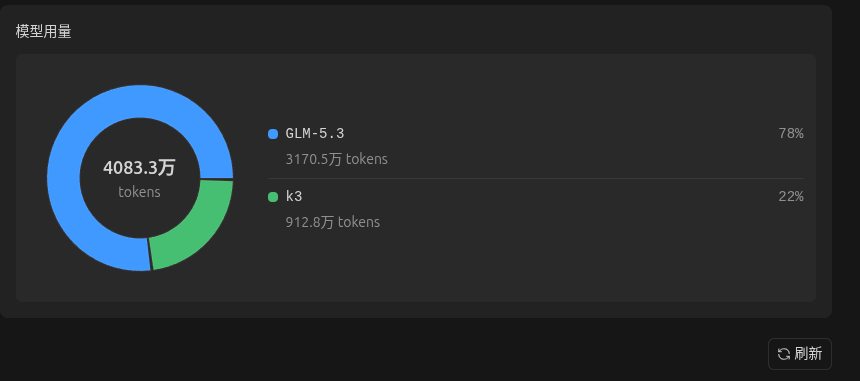
之前是在kimi code里用,模型k3-256k,缓存命中率不可见,根据kimi code /usage 测算单个任务得到数据840w tokens,5小时窗口消耗26%,推出5小时tokens大约3200w tokens。今早在Zcode里用GLM5.3白嫖的token干活,9点赠送token到期,此时上下文达到了260k,于是我在Zcode里切换了k3 1M上下文版继续干活,最终消耗912.8w tokens 15.5% 5小时额度,Zcode看到缓存命中率98.3%,推出的5小时token有5889w
没控制变量的地方:kimi code上用的k3-256k,上下文始终未超过256k,项目是three.js纯前端建模,涉及无头浏览器上大量自己截图自己看的多模态操作。Zcode上用的是k3并且是在260k以上的上下文开始用的,任务结束时上下文窗口是314k,项目是CUDA算子开发和html报告撰写不涉及多模态
 主楼
- Doori_Kiss2026-08-17
k3-256k价格是k3(1M)的一半吧
- TomMao232026-08-17
官方自己在飞书群里反复回答说的在256k上下文内使用k3和k3-256k价格是完全相同的。价格一半的说法是考虑任务上下文超过256k以后
- eroultraman2026-08-18