- Kemou2026-08-22
一句话总结:
原本个人PC跑不起来大模型,主要是因为显存不够用,但是如果把东西放到CPU内存后,PCIe传输速度成了瓶颈
这个优化直接把整个电脑视作一个整体,灵活地把 MoE 里不常用的 Expert 放到 CPU 内存里,常用的放在 GPU,甚至让一部分直接用 CPU 算,从而实现个人电脑跑大 MoE
具体实例:
4060 笔电 32g 内存跑Qwen3.6-35B-A3B,30+tok/s
5090 192ram 跑 dsv4f(284b a13B),20tok/s
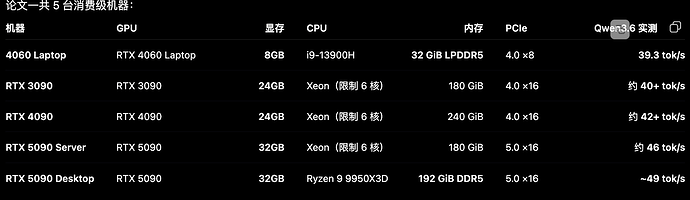
测试的设备跑 Qwen3.6,注意到速度没差多少,因为算力不是核心瓶颈原论文: [2608.16157] FreeToken: Efficient Edge-Native MoE Serving with Bandwidth-Adaptive Execution
要注意的是,不仅是上述的测试平台,任何的 GPU、CPU、内存、PCIe 带宽都可以在他们的系统下灵活调整,灵活地将多少 expert 放在哪个位置
总而言之,期待这样的工程优化能让端侧跑更大的模型得以实现
(lz 才疏学浅,是咨询 GPT 定性肤浅理解的文章,欢迎各位佬友指正补充)
主楼 - vextuber2026-08-22
那确实有点牛B了,解除了消费级显卡显存限制,估计内存又要涨价一波了。
- Shilin_Zhou2026-08-22
还有放硬盘里的,几分钟一个 token
- hugo02026-08-22
- PJ5682026-08-22
动态缓存,相比 llama.cpp 命中率提高了,对 Prefill 做了额外的优化,内存占用改为弹性而非固定分配。