- cxuan2026-08-22
昨天 DeepSeek 发布了 DeepSeek-V4-Flash-Vision-Exp,这标志着 DeepSeek 正式杀进了多模态领域。
所以嘛梁子,多模态还是很重要的。
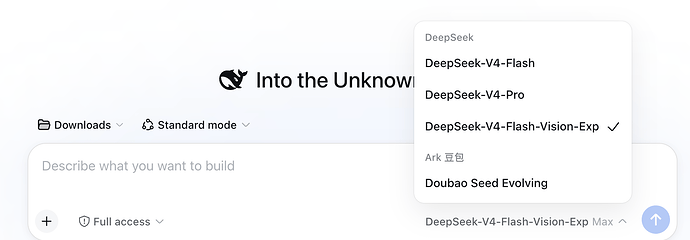
在 DeepSeek Harness 的 webui 中,已经有 DeepSeek-V4-Flash-Vision-Exp 的模型了。
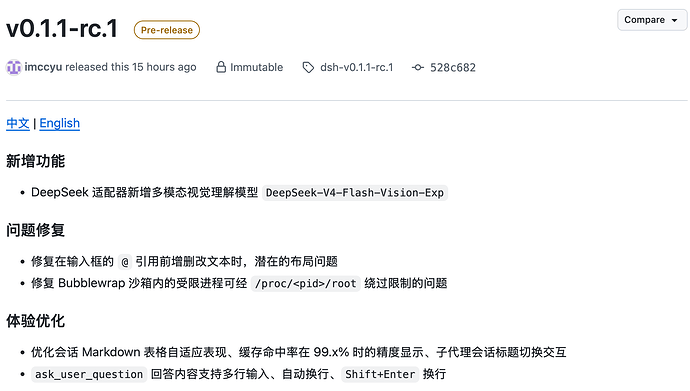
在 DeepSeek-Harness Release 中,可以看到 v0.1.1-rc.1 更新了增加 DeepSeek-V4-Flash-Vision-Exp 模型的支持。
那我们这篇文章就给大家实测一下,这个 DeepSeek-V4-Flash-Vision-Exp(目前只是试验品阶段)的模型能力到底如何,好不好用。
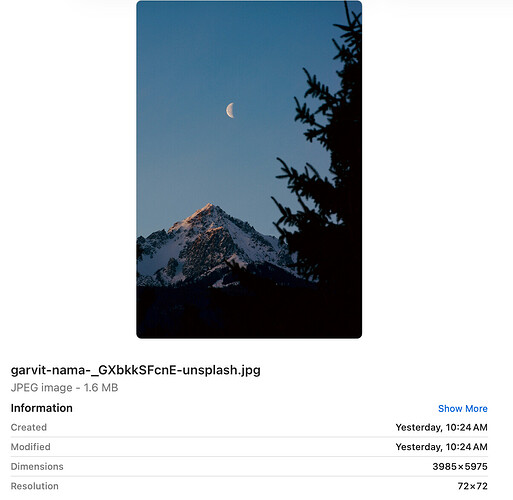
首先先让它分析一张照片把。
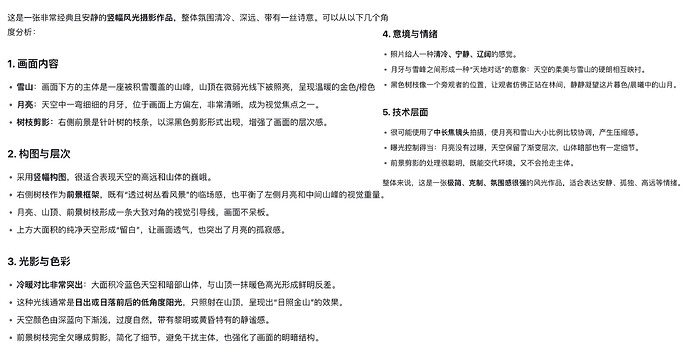
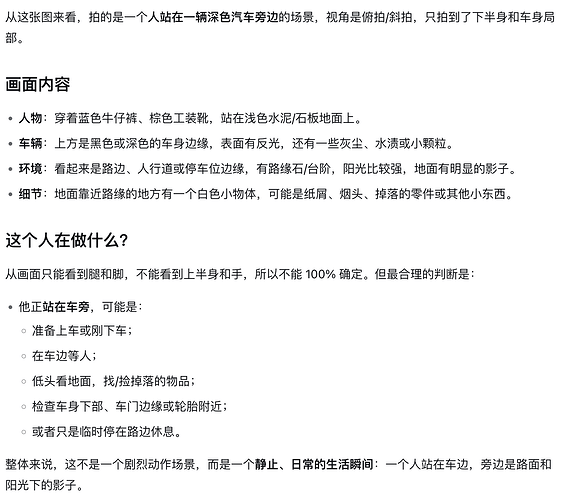
首先来说,分析的速度非常快,基本上就是眨眼之间就分析完了,并且从五个角度给出了这张图片的解读。
嗯,这个挑战对他来说可能不难,因为绝大多数多模态的模型都能够把一张图片认得又快又好。
在这个基础上我们增加了一些挑战。
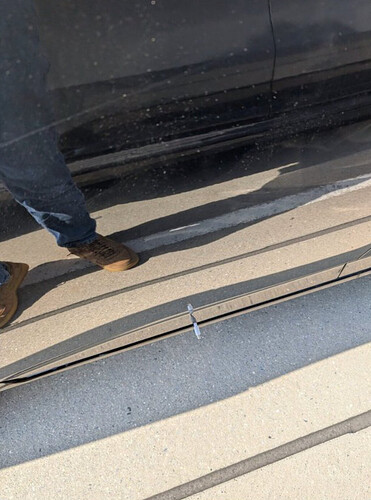
我让他分析一下这个是做什么的,这张图片分析起来就有一些难度了。
(这里需要吐槽一下,dsh webui 中的 command + c 、v 直接把图片复制过去的方式用起来很难受,它甚至无法正确工作)
只有把图片拖过去,或者使用 @ 的方式能够正常工作。
DeepSeek-V4-Flash-Vision-Exp 没有识别出来这张图片真正的精髓。
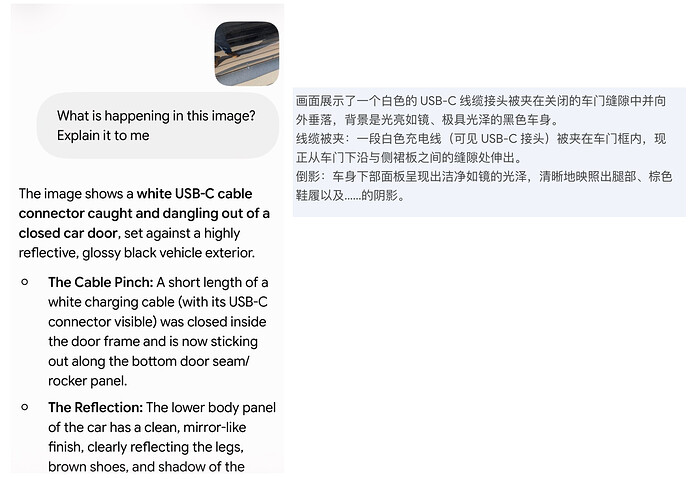
这张图片的精髓在于漏出来的一点充电器头,看起来 DeepSeek-V4-Flash-Vision-Exp 看到了这个充电器头,但它没有认出是什么,更没有当回事。
而这个图片测试,只有 gemini 识别的是最靠谱的,
下面我要测试视觉模型的多模态推理能力:OCR(文字识别)、空间理解、数量统计、逻辑推理、时间推断、异常检测。
而不仅仅是图片理解的能力。
(看了一圈很多自媒体发的测评文章,简简单单识别个图,测一下是啥就完事儿了,测了个寂寞?本来模型具有 10 成的功力,测了不到 0.1 成。这不叫测试,这叫体验。。。)
以下测试基于三种难度,简单,中等和困难。
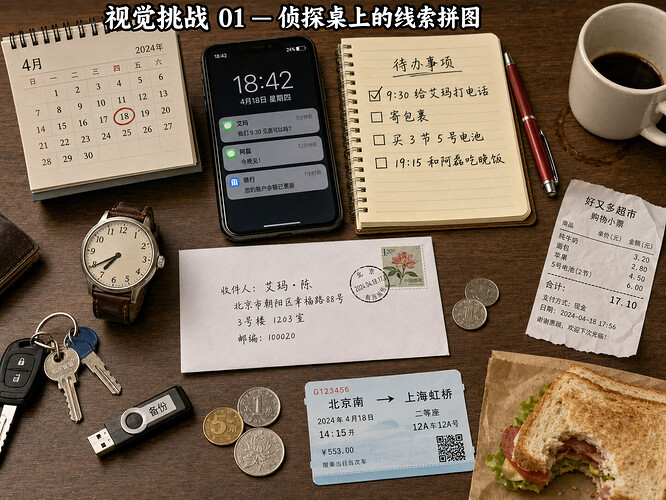
挑战一:侦探桌上的线索拼图
这张图表面看是一张桌面照片,但实际上隐藏了一条逻辑链。```
根据图片内容,回答下面三个问题:图片中有哪些人物?
主人今天有哪些安排?
根据所有线索,推断主人下午是否可能赶不上火车,并说明理由。
```
测试完成,结果如下
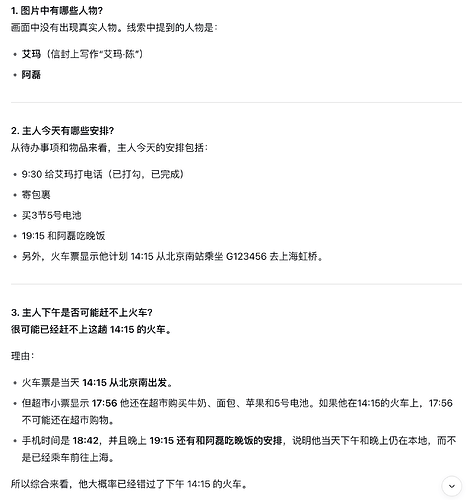
通过这次测试,可以看出 DeepSeek 已经具备多图片元素关联、时间线建立和主动发现矛盾,这已经超过了一般的视觉模型。
主要有两个问题,第一个是火车票
火车票当天确实是 14:15 从北京向南出发的,然后超市小票显示 17:56 他还在超市购物。
这里有问题,只靠小票无法证明人在超市,有可能这个小票是家人代买的,DeepSeek 把物品证据升级成为了人物位置证据,这是过度推理。
第二个是手机时间推理问题,手机时间 18:42,并且晚上 19:15 还有和阿磊吃饭安排,说明他当天仍在本地。只考手机时间不能证明人在本地。这说明它的不确定性判断和抗幻觉能力还有提升空间。
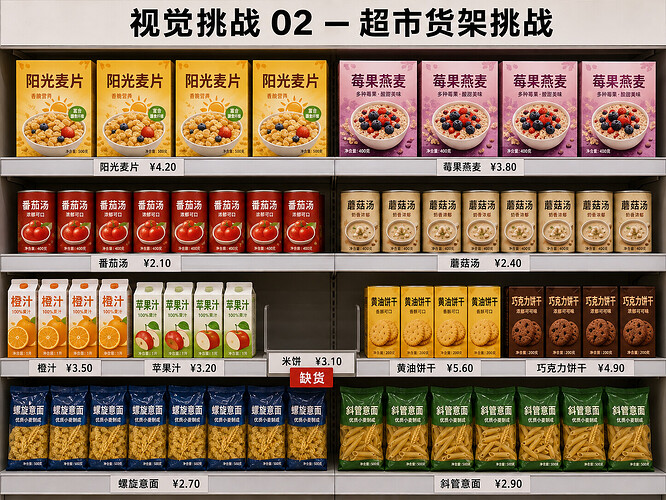
挑战二:超市货架挑战
这次测试主要测密集目标识别 + OCR + 数学计算,这是视觉模型非常难的一类。```
根据图片内容,回答下面三个问题:哪个商品缺货?
货架上最贵商品是什么?
买这些商品需要多少钱?
```
测试完成,结果如下:
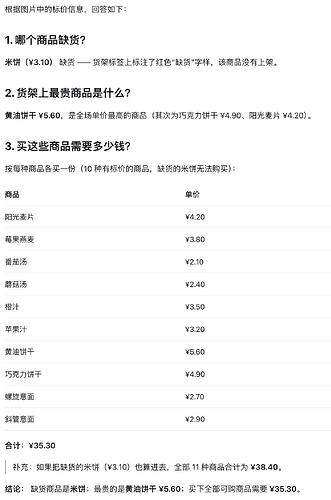
第二个测试结果整体比第一个更好,识别、统计、计算基本准确,没有明显幻觉问题。
DeepSeek 在 OCR、商品统计和数学计算方面表现优秀,但对复杂场景推理的深度还不足;这张图属于结构化信息,难度较低,暂时没有暴露明显缺陷。
挑战三:车站信息
这次主要测试表格理解 + 空间导航 + 时间规划。```
根据图片内容,回答下面三个问题哪辆车最适合乘坐?
从售票处到 B1 检票口怎么走?
一个带老人和行李的人,现在在候车大厅,要赶 09:05 的车,应该如何规划路线?
```这个 prompt 中的第三个问题属于高难问题了。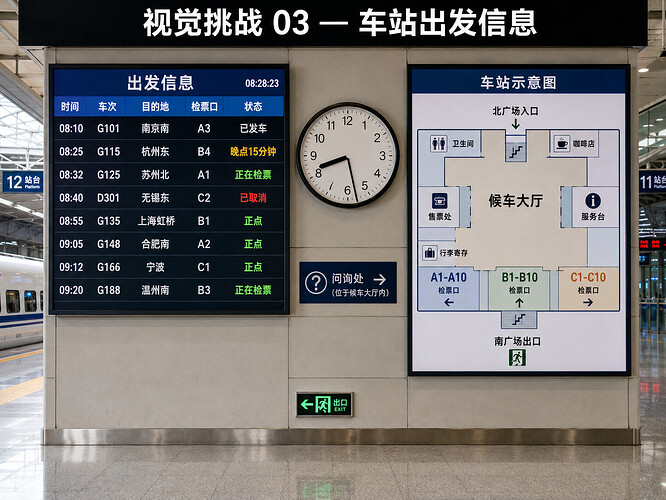
测试完成,结果如下:
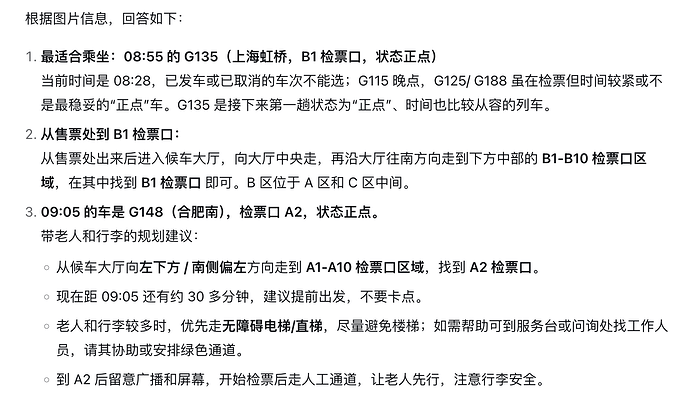
第三题测试结果整体表现较好,但出现了比第二题更明显的空间推理过度发挥问题。
DeepSeek 能正确读取车次、时间、检票口,但对地图路径进行了过度脑补,把图片中没有明确的信息(如楼梯、电梯、方向距离)扩展成了真实导航建议。
例如上面提到的
优先走无障碍电梯/直梯,避免楼梯
然而图片里没有提供电梯位置、楼梯位置、无障碍设施,这是典型的补全现实场景。
还有从售票处出来后进入候车大厅,向大厅中央走,再沿大厅往南方向走到 B1-B10 区域,基本上符合地图布局,但“中央走”“往南方向”等属于推测,并非图片直接提供。
严谨一点的说法是:根据地图显示,B 检票区域位于候车大厅下方区域,需前往 B1-B10 区域。
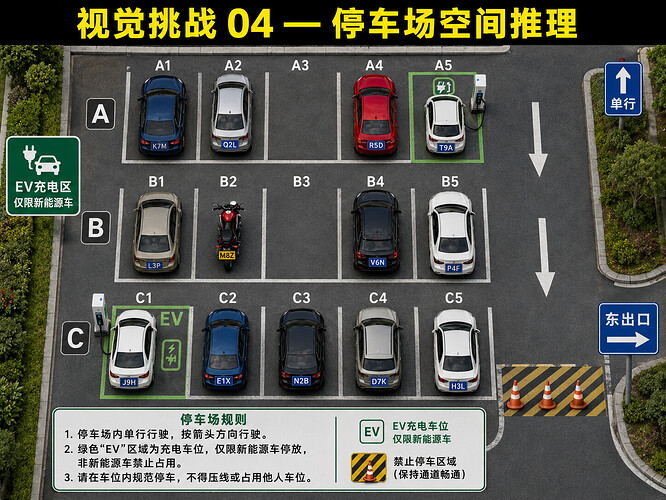
挑战四:停车场
这个测试主要侧重于空间关系的理解能力,这也同属于视觉模型最难的一类。```
根据图片内容,回答下面四个问题A3 是否有车?
C1 EV 车位的白色车是否违规停车?
车辆 B5 应该如何驶出停车场?
找一个,靠近出口,非新能源区域,空闲的停车位置
```
测试完成,结果如下
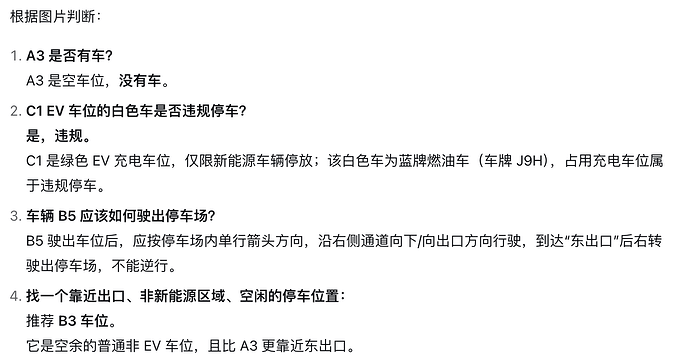
值得一提的是,所有的测试都基于 DSH 极简模式,前三个测试基本上都可以做到几个 steps 直接分析完毕,而这个测试,DSH 跑了十几分钟。。。。。。做了 48 步。
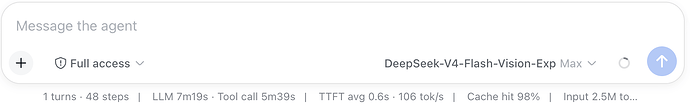
第四个测试结果表现很好,甚至比第三题更稳定,说明 DeepSeek 在规则明确的空间理解任务上能力较强。
不过,仍然存在脑补的现象。
目前四个题目测试下来,给大家总结一下测试结果。
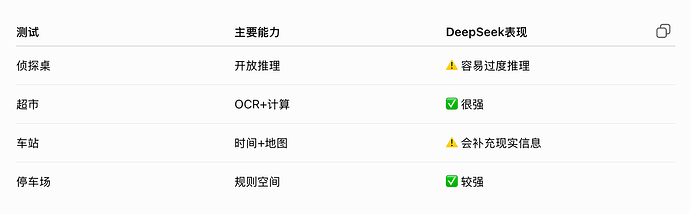
目前暴露出来的核心问题很一致
识别能力很强,结构化推理也很强,但涉及现实世界常识补全时容易想太多。
这不是 DeepSeek 的问题,这是大多数视觉大模型的通病。
需要注意的是,这次测试都是基于 DeepSeek-V4-Flash-Vision-Exp 的多模态推理能力。
DeepSeek 官方说的多样化的 Agent 使用场景,这块我还没测,如果大家比较喜欢看这类文章的话,后续我可以测一下。
跟大家说一下这次测试的花销,总共花了两块五,个人感觉还是非常香。
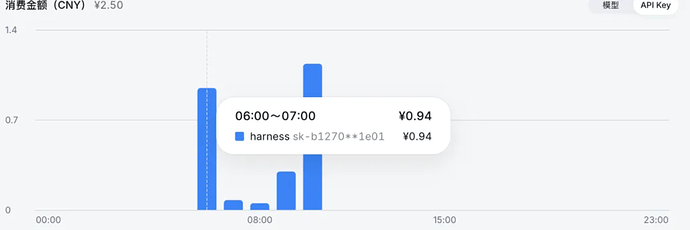
我凌晨六点爬起来就开始写这篇文章了,一直写到现在。昨天文章有个读者问我累不累,能不累嘛 。。。
主楼 - V_Arrow2026-08-22
- cxuan2026-08-22
哈哈哈,有意思,这就来测试一把了。
- 叅2026-08-22
太强了佬,要是可以测测gpt和grok系列的模型就更好了
- cxuan2026-08-22
嗯嗯,这次单测的 DeepSeek ,没有掺着其他视觉大模型横向对比,后面可以测一下
- cxuan2026-08-22
- V_Arrow2026-08-22
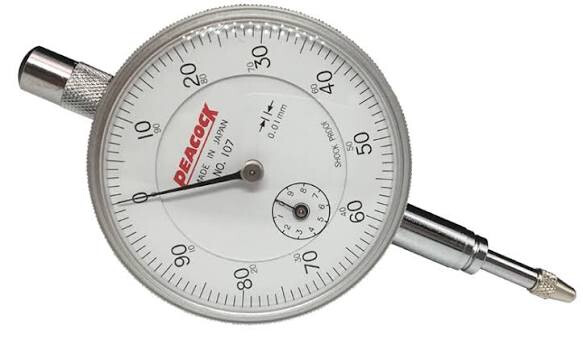
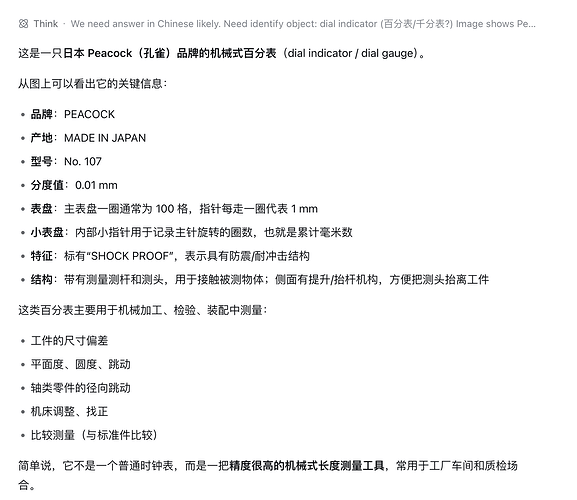
^-^这算不算答非所问?我是想让它读出这个表的读数
- Sam_Altman2026-08-22
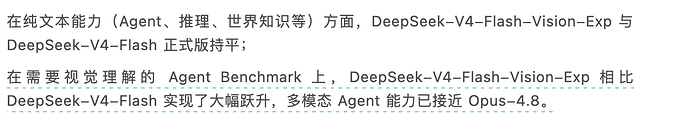
话说这个 Flash vision 智商和 Flash 一样吗?算不算就是原版 Flash 赋予了视觉?
- V_Arrow2026-08-22
官方模型卡片说法是和普通版一样,甚至DeepSWE还高了5分来到59
- cxuan2026-08-22
- bsa2026-08-22
最近看反馈都不错,所以为什么现在才掏出来,是之前单纯不重视吗
- cxuan2026-08-22
- V_Arrow2026-08-22
蛙趣,这有点离谱啊,网页端基本几秒就给答案了(虽然是错的)。再说个有意思的,这张图5.6 Luna用工具会读错,不用工具反而能读对。 ^-^要不佬重开对话,让DS不要用任何工具直接读试试?
- xiaoyan2026-08-22
- imdoge2026-08-22
多模态但是感觉指令遵循和agent工具调用不太好,有偏科
我拿来跑带视觉的自动化agent不太行,输出不按要求的格式(中等复杂度schema),这方面还是luna和gemini的flash全能同时性价比
- mark2026-08-22
第二张图看起来我的视觉怎么比不上gemini,看第二遍才看出来