- LLLLLL2026-08-22
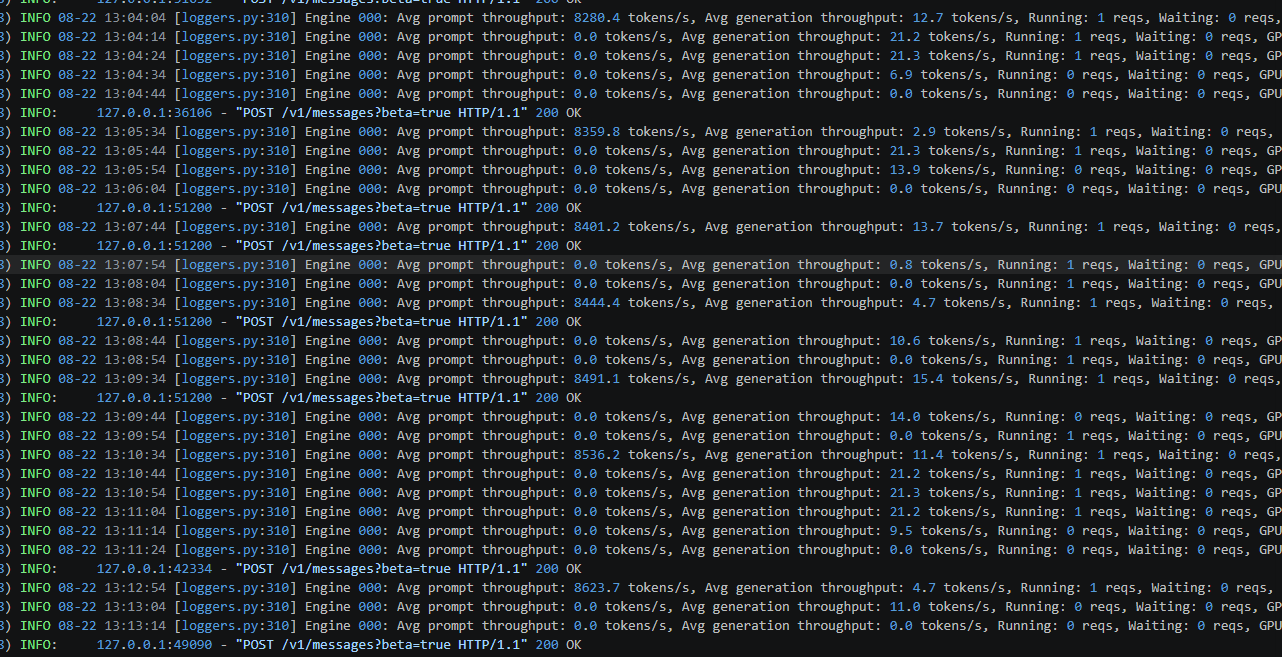
我是用的单卡Pro6000D部署, BF16精度上下文256K,KV缓存FP8精度。token速度很慢啊,大概就是在20token/s。是哪里需要优化吗?还是说权重用量化后的FP8会快一些?精度损失严重吗?
我也试过两张Pro6000D部署,速度还是差不多,也是在2-30token/s徘徊。
或者说佬有更好的部署方法?
 主楼
- LLLLLL2026-08-22
难道是pro6000D 的算力砍的太多了吗 ^-^
- 落寞书生2026-08-23
这个速度太慢了,我用的llama.cpp部署的unsloth ud q8量化,3个魔改2080ti 开启mtp和sm tensor都能跑到45t/s,峰值60t/s左右,vllm理论并发应该更快