- cat80232026-08-24
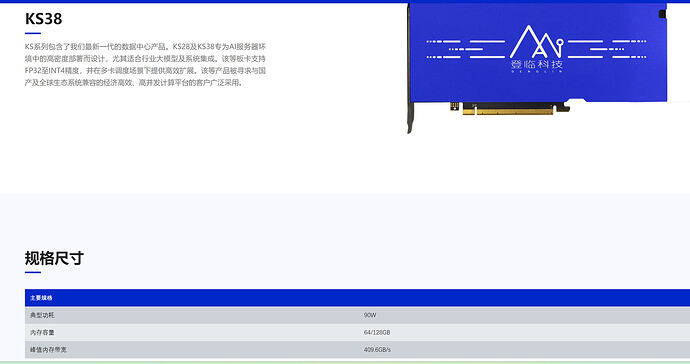
佬,最近公司搞到一个国产卡,我用的是64G的规格的,之前跑了一下Qwen3.5-35B-A3B-FP8,还能达到50~60 tokens/s, 但是重新部署了一下Qwen3.8-27B-FP8, 只有3~7 tokens/s,下面是我的启动脚本,我想问一下这是正常的吗?还是我没配置好,我看论坛佬友 5070ti都可以跑50~60 tokens/s ^-^```
#!/bin/bashsource /usr/local/dlgpu/sdk/env.sh
cat /usr/local/dlgpu/sdk/version.txt#dnf install -y numactl
MODEL_NAME=Qwen3.8-27B-FP8
MODEL_PATH=/home/work/$MODEL_NAME
export TP_NUM=4
export OMP_NUM_THREADS=2export DLEOL_USE_CU_MQA_TILEKV=1
export VLLM_MAX_MOE_CU_TOKENS=128
export VLLM_ALLOW_LONG_MAX_MODEL_LEN=1#vllm serve --model $MODEL_PATH \
numactl -C 64-95 vllm serve --model $MODEL_PATH \
--served-model-name $MODEL_NAME \
--tensor-parallel-size $TP_NUM \
--gpu-memory-utilization 0.9 \
--port 8090 \
--max-model-len 65536 \
--enable-auto-tool-choice \
--tool-call-parser qwen3_coder \
--reasoning-parser qwen3 \
--mm-encoder-tp-mode data
``` 主楼
- Scheme2026-08-24
- cat80232026-08-24
主要是我看有佬友用5070ti也能跑 50~60 tokens ^-^
- WUchengji2026-08-24
完全两个模型,一个激活参数是3B一个是全量27B那速度肯定不一样啊
- Scheme2026-08-24
上面那个moe只激活3b,下面那个27b,应该说差得不是一点点
- MICO2026-08-24
M1 Pro 32GB+512GB 能跑起来补
- fineok2026-08-24
得看是不是量化版本,再加上3.5-35B-a3b属于MOE,每次激活3B,而3.8 27B是全量激活,所以有这个差距应该是正常的,可以看看3.8的其他量化版本呢
- Scheme2026-08-24
- wugeng2026-08-24
qwen3.8-27b-nvfp4-rtx5090+qwen3.8-27b-dspark-nvfp4,按readme推荐参数120k上下文,160token/s。用了几个版本这个应该是最快的了,毕竟体积17G,最小了。不用spark可以开256k上下文,速度会稍微慢一点。用21G的nvfp4版本,开192k上下文,速度在30token/s,也够用了。 昨天全程让codex调试的。佬可以让codex来部署。
- Hopeless2026-08-24
跑35B-A3B的速度反推,这个卡的显存带宽估计也就200GB/s,跑稠密模型掉成个位数很正常,用Q4量化试试吧,估计速度能翻倍
- 汉武帝(的大熊猫)2026-08-24
稠密模型是这样的。看着是27实际相当于100b的运算开销。不过它也有他的好处
- knsew2026-08-24
稠密模型上MTP上必须的,可以试试Q4 gguf开启MTP n=2/3
- Mr.Candy2026-08-24
开 DFlash 有惊喜,试试吧
- xqc2026-08-24
27B的FP8不就27G了吗然后还有65536的上下文可能就是1个token要四十多g显存了,7token就是正常的啊400/40多