- 头铿锵2026-08-26
现在有 mini 的大佬们买来日常使用频率高吗,是走 api 养龙虾,还是自己本地部署啊,Mac 部署27B 要什么配置。
主楼 - lucaslee6062026-08-26
本地部署就要看内存大小和内存带宽。所以本地部署最好就上M5U,有1288G内存带宽。 ^-^
- zee2026-08-26
64GB内存其他随便你买。都可以的
- ezios2026-08-26
Mac跑不动稠密,太慢了。
考虑这个方案吧,比mac便宜得多
weicj/vLLM-2080Ti-Definitive: The definitive vLLM runtime for dual RTX 2080 Ti 22GB + NVLink, delivering Qwen 27B local inference with maximum 100+ tok/s single-request decode with support of FP8 weight
- nayo2026-08-26
大佬牛逼,我靠,虽然说现在涨价了,但是怒剩好多
- gfu2026-08-26
1288G吗, 那很有实力了佬 ^-^
- dcchan2026-08-26
最近在 Mac M3 Max 36G 上跑了 Qwen 3.8 27B(大小14.98G的版本),10-20 Tok/s。有个问题是它虽然开启 Extra High 之后,智能的确很强,但是思考的内容也很长。所以,解决一个 bug 动则 10 分钟。
以此估计,如果能上到 100 Tok/s,解决一个bug 2-3 分钟,才更可用。所以推荐 64G 以上的,自己折腾一下优化方案;如果懒得折腾直接上到 128 G。
 lostsheep2026-08-26
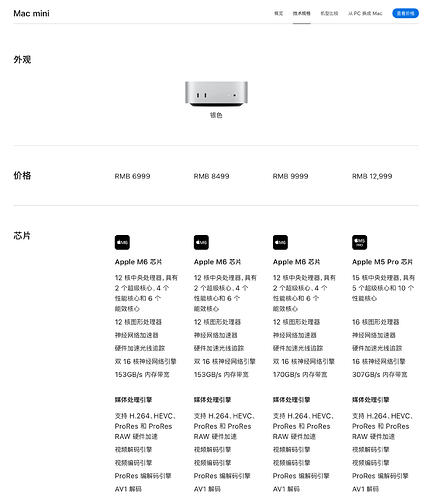
最新的 mac mini 规格最高只能去到 64GB ,这个规格跑 MOE 的混合架构模型可以,比如 qwen 3.6-35B-A3B 这种
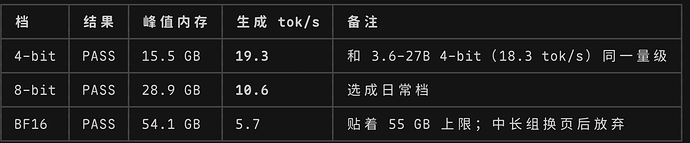
跑 dense 的稠密模型拉跨,prefill 速度还行,但 decode 速度很拉,上下文也开不了多大
27B 这个以 qwen-3.8-27B 的 8bit 量化模型来说,
m5 pro 64GB 使用 mlx_server 来部署,128K 上下文,decode 速度只有 11 tok/s,
接到 pi 里面做个鹈鹕测试用了一个多小时 ^-^
接到 workbuddy 里面用,被 workbuddy 内置提示词 30k 首提示词干飞了,10多分钟才开始吐字 ^-^
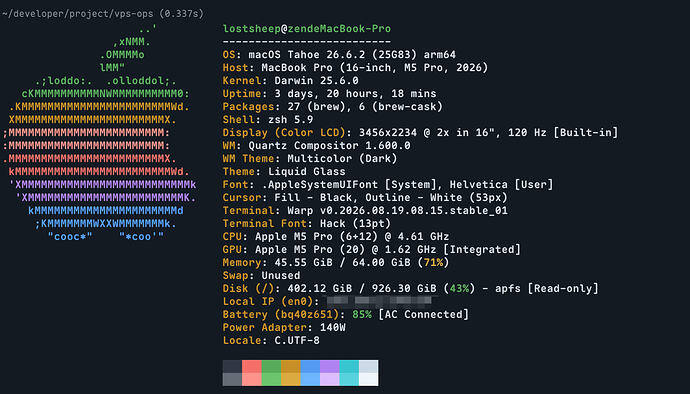
综合最新的 mac mini 涨价 300$, 6999¥ 起,其实没什么性价比
- lucaslee6062026-08-26
我意思M5ULTRA的内存带宽有1288G哈。不是内存哈