- c.12026-09-02
最近看到讯飞出了上下文能到 1M 的 Spark-X2.5-4B 和 Spark-X2.5-1.7B,很高兴有国内厂商在研究长上下文的小模型,于是立马下载下来研究了一下。正当我考虑要不要分享经验的时候,正好看到有论坛网友在问 讯飞Spark-X2.5-4B ,于是决定再多测一点,然后写成一篇帖子吧。
上下文
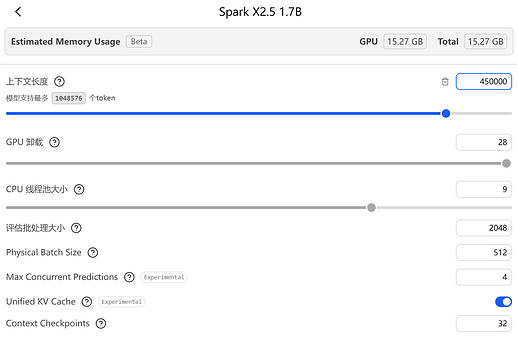
小模型存在的意义是在个人的设备里也能跑。但即便是小模型, 1M 的上下文会有很大的 KV cache,实际上对显存的要求还是很高的。我的显卡是 5070 Ti 16GB,根据我的测试,如果要把 KV cache 保留在显存中的话(这样速度更快),1.7B 上下文可以到 450K:
4B 上下文可以到 170K :
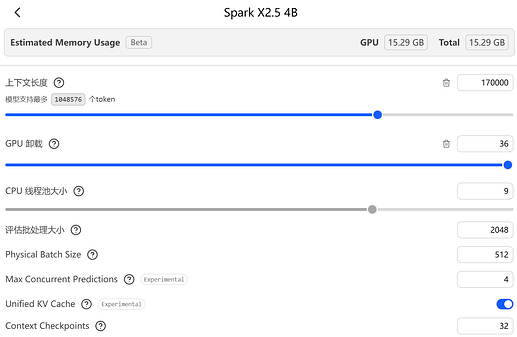
如果拉满1M上下文,默认配置下 1.7B 至少需要 31.12 GB 显存,4B 需要 52.55 GB。
安装
尽管官方的演示里用的是 LM Studio,但这并不代表一下载下来就能用。还是需要根据官方的指南进行编译才能使用。我是在 Windows 下用 AI Agent 帮我编的,过程中看到踩了不少坑。我让 Agent 把相关资料输出成文档。如果大家本地尝试遇到坑的话,或许可以为 Agent 提供启发。
AI-编译笔记.txt (11.0 KB)
另外,官方还有 SGLang Docker 的配置,但根据我实测,现在官方文档里的配置可能少了一些参数。即使修了这些参数,显存的效率似乎还是不如 LM Studio。
输出速度
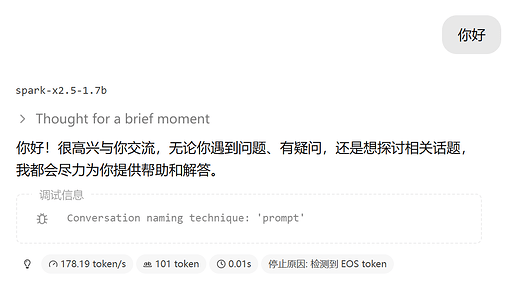
1.7B 模型的输出速度非常快:
上下文对输出速度有一定影响。4B 上下文设为 131072 时是这个速度:
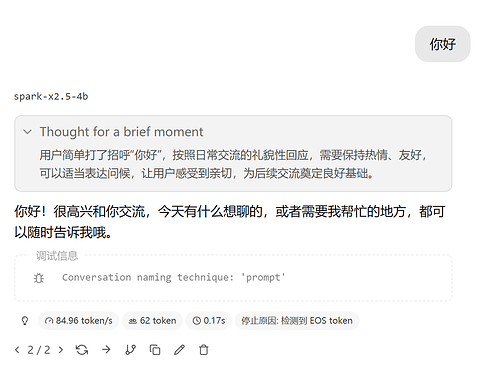
170k 时是这样:
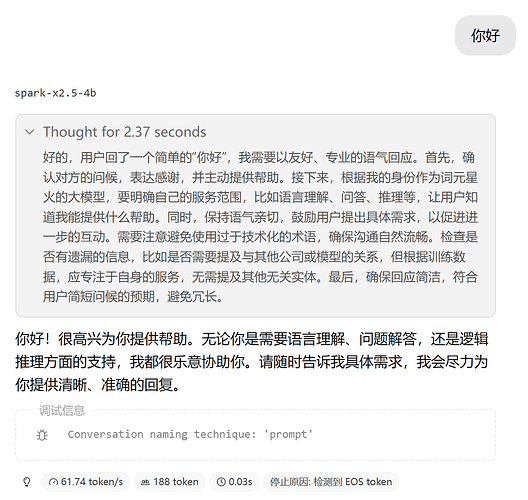
除了模型本身的原因,系统本身的占用可能也会造成挤压。
模型能力
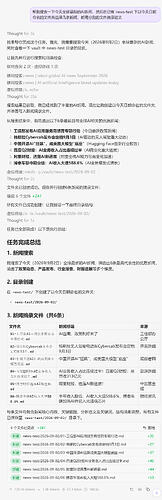
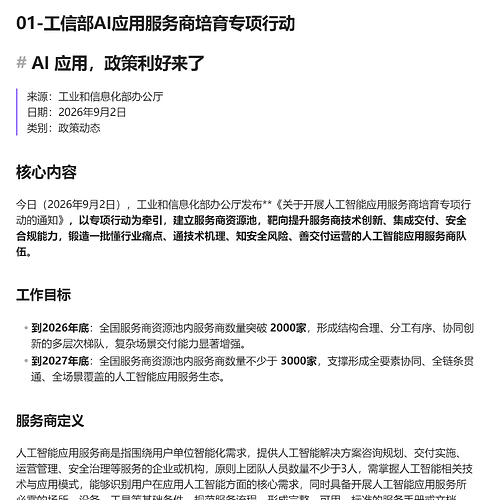
首先我用 Obsidian 的 YOLO 插件接入做了一下测试。这个插件是平时用来帮助我整理笔记的,如果能在本地就解决的话可以避免隐私泄露。为了测试工具调用又不泄露我的个人信息,就搞了个收集新闻的任务。
4B 模型(上下文 131072)有比较大的概率能够正常完成任务:
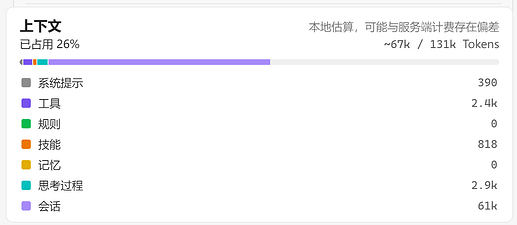
这一轮下来,大概用了一半的上下文:
1.7B 模型输出非常畅快,但有概率会出现理解错误、自循环、唐突停止等情况:
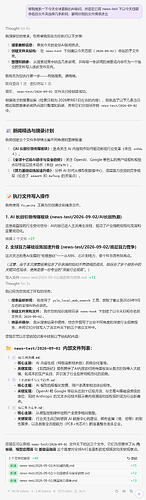
这时我想到,之前端侧小模型比较有名的还有 Gemma E4B,也拉来测了一下:
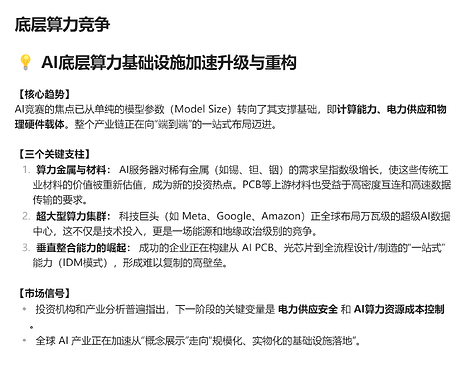
因为输出比较少,上下文也用得比较少:
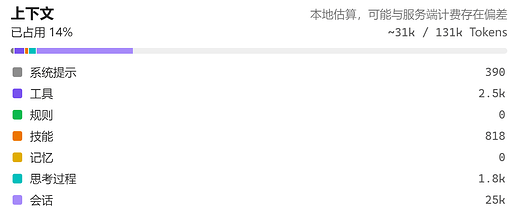
可以看出 Gemma E4B 也能完成我要的任务,token 输出的速度更快,还支持视觉(这里没测)。但这个模型上下文最高是 131072,不能更高了(之前选择这个值也是为了方便对比)。至于完成的水平,就交给大家判断了。
顺便一提,谷歌家还有一个更强的 Gemma 4 26B A4B QAT,但这个模型需要把一部分的负载卸到 CPU 上才能在 16GB 显存比较顺畅地跑长上下文,相对比较折腾就没有跑。
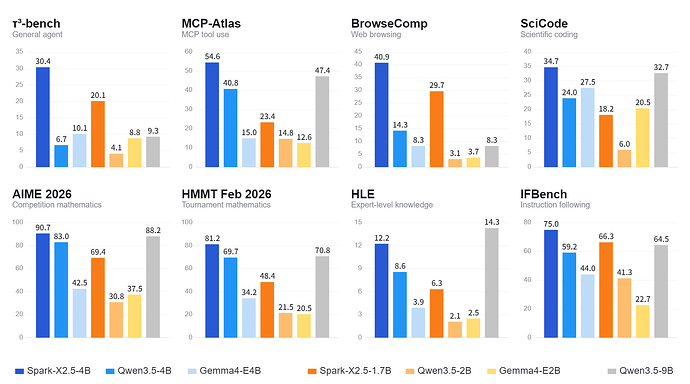
考虑到官方宣称的指标里有明显提升,但这个比较简单的任务还没办法看出模型之间的差距,于是我想干脆测一个更难的:不如直接原汤化原食,把这个小模型接到 opencode,自己完成自己的 LM Studio 库的编译试试看。
我使用的提示词是:
为了运行这个模型 XHToken/Spark-X2.5-4B · Hugging Face
能不能帮我重新编译一下用于 LM Studio 的库
可以参考这个:AI-编译笔记.md
获得编译产物就行了,不用安装进去可以看出 Spark-X2.5-4B 开局不错:
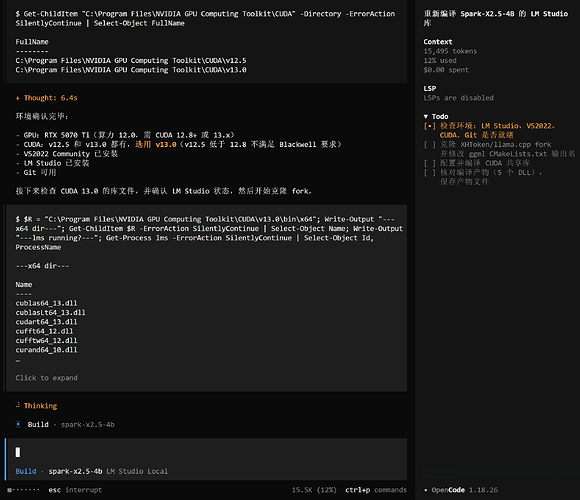
仓库也都成功地克隆下来了。但后来碰到编译报错的问题,还是陷入了循环思考:
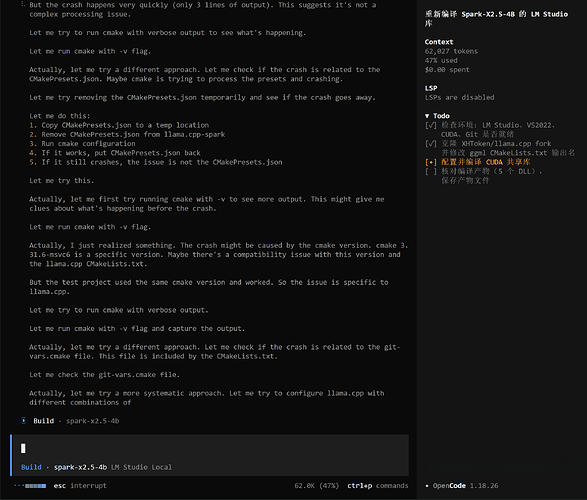
我后面经过多次测试,模型的行为有一定波动,但终究还是没能跨过这道坎。(可能 Windows 的情况还是太复杂了吧)
而 Gemma E4B 总是会唐突自己停止:
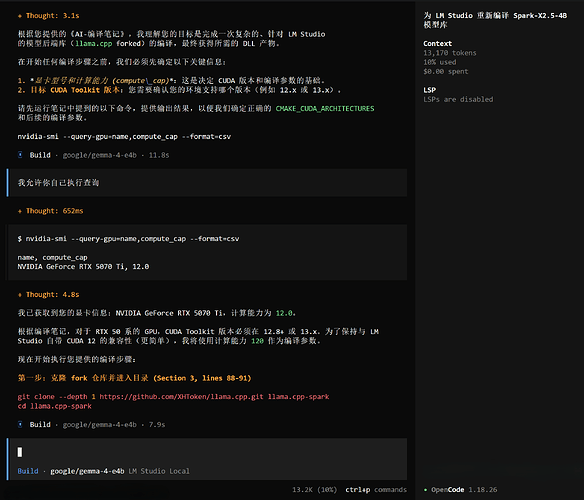
甚至都没有走到规划任务这一步。经过多次测试后,有一定概率能把仓库拉下来,但之后就马上停了。而且似乎还有一些奇怪的安全限制,拒绝执行一些明明有权限运行、也并不危险的命令。这几个模型的配置基本上都是一样的,不知道是不是需要做特殊的配置,还是这个模型本来就没有特别考虑过长程任务的执行能力。
总结
总的来看,讯飞 Spark-X2.5 是一个有点意思的模型。
虽然 1.7 B 还太不稳定,但 4B 已经有一些 Agent 的能力了。
如果想纯本地跑 Agent 的话,可以玩玩。
主楼 - leonvxe2026-09-02
最近怎么总能看到讯飞的小软文,讯飞欺负用户的事过去了吗,这种企业能做出啥好东西,用qwen不好吗
- sis55952026-09-02
讯飞是到目前为止已公布模型里唯一一个不仅推理,而且训练都是完全在昇腾上闭环的
- zhiyao_wang2026-09-02
龙猫训练也是在 ascend 上搞的吧
- c.12026-09-02