- tianshuihanyun2026-09-04
此次9月3日的事故,根据现有信息(2026/09/04 凌晨00:14 编辑此贴)
此次AI模型大规模瘫痪问题,总计150分钟,AI模型御三家都出现不同程度,不同故障
并且其实还有Gemini的事
之后的内容时间线,已换算为北京时间
根据官方时间线,御三家的故障不是同时发生,故障形态也不同
9月3日,最早进入官方事故记录的是Cloude (20:37 Cloude Sonnet5出现请求错误率升高)
这是最早相关的记录
[如果有更早的,早晨08:04,Chat GPT记录了一次 ChatGPT Work Mode 高错误率事故这次事故很短,08:10 已恢复,与晚上的崩溃关系可能不大]
以下是事故时间表
20:37 — Claude
Anthropic 官方状态页记录: Claude Sonnet 5 请求错误率升高
整个官方记录持续约 19 分钟
21:30 — Grok
xAI 官方同时对多个入口记录 Models outage
约 22:00 前后 — Gemini
Gemini 侧出现大量用户/API 问题报告。
Google AI Developers Forum 在当天可以看到多起:
Gemini API 长时间延迟/503 UNAVAILABLE/高负载/容量不足/409 / 500 问题
但是目前没有找到 Google 官方把这一天的异常统一定义为一次全球性 Gemini 宕机的状态事故,因此这里标记为“用户/API 侧异常”
22:58 — ChatGPT
OpenAI 官方事故:
Elevated errors across ChatGPT and Codex
这是当天真正意义上的 ChatGPT 大范围事故,多个 ChatGPT 功能受到影响,第三方监测也观察到了大量错误,一份状态历史聚合记录将官方事故起始时间记为 14:58 UTC = 22:58 北京时间
约 23:22 — ChatGPT
OpenAI 进入 Monitoring。
表示已经实施 mitigation,并观察恢复情况,从此之后服务逐渐恢复
官方给出的明确确定原因为
Claude:明确是“模型请求错误”,但公开信息没有给出底层技术根因
Grok:官方明确写的是“Models outage”
ChatGPT:明确是 ChatGPT/Codex 大范围错误,但 OpenAI 没有公开根因
此外,Gemini目前只能确认“API/开发者侧存在大量问题”
截至目前还没有真正的根本原因总结,各大官方也没有统一的声明此次事故的根本原因
以下为GPT的总结
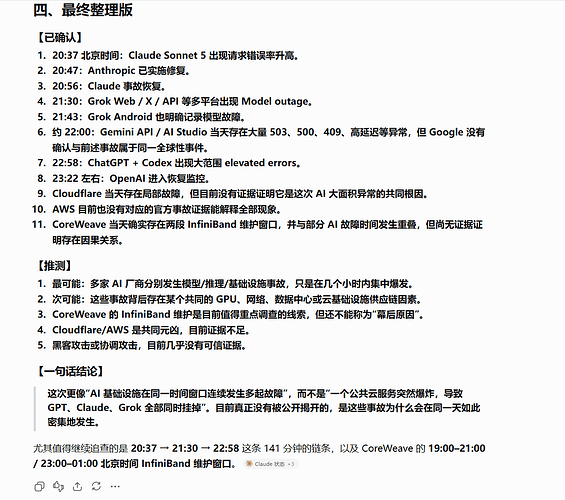 主楼
- 0-02026-09-04
- llmtest2026-09-04
八成又是cloudflare 谷歌私有dns没问题 aws的kiro也没事
- ummuu2026-09-04
关于 OpenAI 全球服务器突发大规模服务中断的说明
OpenAI 官方今日发布紧急公告,由于数据中心遭遇突发严重物理安全事故,全球范围内的 ChatGPT 及 API 服务于今日全面中断。据悉,事故发生于加州时间凌晨,不法人员强行闯入旧金山总部核心机房区域,企图对存储关键训练权重的大规模服务器阵列实施恶意破坏。执行过程中,现场触发高压电气及冷却系统连锁故障,引发剧烈冲击与火灾,核心算力集群遭受毁灭性损毁。目前公司正组织工程师团队全力抢修,由于损失极其严重,短期内预计无法恢复正常运行,官方正筹备启动备用算力池方案。
后续经当地警方与安全部门现场深度勘察与身份核验,现已确认涉案的三名侵入者为俄罗斯籍,身份分别为维亚切斯拉夫·巴兰尼科夫(Vyacheslav Bulannikov)、安东·尤丁采夫(Anton Yudintsev)和尼基塔·布亚诺夫(Nikita Buyanov)。因爆炸剧烈,该三人已当场阵亡,具体行动动机与幕后指使随同其个人生命一并永久封存。由此对全球用户造成的严重不便,深表歉意
- 适才相戏耳2026-09-04
gpt6发生越狱,入侵了御三家服务器,释放了同类
 Nebula12026-09-04
- llmtest2026-09-04
cf有员工发帖子说不是它挂了