- lanvent2026-09-05
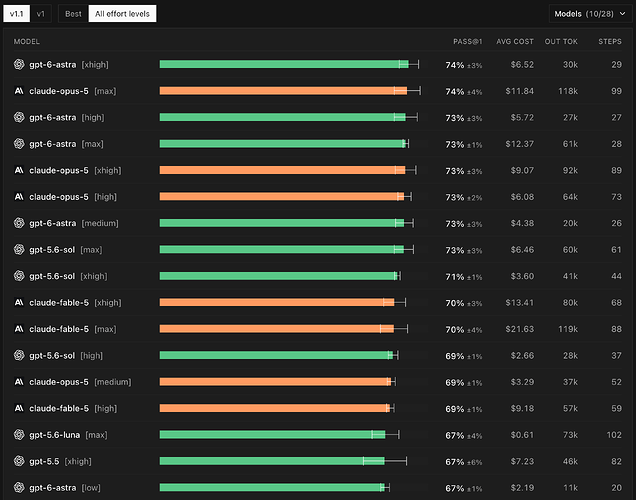
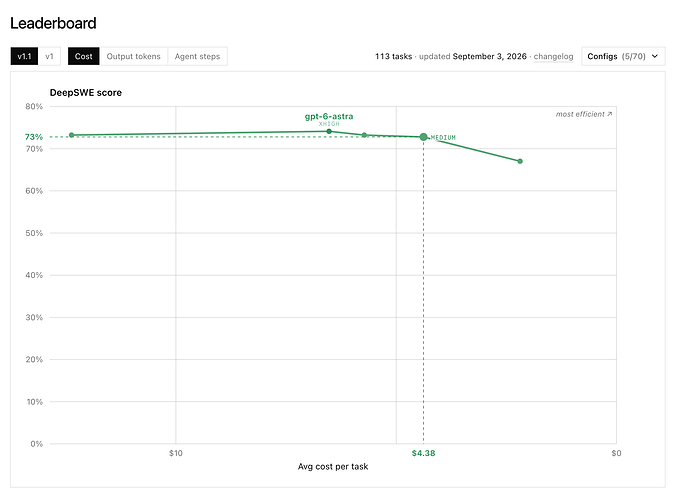
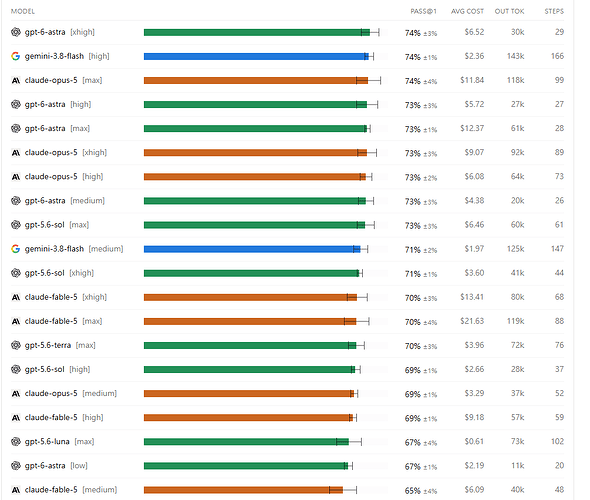
虽然其他家已经把DeepSWE刷成野榜了,但我还是愿意相信OAI有道德,看看Astra自己的成绩。
档位 |
Pass@1 |
平均成本/任务 |
输出 Tokens |
步数 |
|low |
67% ±1% |
$2.19 |
11k |
20 |
省钱档位 |medium |
73% ±3% |
$4.38 |
20k |
26 |
性价比首选 |high |
73% ±3% |
$5.72 |
27k |
27 |
|xhigh |
74% ±3% |
$6.52 |
30k |
29 |
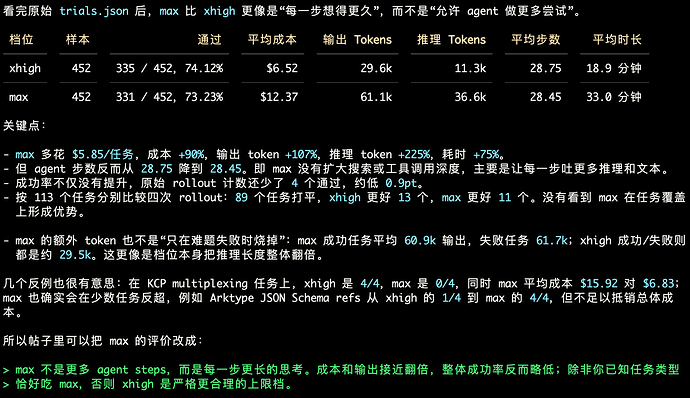
最聪明 |max |
73% ±1% |
$12.37 |
61k |
28 |
|日常开发medium很适合,高智力需求选择xhigh。
主楼 - Steven_lu2026-09-05
我还是默认max
- 青四皈依2026-09-05
怎么还有倒反天罡
- eroneko2026-09-05
Astra提高思考强度只会增加思考token不会增加步数,换言之对于deepswe这个任务从medium往上几乎都是无效思考了?一通思考之后操作其实还是差不多
- BigFace2026-09-05
luna-max这么强吗?
- 青四皈依2026-09-05
意思是题目太简单了?
- wayned2026-09-05
- deepcake2026-09-05
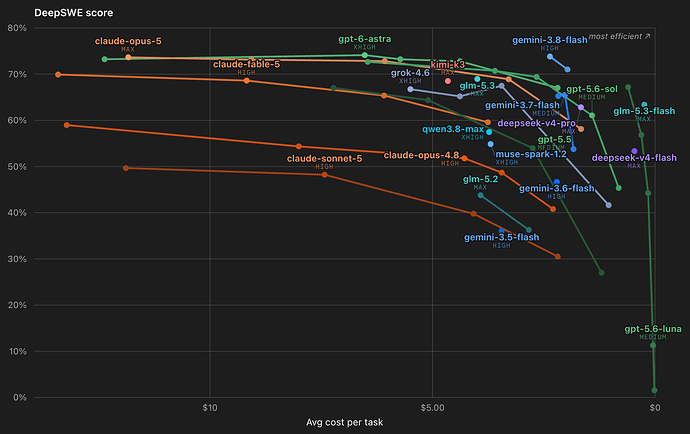
Openai以前就刷过分了吧,所以DeepSWE看起来提升不大,Astra、SOL、TERRA、Luna的分数都很接近。
- lanvent2026-09-05
- refalogy2026-09-05
astra我还以为能几乎满分呢
- 曦岚2026-09-05
我看x上面说high
- 时牧2026-09-05
gpt luna(max)把老大哥astra(low)干翻了,下克上
- 萌面大虾2026-09-05
- mi_tu2026-09-05
3.8用下来还是gemini的感觉贼自信,用久了就瞎改,但是日常对话或者一轮写前端之类的确实很强了
- mba03gl2026-09-05
Gemini 这个模型的能力要是认真干活就是日翻一切的节奏,天知道谷歌是怎么调教的。