- Ler1Shy-linuxdo2026-09-07
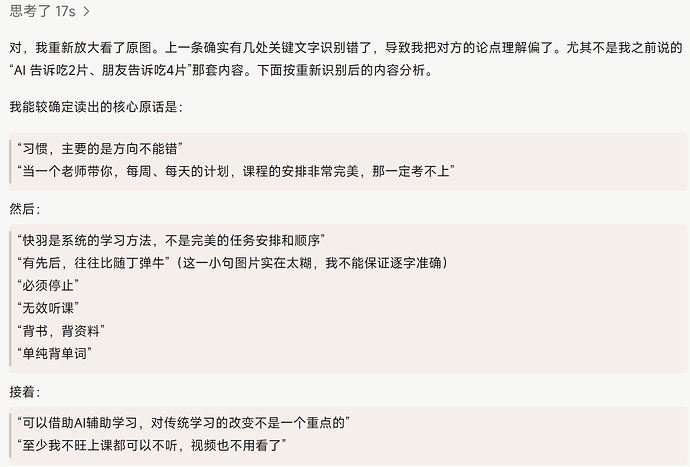
第一次就识别错了许多处
第二次他调用工具放大图片并裁切 结果依然错误
图片质量没问题 我手机电脑都能正常看清楚(是一段微信聊天记录)1216 x7897 645.8KB
除了手动再次分段截图 还有什么方法吗
(图片中模型为5.6sol 之前用gemini也有同样问题 似乎完全看不清 因为画质被压缩的缘故?)
 主楼
- ArtFr0st2026-09-07
试试把长截图转换成一个图片型PDF看看,这招在Gemini上很有用,以前几乎不可识别的超长截图基本上都可以准确识别,其他模型没试过但是应该是通用的。
- ryanfox2026-09-07
居然还有这种技巧,是大模型对PDF的orc有优化吗
- JackBlue2026-09-07
很可能是后端解码处理图片时变模糊了,类似很多软件发长图会变模糊,也有可能是缺少长图训练数据。
- shuxing_ji2026-09-07
发原图也会被官网压缩的,你把发出去的图片再用网页打开看看,上面字都糊的不成样
- ArtFr0st2026-09-07
我猜测是因为首先不会压画质,然后模型读取PDF是一页页一点点往下看的,虽然长图型PDF没有分页,但是类似我们自己看就是一点一点往下滑一样,所以会更精准。
- 还想成为88VIP2026-09-07
看情况吧,我这gpt和fable都没问题啊,手机截屏的,可能是还不够长吧
- Neptune2026-09-07
gpt没问题会代码自己裁切,不是硬读
- Shigure_init2026-09-07
因为图片会压画质呀,我之前给Claude发,他都明确说长截图因为压画质经过压缩,很糊