- luoyuqing2026-09-07
刷到 AMD 开发者中心有个 token factory,官方直接发免费 API token,地址:
developer.amd.com.cn
Radeon Cloud
看了下是 AMD GPU Cloud 承载的,OpenAI 兼容接口,理论上 Cherry Studio、NextChat 这些直接填就能用。
目前公开免费的模型有 4 个:
- DeepSeek-V4-Flash-0731(文本)
- DeepSeek-V4-Flash-Vision-Exp(视觉)
- Qwen3.8-Flash-Next(视觉)
- MiniCPM5-1B(文本)
看着阵容还行啊,DeepSeek 加 Qwen 都有,还带视觉。
不过免费池嘛,最大的疑问就是稳定性和速度了,所以想问问已经申请的佬:
- 断流厉不厉害?长文本输出会不会中途卡死?
- 有没有隐性限速 / 限并发?高峰期排队吗?
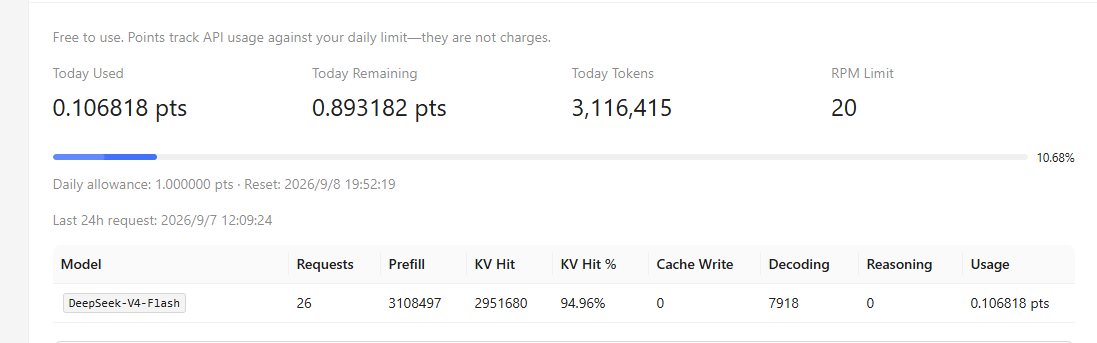
- token 额度给多少,用完了还能再领吗?
- 日常当个备用 API 够不够用?
没用过的也可以先上车,申请入口就在上面那个链接,注册完领 token 就行。有体验的回来吼一声,给后面的人踩踩坑。
主楼  lu29053632026-09-07
请求限制RPM20,而且吐字太慢了,慢得怀疑人生。严重怀疑每天送的额度能不能用完。你能接受的话就凑合,不能接受还是算了
- 龟田彭一郎2026-09-07
他家的dsv4f和dsv4fv 老是窜会话经常有些莫名其妙的token到会话里面
- doler2026-09-07
感觉不错,但是每个账号每天只有1000来万的token
- 酷睿哥2026-09-07
- Tokojo2026-09-07
降智,量化,上下文短,非常不建议用
- 星辰的光2026-09-07
有点废啊 只能打杂 并发不用想直接给你限制 而且都是量化啦 上下文气短无比
- THW2026-09-07
非常难用,不仅速度不稳定,V4-Flash还经常胡言乱语重复输出
- yurita_shaw2026-09-07
- 阳光之夏2026-09-07
不太好用,就是多个 K 轮换的话,使用网关来切换,但是总体成任务就很难受了。