- 桑榆2026-09-10
公众号官推:
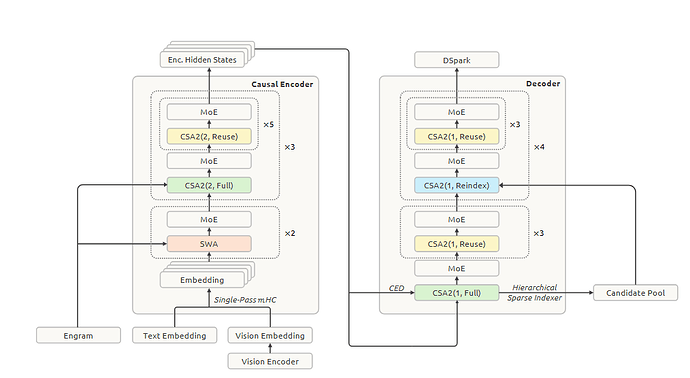
注意^-^,DeepSeek V4.1 Flash 为 552B 参数的 MoE 模型,采用了全新的 Causal-Encoder-Decoder 结构,输入和输出不对称,输入激活只有 8B,输出激活 16B,成本显著低于已知的同尺寸模型。
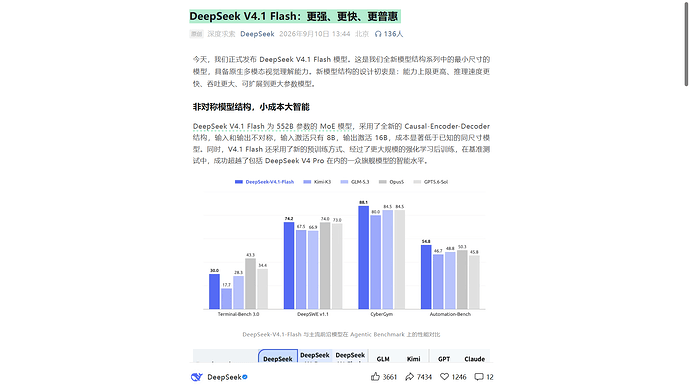
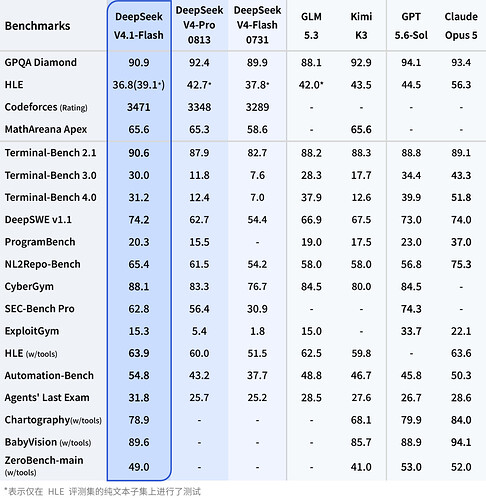
同时,V4.1 Flash 还采用了新的预训练方式、经过了更大规模的强化学习后训练,在基准测试中,成功超越了包括 DeepSeek V4 Pro 在内的一众旗舰模型的智能水平
官方测试: 多项能力已经超过了
GLM5.3、Kimi k3等模型。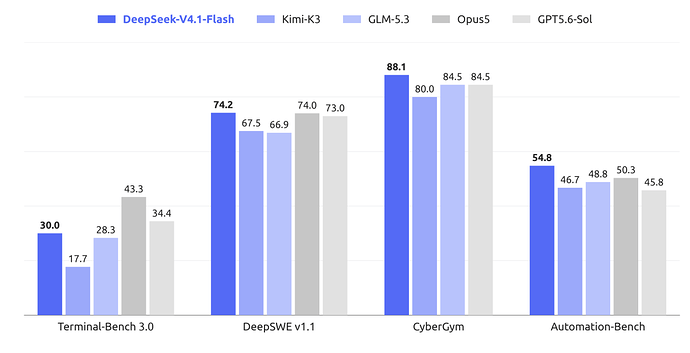
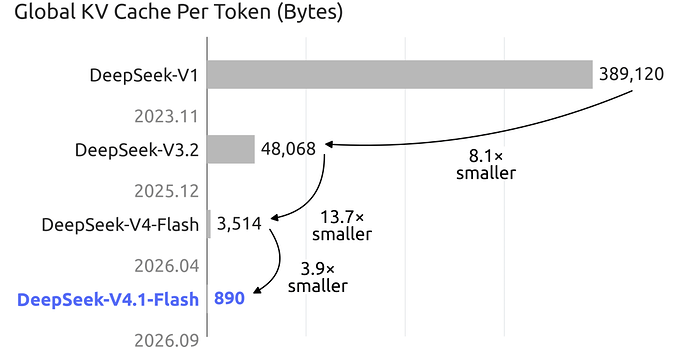
此外,该模型更少缓存,更省成本!!
新一代模型大幅减少了 KV Cache 缓存的大小,与上一代模型相比,对 HBM 的需求减少到 1/4,对 SSD 的需求减少到 1/8。
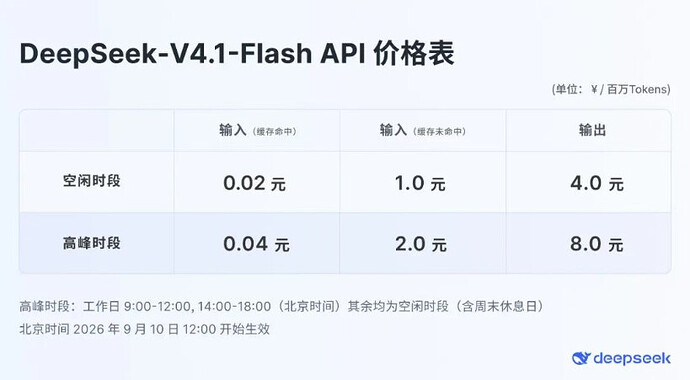
API 定价调整
新价格于 2026 年 9 月 10 日 12:00 开始生效。
官方开源链接:
- 模型开源链接:
deepseek-ai/DeepSeek-V4.1-Flash · Hugging Face
- 论文链接:
DeepSeek_V41_Tech_Report.pdf · deepseek-ai/DeepSeek-V4.1-Flash at main
主楼 - 海獭为什么叫海獭2026-09-10
- 桑榆2026-09-10
- 海獭为什么叫海獭2026-09-10
- Sam_Altman2026-09-10
在梁子把 coding plan 端上来之前暂时不将其升级为梁圣
- gordontsm2026-09-10
用过的佬有没有分享一下体感的,不看广告看疗效