- 曦岚2026-08-30
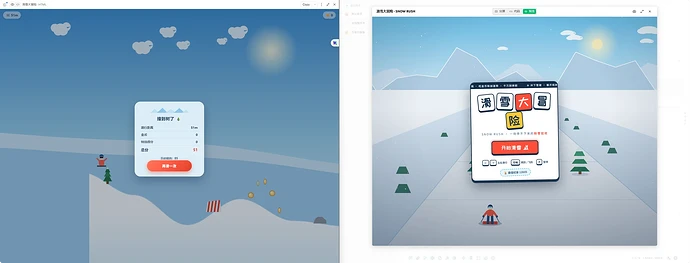
最近在测试海光 K100_AI 上部署的 Qwen3.8-27B,顺手拿 Claude Sonnet 5 Max 做了一次非常简单的单提示词对比。
测试提示词只有一句:
帮我写一个滑雪大冒险的小游戏,HTML格式。没有补充 UI 风格、配色、布局、功能清单等额外要求,基本就是看模型自己对需求的理解、设计和发挥。
左侧:Claude Sonnet 5 Max
右侧:Qwen3.8-27B
Qwen3.8-27B 是部署在 海光 K100_AI 上的 W8A8 INT8 推理版本,Activation / KV Cache 使用 BF16,使用定制 SGLang 推理服务,模型上下文按官方原生 262K 配置。
从这一次生成结果看,比较让我意外的是 Qwen 右侧版本在视觉完成度上反而更高:雪道透视、远山、树木、太阳、主菜单以及整体画面层次都比较完整,更接近一个已经设计过的小游戏页面。
Claude 左侧版本功能同样能实现,但这一轮生成的视觉表现相对简单一些。
当然,这里只是同一句 Prompt 的单次生成结果,并不能证明 Qwen3.8-27B 综合能力超过 Claude Sonnet 5 Max。随机采样、思考档位和任务类型都会影响结果。
但至少从这次测试来看,K100_AI 上运行的 Qwen3.8-27B W8A8 在这种「一句话生成完整前端/小游戏」任务上的实际完成度,确实比我原先预期的高不少。
后面准备再固定一批相同 Prompt,对比代码质量、视觉效果、首次成功率、生成耗时和 Token 消耗,避免只看单次样本。
大家觉得左边 Claude 和右边 Qwen,哪一个效果更好
主楼 - 曦岚2026-08-31
- 曦岚2026-08-31
疯狂喷气机-复刻+滑雪大冒险-SNOW-RUSH.zip (25.9 KB)
- JimmyLi2026-09-11
最近意外拿到一组8卡K100_AI,计划部署,直接用社区里面的部署方法就行了吗,sglang比vllm更好吗,8卡最好的办法是每张卡都加载一份模型吗,这个卡能正常用dflash2吗
- 曦岚2026-09-11
- JimmyLi2026-09-12
四张卡加载一份模型,速度会受到pcie的严重限制吧