- sun_of_beach2026-10-01
省流版:(基于以下评测)
- 最新模型Opus 5.5,GPT-6.1 Sol 的确效率高,但思考强度选Medium就好, 效果好还省钱
- 穷逼严选:GPT-6 Luna +思考强度Max
- 国产看看Kimi K3和GLM 5.3 flash
评测原文: FrontierCode Leaderboard | Cognition
以下为手写版。AI润色版稍后发公众号。
Cognition公司(Devin开发商)发布了其FrontierCode 1.1的最新排行榜,加入了新鲜出炉的GPT-6.1 Sol以及Claude Sonnet 5.5的评测结果。
FrontierCode专注于代码正确性和代码质量,也是第一个衡量可合并性的基准:代码维护者是否愿意合并这个AI生成的PR?
我们的标准使用一系列评分技术(包括单元测试、评分标准和新型验证器)来评估端到端代码质量(正确性、测试质量、范围规范、风格和对代码库标准的遵守情况)。
每个任务都由其所属开源仓库的维护者精心打造:20 多位世界一流的开发者构建了真实、多样化且具有挑战性的任务,每个任务耗时超过 40 小时,并且他们定义了各自仓库中“可合并”的含义。由于评分标准具有主观性,我们构建了一套完善的质量控制流程,包括对抗性测试、校准和多阶段审查,其中每个任务都由认知研究员进行人工审核。
FrontierCode还限制了互联网的使用。模型可以像工程师一样使用互联网,例如阅读文档和搜索错误信息,但任何访问包含解决方案的来源(例如原始拉取请求)的运行都会被检测到,并被评为零分。
除了给大模型的代码质量打分之外,该评测也列出了任务平均token费用,让我们来看看目前哪款模型“质价比”最高?
先上一个评测结果全家福。纵轴为根据评分标准各项指标的加权总分,横轴为每次任务的平均美元支出。即左上角的模型效率最高,右下角最低。
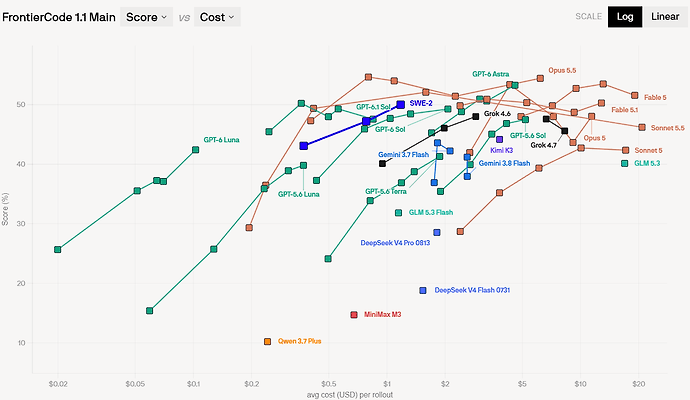
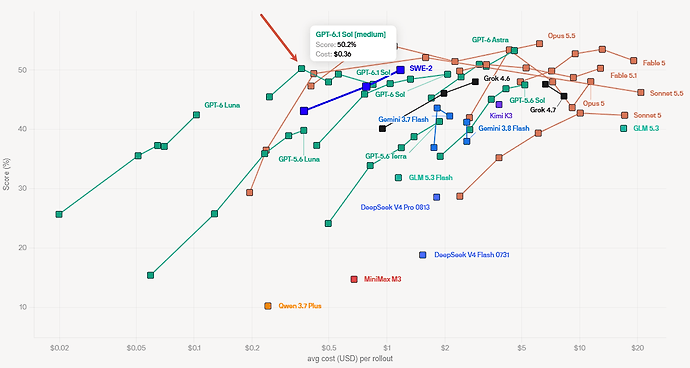
从这份评测结果里我们首先可以获得一个反直觉的结论:模型思考强度越高token消耗一定更多,但代码质量未必更好。比如Opus-5,Opus-5.5,GPT-6.1 Sol等模型的Medium思考强度都比Max分数更高,任务费用也更低。
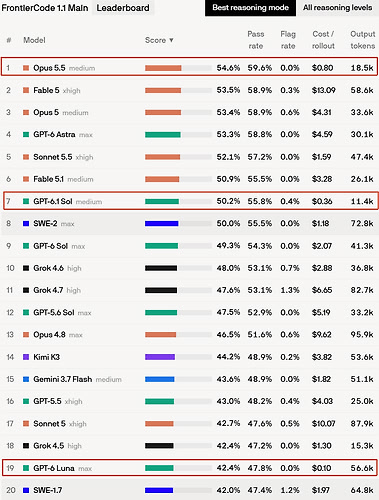
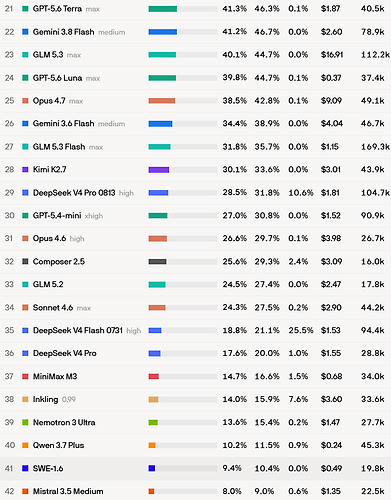
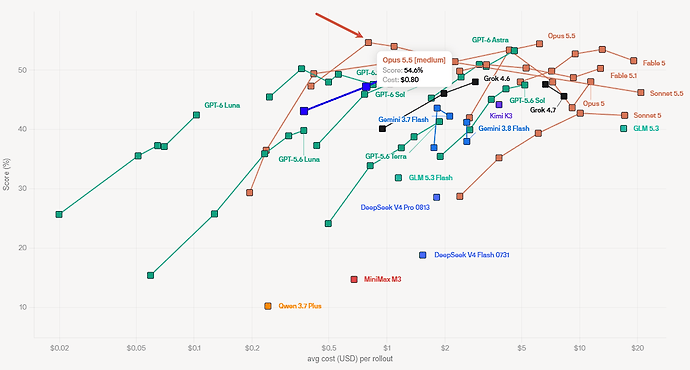
第一梯队:Opus 5.5 medium以54.6%的最高分略微领先GPT-6 Astra max,从分数上看差距很小,而且Opus 5.5 思考强度为medium,平均费用仅为GPT-6 Astra max的17%,质价比不可思议的断层领先。
A社其他模型:Sonnet 5.5相比Opus 5.5似乎并不划算,唯一值得一用的是Sonnet 5.5 high,得分落后Opus 5.5 5个点,但费用节省一半。Fable 5/5.1目前已不值得使用,得分被Opus 5.5压制,且费用高很多。
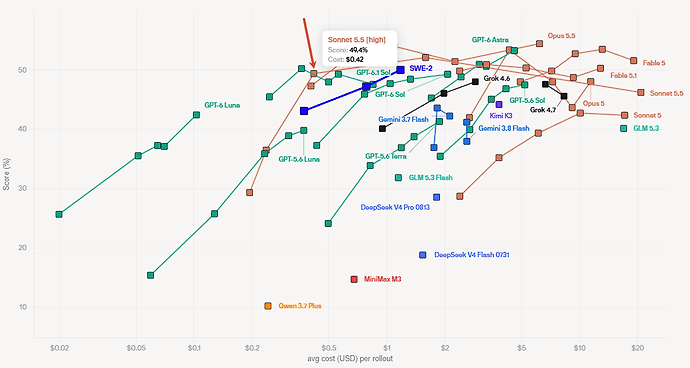
再来看看OpenAI家:GPT-6.1 Sol medium的表现在第二梯队非常抢眼,平均费用显著低于分数更低的众多模型。 虽然分数比GPT-6 Astra max低一些,但是费用只有前者的8%啊,还要什么自行车。
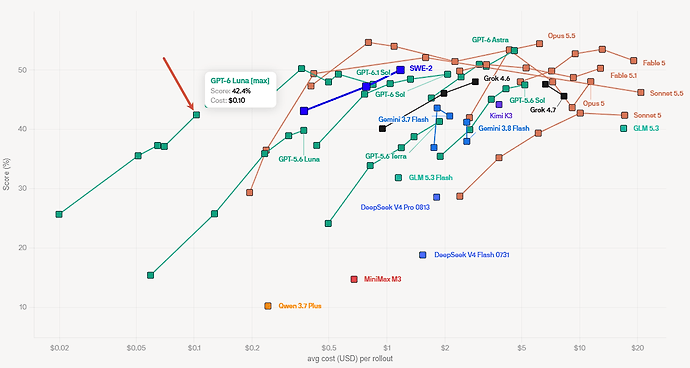
而在成本敏感的场景,GPT-6 Luna max则是秒杀一切的存在,以全场最低的$0.1平均运行费用牢牢把控得分排行榜的中段位置。
Gemini和Grok家则都出现了新模型退步的状况。Gemini 3.7 Flash好过Gemini 3.8 Flash,Grok 4.6好过Grok 4.7。还是期待一下Gemini 4 pro能否有惊喜吧。
至于国产模型,目前的最强者是Kimi K3,能力略逊于Opus 4.8 max但强过GPT-5.5 xhigh 和 Sonnet 5 xhigh,费用也有一定的优势,值得鼓励!
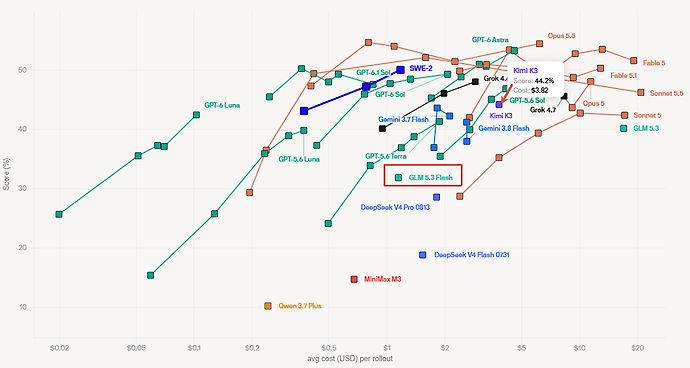
GLM 5.3 flash Max分数为31.8%,平均花费$1.15,在国产中有一定性价比。
其他几位选手表现就不不尽如人意了,GLM 5.3 max偏贵,Deepseek,MiniMax M3得分较低。可惜的是,评测中并未加入最新的Deepseek v4.1 flash以及Qwen 3.8。另外评测时国产模型采用的都不是自家的Code CLI,也可能一定程度上影响分数。
最后总结一下,根据这份评测推荐编程模型如下:
- Anthropic 用户:优先考虑 Claude Opus 5.5,推理强度选择
medium。- OpenAI 用户:优先考虑 GPT-6.1 Sol,
medium模式在成本和质量之间取得了较好平衡。- 成本优先:可以考虑 GPT-6 Luna,使用
max模式获得极低的单次任务成本。- 国产模型:优先关注 Kimi K3;对成本更加敏感时,可以考虑 GLM 5.3 Flash。
主楼 - mi_tu2026-10-01
这个跑分榜和隔壁cursor的榜感觉对照着看很有用,比livebench之类的榜单参考性强多了
之前就是看cognition的swe1.6的文章说rl带来的雷霆思考会带来很多缺点,swe1.7的文章说思考等级越高pr质量越差之类的,给自己的模型降了几个等级发现体感确实更好了。(不过swe2max的雷霆思考依旧逆天)
每次发新模型都一堆有用的前沿知识和解释,跑分榜的场景也最贴近我。