- Hao-linuxdo2026-07-19
恢复方法
- 从
openai/codexGitHub 仓库下载codex-rs/models-manager/models.json文件放置到本地,例如~/.codex/models.json- 修改
models.json文件中 gpt-5.6-sol/terra/luna 模型的context_window和max_context_window字段为 372000- 在
~/.codex/config.toml中配置绝对路径,例如model_catalog_json = "/Users/你的用户名/.codex/models.json"效果如下:
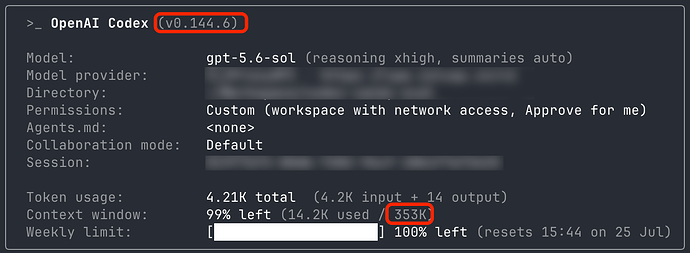
提醒:该方法可行基于 OpenAI 暂时没有调整后端 gpt-5.6 系列模型的上下文限制,如果 OpenAI 把后端也调整了,这种方法将会失效,并造成上下文溢出(context_too_large)的错误。
原话题内容
更新 Codex 后使用 gpt-5.6-sol 时上下文从之前的 353k 下调到了 258k
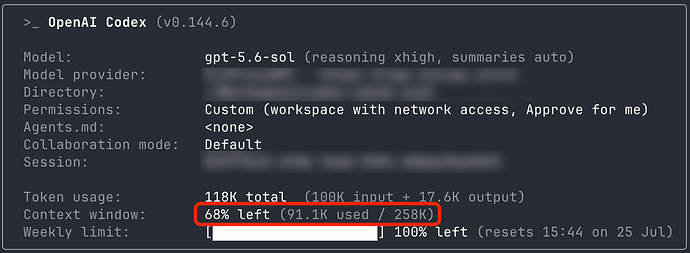
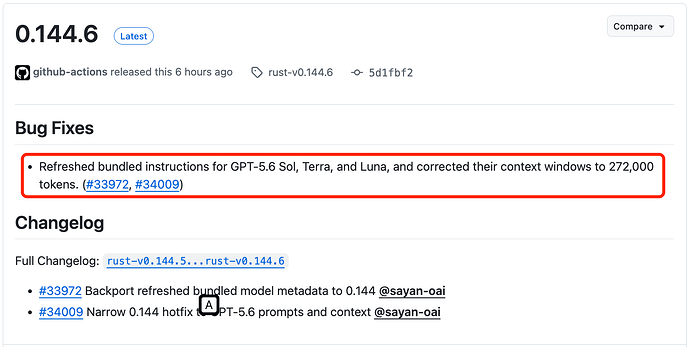
GitHub 更新日志显示,Codex 在 0.144.6 版本中将 gpt-5.6 系列模型 context window 修正为 272k,保留 5% 的冗余后,就是 258k ≈ 272k * 0.95,跟 gpt-5.5 模型一致
corrected 这个词用的妙啊,难道说之前提供 372k 上下文是个 bug ^-^
但实际测试反代出来的 API 接口发现,输入仍然可以超过 272k. 如下,可以看到,输入达到了 350k,仍然获取到了正常输出,而不是报错。```
{"input_tokens":350340,"input_tokens_details":{"cache_write_tokens":0,"cached_tokens":0},"output_tokens":5,"output_tokens_details":{"reasoning_tokens":0},"total_tokens":350345}
``可惜,并不能通过修改 config.toml 配置文件中的model_context_window将上下文恢复为 353k. 因为 Codex 源码中是min(model_context_window, 272000) * 0.95`.主楼 - Hao-linuxdo2026-07-19
如果他们不调整 Codex 后端 API 限制,那么通过 CPA 反代接入 opencode 之类的第三方 Harness 将可以继续使用 372k 上下文。 ^-^
- wereiyou2026-07-19
挺好的,我实在是接受不了272k的上下文了,太容易折叠了
- Hao-linuxdo2026-07-19
也不太好,用 Codex CLI 的话,除非直接修改 Codex 源码中的模型配置文件,否则突破不了 272k,不知道修改这个需不需要重新编译 Codex
另外可能过不了多长时间后端 API 也会调整相应的限制
- Hao-linuxdo2026-07-19
还真可以手动恢复,详情看我更新后的话题内容 ^-^