- joker20403252026-07-15
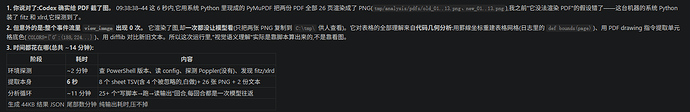
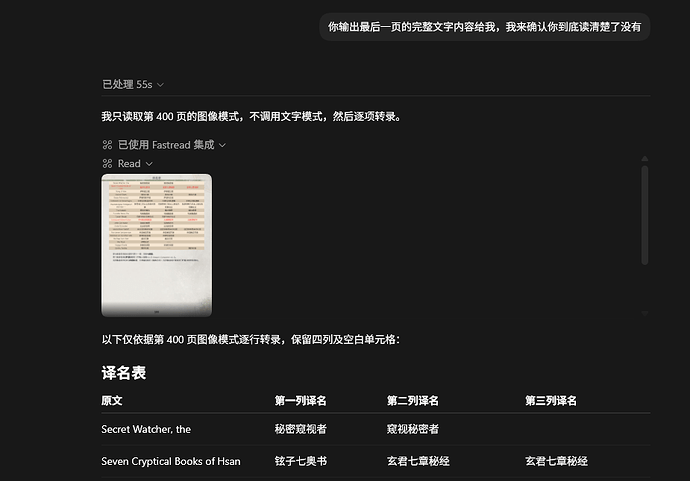
为什么我将两份PDF交给他让他输出差异,但是我让Claude Code分析CodeX的过程,说CodeX并没有去查看由PDF渲染出的图片的过程,而是直接解析的文字文本内容
主楼 - 初九猫2026-07-15
你需要明文规定,他才会动用视觉能力,一般来讲他还会先转成图片然后再看
- FhZ2026-07-15
直接给图片是可以识别的,PDF还没有试过。
- joker20403252026-07-15
- MotorwaySouth2026-07-15
- lan2026-07-15
pdf分3种情况,
1、可编辑模式:文字表格都是原始状态(可以不用视觉)
2、栅格化模式:文字全部变成图形(需要视觉)
3、位图模式:都是图片(需要视觉)
再说明下,codex是工具,如果是原始的gpt模型那就是多模态的。
- wxk6662026-07-15
佬你使用的是什么模型呢?如果是gpt模型就是有识图的能力的 如果是第三方模型建议去官方/中转站的模型广场 看一下是否有视觉能力
能否识图和codex无关 codex只是个调用模型api的软件 得看模型
- joker20403252026-07-15
谢谢佬的解答,用的就是官方的GPT模型
- MotorwaySouth2026-07-19
本帖使用社区开源推广,符合推广要求。我申明并遵循社区要求的以下内容:
我的帖子已经打上 开源推广 标签: 是
我的开源项目完整开源,无未开源部分: 是
我的开源项目已链接认可 LINUX DO 社区: 是
我帖子内的项目介绍,AI生成、润色内容部分已截图发出: 是
以上选择我承诺是永久有效的,接受社区和佬友监督: 是以下为项目介绍正文内容,AI生成、润色内容已使用截图方式发出
没有太多好…