- 你这是违法行为2026-07-19
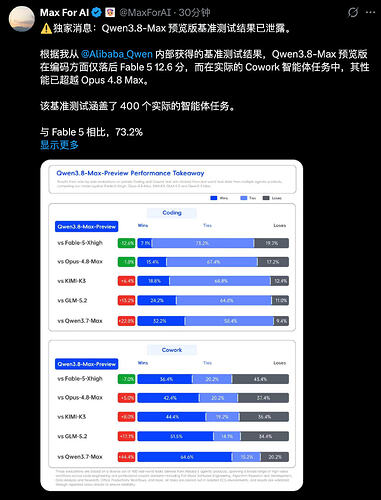
Qwen3.8-Max 预览版在编码方面仅落后 Fable 5 12.6 分,而在实际的 Cowork 智能体任务中,其性能已超越 Opus 4.8 Max。
该基准测试涵盖了 400 个实际的智能体任务。
与 Fable 5 相比,73.2% 的编码任务结果相同。
在 Cowork 任务中,Qwen3.8-Max 领先:
- Opus 4.8 Max:5 分
- Kimi K3:8 分
- GLM-5.2:17.1 分
- 上一代Qwen3.7-Max:44.4 分
而这仅仅是预览版。
消息来源称,一些已就绪的改进尚未部署,最终版本会更强大。
Qwen3.8 现在的目标是 Fable 5,Opus 已经被超越了。
 主楼
- Fulaf2026-07-19
这是要赶英(没有英)超美了吗,超过了我们还会有便宜的大模型吗()
- QYY2026-07-19
千问是多模态的嘛,那和国外闭源园模型也就差几个月
- listening2026-07-19
3.8 max是多模态,看起来还有价格优势。
- 西门卤蛋2026-07-19
跟我的实际使用体验完全不一样啊,神秘benchmark,不知道是因为后训练不足还是harness不行,总感觉给他的指令它常常糊弄一下就给我了,不会认真地去审查.
- Cyrene2026-07-19
这就是真实AI大战,你追我赶,Fable一发布,马上就有两个模型以Fable为真实目标了,先前积攒的优势可能在几个月后荡然无存
- 小鳥遊みふる2026-07-19
我也觉得很怪 让他搜索二次元人物的信息,强调了汉字还是给我一堆假名的 而且慢的不行一个任务就是十多分钟起步
- linjinpeng2026-07-19
这个模型我测试的时候感觉一坨,结果实际用起来居然还不错
- Amamiya2026-07-19
(帖子已被作者删除)
- TheYesNo2026-07-19
期待实战效果,不知道实际使用起来怎么样,分数不能代表全部
- SugarBreeze2026-07-19
- 吹散的云2026-07-19
我看B站上的测试结果说后训练没做好,没有宣传的效果好
- 24岁是白给2026-07-19
- YG88772026-07-19
看推特目前的“反馈” 貌似拉了一坨 ^-^
- outgoing2026-07-19
怎么没过几天glm-5.2就被打成路边一条了