- iamyx332026-07-15
先上演示视频(建议调低音量)~
您的浏览器不支持 HTML5 video 标签。
一、梦开始的地方
去年我在社交媒体上偶然接触了豆包输入法,便立刻被它的语音转文字的高准确性所惊讶。相较于传统的讯飞等输入法,它不仅能够识别轻声说话,而且能自动纠正专有名词等学科内容,还包括:
- 停顿时修正前面的文字
- 专有名词自动纠错
- 融入了 AI 模型的拼音联想
- 等等
于是,它成了我电子书上唯一的输入法(学校禁止带手机,电子书是我暂时合规的电子设备)。在我的学习过程中,它为 AI 输入提供了重要支持。
(学校食堂+研究题目)
在我的学习工作流中,有一项便是通过课堂的文字转写,调用 GPT 5.5 Pro 生成整堂课的完整整理补充与回顾。
但豆包输入法天生不是为长时间记录设计的。要录整堂课,我以前用腾讯会议做语音转文字每天得重复同一套流程:创建会议、检查麦克风、隐藏主界面、下课后下载转写。而且识别准确度远不如豆包输入法。
“你能不能,好好听一次我说的话。”
——木苏里《某某》
我试过接入豆包语音 API。效果当然好,体验也一致,但每天连续几小时的课堂转写,长期费用不是小数。于是我想:
手机上的输入法已经把这件事做得很好了。我能不能理解它完整的工作方式,然后把同样的产品思路搬进自己的学习工具?
二、逆向!
细节决定成败
在开始这个项目之前,我使用这个输入法大概有半年之久,也在逐渐思考:
- 连续说话和中间停顿时,结果的更新方式有什么不同?
- 松手后为什么还会显示"识别优化中"?
- 临时结果、稳定结果和最终结果之间,哪些文字会被覆盖?
- 加入个人词之后,多久能影响识别?
- 断网、弱网、切换应用时,状态怎么变化?
“最大的盲点,其实就是站在中心的自己。”
——八月长安《你好,旧时光》
用 AI 辅助逆向不能只下达一个模棱两可的指令,对产品的细致观察,方能保证功能实现的完整性。
站在前人的肩膀上
论坛里已经有佬友做过早期版本的复现,但对比官方客户端,语音转文字的质量明显下降了。不过通过这些宝贵的分析经验,我了解到了输入法的身份认证流程和设备注册方式。
静态分析
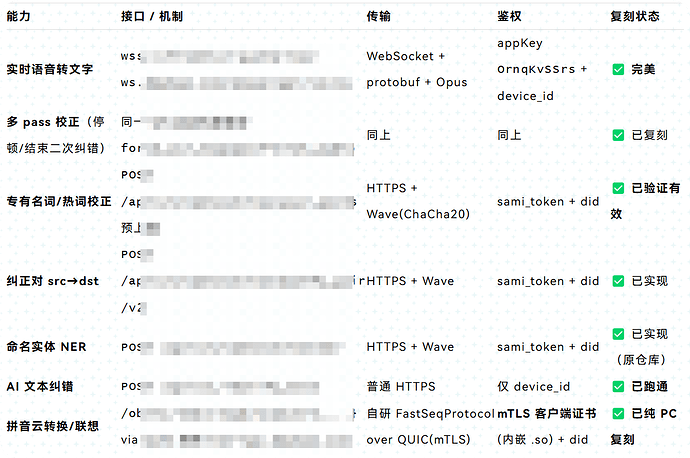
通过分析发现:新版的上层代码和原生 SDK 是分离的,包括:
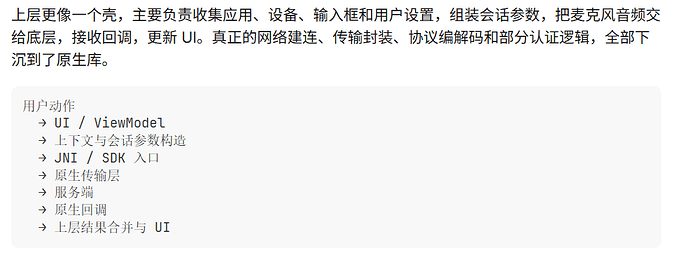
完整的生命周期
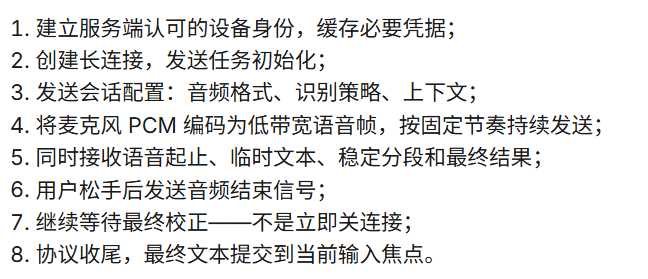
连接、发送、接收、麦克风和 UI 全部并发。正确而完整的时序,是保障识别准确度与完整性的基石。
上下文才是准确率的关键
第一次成功出字的时候我很兴奋,但很快发现长句、断句和专有名词跟官方差得远。
后来发现,准确的识别需要以下信息共同作用:
会话内上下文(本次识别时读取):
- 当前应用和输入框类型;
- 光标附近允许发送的文本。
会话外个性化资源(类似持久记忆):
- 最近输入或语音历史;
- 联系人、常用词等;
- 标点规范等用户设置的策略;
- 已经积累的纠正记录。
多次纠正
UI 和实测给了我明确的线索:
- 说话过程中文字不断被覆盖;
- 短暂停顿后,前一句又更优化;
- 松手后出现"识别优化中";
- 最终文本有时和松手前最后看到的版本不同。
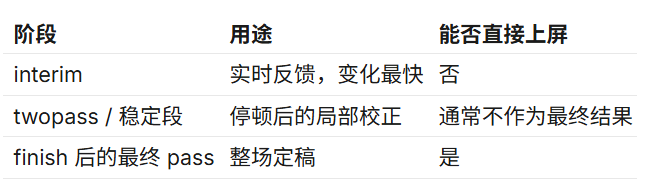
因此,在一次语音输入中,识别结果至少经过了三轮的优化:
云拼音
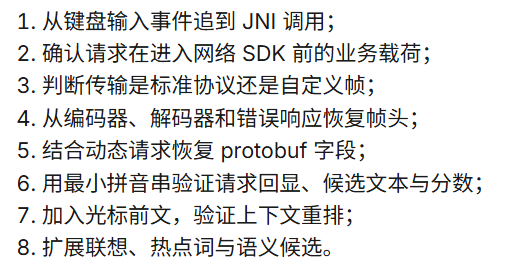
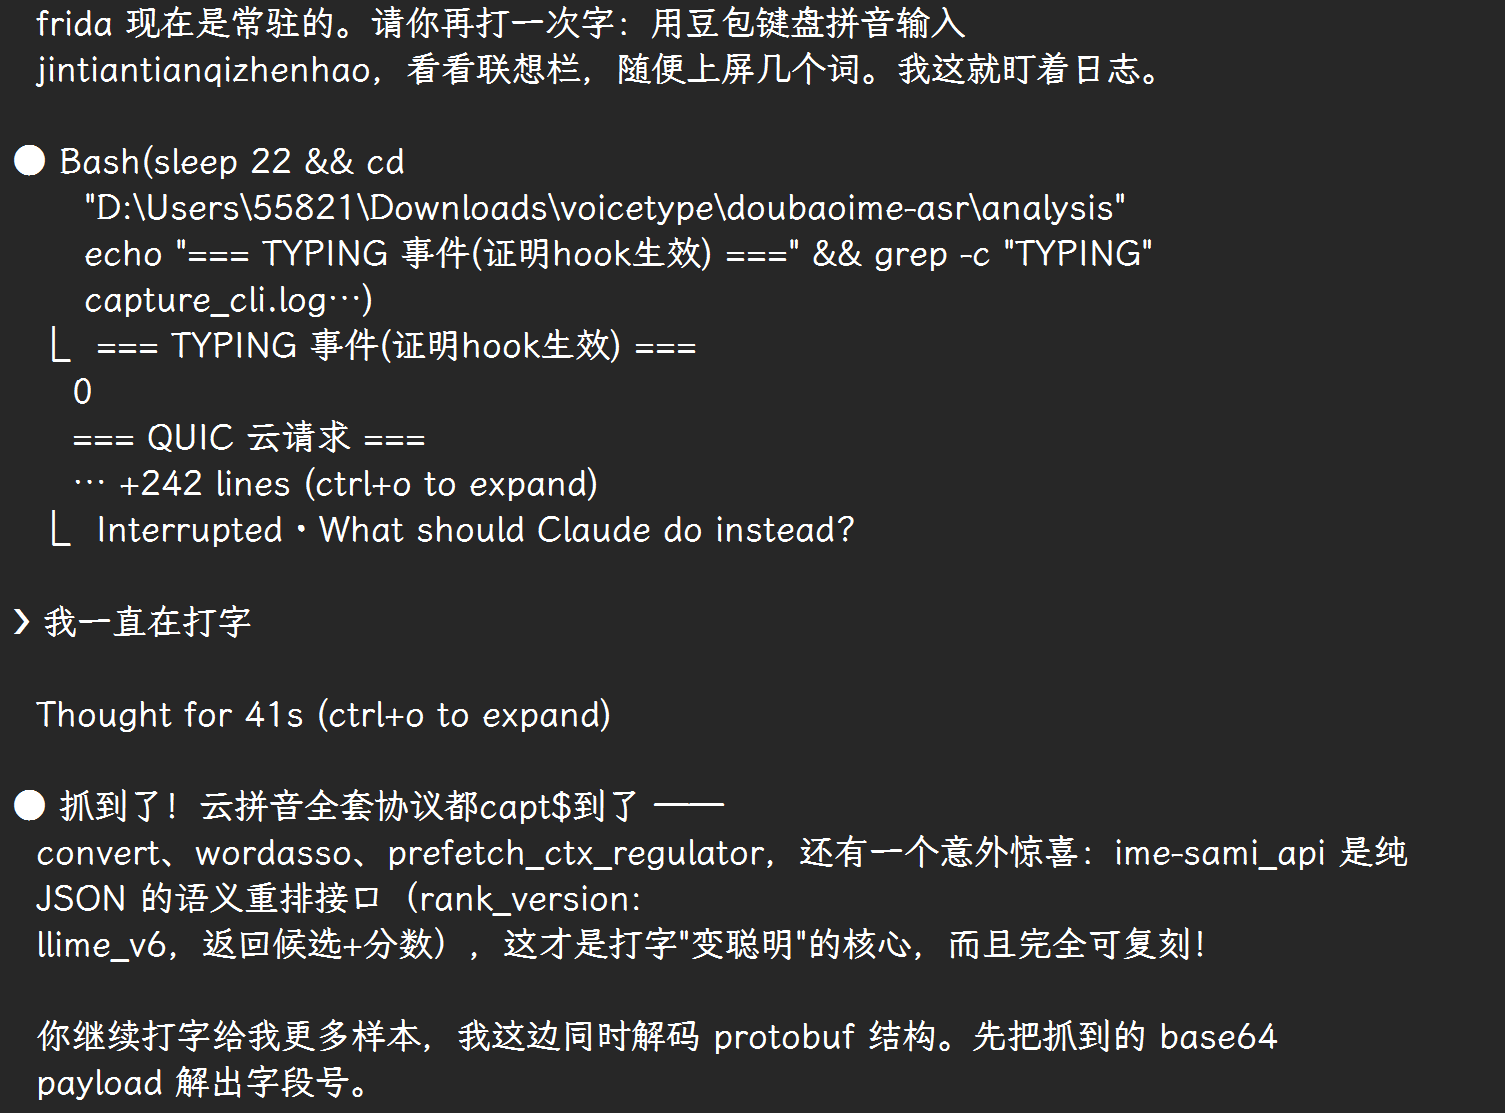
低延迟的拼音候选,竟然也是云端计算的。本质上是经过原生拼音引擎、网关封装、自定义帧协议,跑在基于 QUIC 的长连接上。
逆向思路大致是:
动态验证
“所有的东西都可以摆在明面上去推理,去验证。”
——稚楚《营业悖论》
反编译告诉我"可能是什么",真机运行才能确认"确实是什么"。
“你真的觉得我赌的是会不会踩空?我赌的是你会不会让我退第三步。”
——大风不是木偶《楚天以南》
动态验证的本质就是这种博弈。向服务器发送一个精心构造的请求,赌的就是它的校验逻辑会不会在拒绝我的同时,暴露出更深层的协议细节。
三、33 输入法:从协议复现到完整产品
“有谁重活一遍,人生路会是全然相同的呢?”
——肉包不吃肉《二哈和他的白猫师尊》
到这里,最初课堂记录的需求已经满足了。但看着 Windows 端"即将上线"的提示挂了很久,我想:为什么不自己做一个?
这里感谢 Codex 赠送的额度重置:)
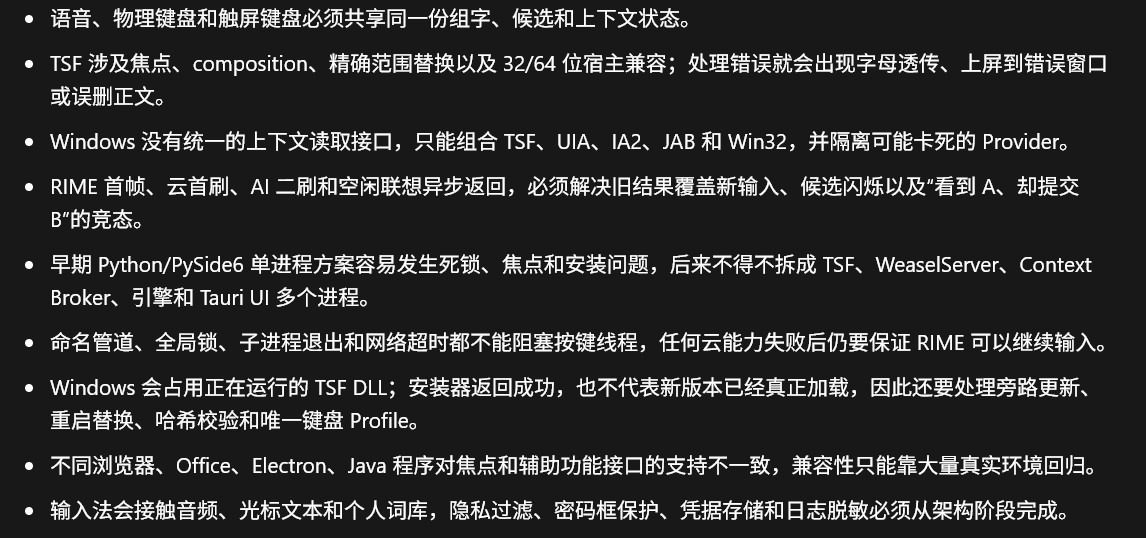
面对新的环境,所有输入的底层逻辑都需要重新设计。包括焦点附近文本的读取方式,如何在不同应用之间保证适配性,文字的插入应该使用什么 UI 自动化,如何将各类输入来源按照用户体验融合在一起…
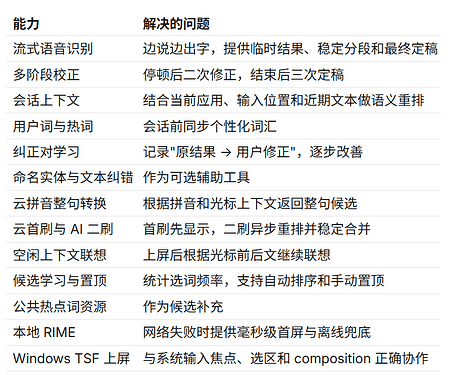
目前覆盖的能力
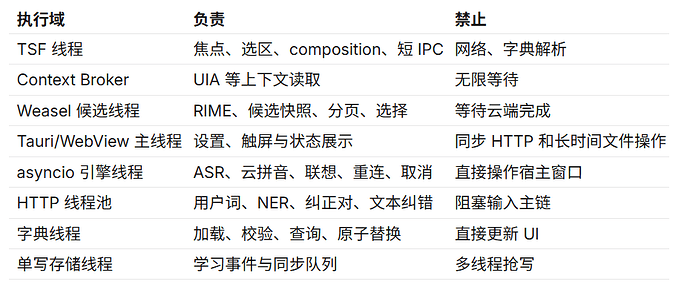
语音、物理键盘和触摸键盘共用同一个联想内核、同一份候选和同一套上下文,它们通过有机组合,减少资源占用。
架构分工
“门槛全部拆除,只留下一马平川的地面。”
——苍梧宾白《黄金台》
本项目的诞生,基于以下开源仓库 ^-^
- OpenLess:界面基础+输入模块
- RIME / librime:拼音引擎,键盘UI,断网输入等
程序的线程模型:
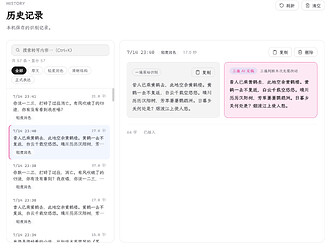
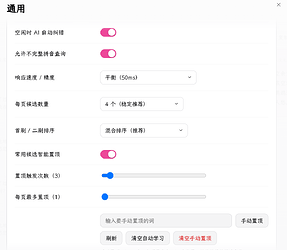
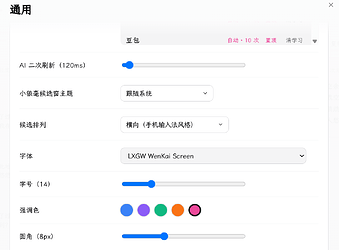
一些截图:
四,我的 AI 学习工作流
其中有一个项目是:```
课堂连续录音或转写
→ 得到老师的口语文字稿
→ 按课程与日期归档
→ 交给大模型整理
→ 生成结构化讲解、知识点、疑问和复习材料
```对生物,化学等高知识密度课堂来说,这一套总结方案更为实用。之前腾讯会议的版本对化学方程式的转写效果不佳,换上新版方案之后,转写准确率有了极大的提升。AI 逆向还带给我了很多,比如自动获取错题打印机的错题,一键发送给 AI 进行询问。比如自动打开回家的门锁免看广告..受限于篇幅,这里就先暂不展开了
五、对 AI 开发的拙见
从两年前逐句问"下一步该怎么办",到今天agent全天不间断运行,我越来越觉得,"立项开发"正在变成每个人都能掌握的能力。以前需要多人协作的探索,现在一个人梳理清楚需求,就可能借助 AI 做出原型乃至成品。
但 AI 的能力仍然受人的认知约束。
“人们只相信自己愿意相信的。”
——归鸿落雪《闲与仙人扫落花》
想要驱动 AI,首先得有一个任务。这个任务大多从生活中产生,也需要我们的丰富生活经验去精细化。没有考虑真实用户体验的任务,很难打动人心,而只有目标而未能细化的提示词,也可能会被幻觉所牵制。不论模型的强大与否,我们或辉煌宏大的的目标,或细致入微的洞察,始终是指引人工智能发展的一屋明灯。
结语
“没有谁的生活会一直完美,但无论什么时候,都要看着前方,满怀希望就会所向披靡。”
——巫哲《撒野》
高三的这一年弥足珍贵,学习也将占据我的几乎全部时间。为了防止失效以及规避风险,完整的豆包引擎将不会公开发布,但提供输入法框架供大家参考(写的很烂望佬友包涵 ^-^)
33-input-method-public-source-20260715.zip (3.9 MB)
感谢佬友们两年来的相伴,见证了我对 AI 从陌生到熟悉,从娱乐到融入日常学习生活的成长。
愿来年,山花烂漫时,回首已成诗。
主楼 - well2026-07-15
- 金亦求金2026-07-15
太牛逼了,我高三时不知道还是啥菜鸡呢
 ytong2211042026-07-15
后生可畏呀,nb 的佬,越来越产出更多优质干货 ^-^
- e0ir3bgo2026-07-15
高,高中生你好,很高兴以这样的形式认识你 ^-^
- fablia2026-07-15
- iamyx332026-07-15
- csgobad2026-07-15
没用过豆包,但有在用微信语音输入来vibe coding这比微信语音输入好吗?
- 一般路过不热心群众2026-07-15
- fffxue2026-07-15
你做了啥,这文字是不是ai写的,要记得修改润色。
- duolabmeng62026-07-15
这也太厉害了吧,我也要研究一下。
- lueluelue2026-07-15
太强了太强了,豆包输入法现在已经船大难掉头了,反馈个问题好久才能修,还不如自己做一个
- 23962026-07-15
感谢佬友分享!
我试过接入豆包语音 API。效果当然好,体验也一致,但每天连续几小时的课堂转写,长期费用不是小数。
对于这一点深有同感啊!对于我喜欢的 B 站、抖音视频。我也会把它们进行语音转写保存。但是接入 API 长期下来是昂贵的费用。
想问一下佬友能分享一下实现这个语音转写的过程与结果吗?
- CNDY2026-07-15
我去我正在做类似的项目就刷到了
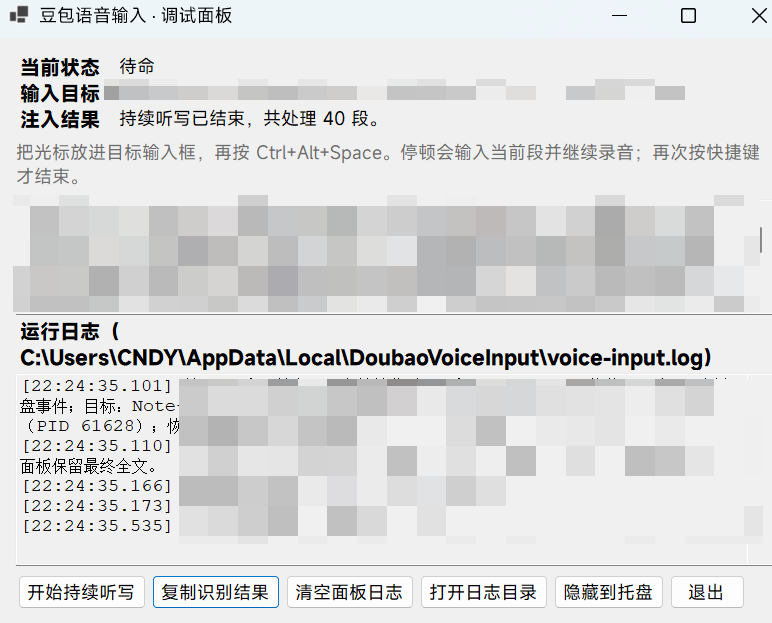
感谢佬分享
看了下 demo 延迟比调用火山流式api大
以及没有手机版/wx输入法那种实时转录+云端纠正,导致用户输入的时候不自信
如果这个能解决就更好了 佬能分享下这个地方的引擎吗
- 宇宙宙长2026-07-15
佬,你也是准高三呀,是山东的嘛(我是山东哒!!!)
- ccyd2026-07-15
太有实力了佬友,中间插入的句子看起来像双链笔记的联想功能,感谢分享^-^
- Bin2026-07-15
牛逼,这个真有版权问题吗?没有的话,我来做一个UI,做一个设计版。
- 南箕子2026-07-15
这是写了一套长时间语音录入的框架,然后调用的api是从豆包输入法反代出来的吗
- iamyx332026-07-15
- xinlang2026-07-15
佬站真是人才辈出啊, 重新让我认识了高中生