- buru-linuxdo2026-01-05
大家好!
如果你在使用 Claude Code、Cursor 时配置了多个 MCP服务,你一定能感受到上下文(Context)窗口的压力。
^-^ 痛点:被工具定义吃掉的 Context
Anthropic 官方曾在 Advanced Tool Use
技术博客中披露过工具定义的开销数据:
• GitHub: 35 个工具占用约 26,000 tokens
• Slack: 11 个工具占用约 21,000 tokens
这意味着,如果你同时开启这两个 MCP 服务,还没开始对话,近 50,000 tokens 就已经消失了。这不仅让 API成本激增,更会导致 AI 的推理能力因为背景噪声过多而下降,甚至出现指令遵循失败。
──────────────────────────────────────────
^-^ One MCP v1.0.1:两种方案帮你「减负」
One MCP 新版本增加了 服务组合 (Combo)功能
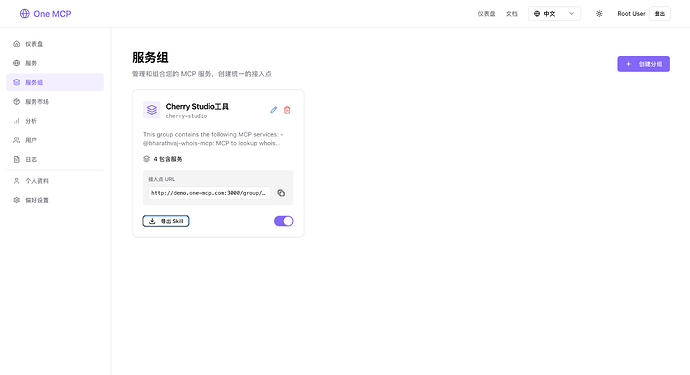
针对不同场景提供两种瘦身方案:
方案一:导出为 Anthropic Skill (推荐)
Anthropic 近期将 Skill 定为开放标准,旨在解决大规模工具定义的开销问题。我也在 OpenCode 和 Droid 上完成了实测,效果非常理想。
• 极低开销:AI 只读取一个精简的 SKILL.md(~500 tokens),替代数万 tokens 的 JSON 定义。
• 按需加载:工具详情只有在 AI 决定调用时才会被实时读取,完美适配 Anthropic 的官方实践。
• 零依赖:导出的 Python 执行器仅使用标准库,不需安装任何包,开箱即用。
• 广泛适配:完美支持 Claude Code / Droid / OpenCode 等支持 Skill 协议的客户端。
方案二:精简版组合 MCP (适用于传统客户端)
如果你的软件尚未支持 Skill 协议,你可以将 N 个服务组合成一个统一端点:
• 精简工具:Context 里只暴露
search_tools和execute_tool。• 动态调用:无论后台有多少工具,AI 的初始上下文里永远只有这两个入口。
──────────────────────────────────────────
^-^ 性能实测
以我测试的一个包含 4 个服务(24 个工具)的组合为例:
• 原生 MCP 模式:占用约 12,000+ tokens。
• One MCP Skill 模式:仅占用约 800 tokens。
Context 节省率达 93%! 把宝贵的 Context 留给代码和真正的逻辑。
──────────────────────────────────────────
^-^ 实战案例
- - 使用Skill(工具:OpenCode)
这个例子,我创建了一个cherry-studio工具的组合,包含exa,amap,whois等4个mcp,导出skill,再解压到
opencode的skill目录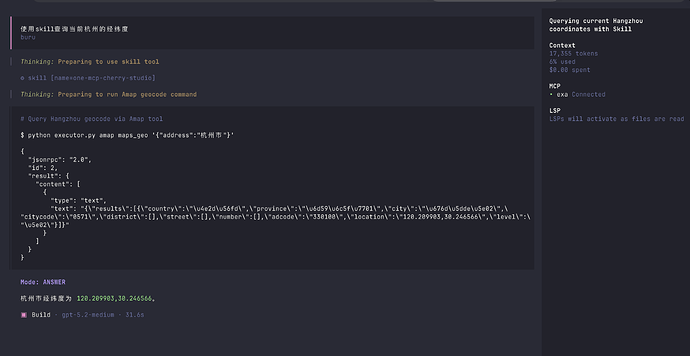
最终LLM按照skill.md的说明,使用python脚本调用了合适的mcp工具
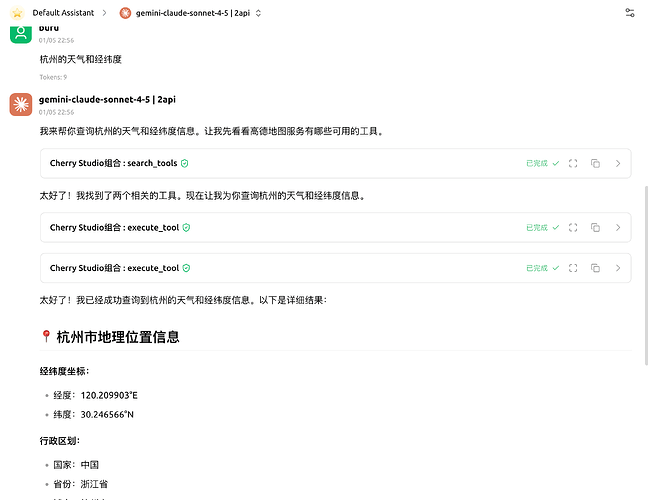
- - 使用组合后的MCP(工具:Cherry Studio)
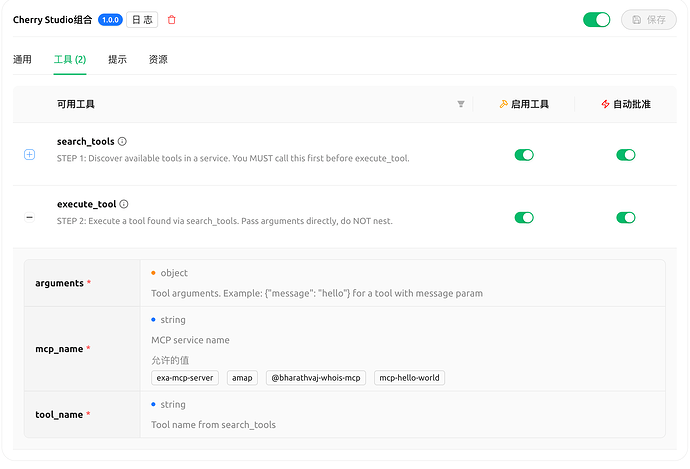
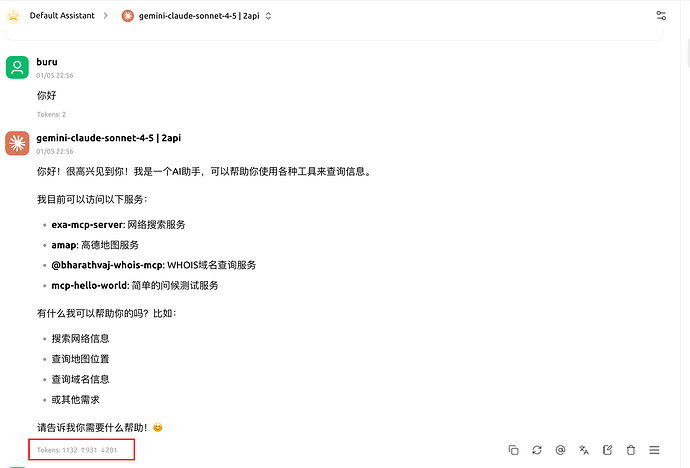
一开始只占用1000个token,然后查询时,这里会多调用一次查找合适的工具和参数
──────────────────────────────────────────
^-^ 快速体验
- Docker 一键启动:```
docker run --name one-mcp -d \
-p 3000:3000 \
-v $(pwd)/data:/data \
buru2020/one-mcp:latestAccess the application
Default username/password
root/123456
```- 在后台安装所需的 MCP 服务,创建一个「服务组合」。- 导出 Skill:点击导出 zip 包,解压到对应的 Skill 目录即可使用。
──────────────────────────────────────────
也可以登录我的demo站点创建skill体验:
Demo: https://demo.one-mcp.com/
项目地址
GitHub: https://github.com/burugo/one-mcp
欢迎 Star ^-^ 和试用,让我们一起终结 MCP 的 Context 焦虑!如果有使用上的问题,欢迎在评论区讨论。
主楼 - Mabel2026-01-05
- DKT2026-01-05
感谢佬友分享!
- ripotala2026-01-05
 fengchris2026-01-05
厉害了 还可以这么玩
- 木子米2026-01-05
已star!很有前景的方向
- monaicc2026-01-05
感觉很不错啊
- momo2662026-01-05
收藏了,后面试试
- 小小2026-01-05
感谢分享,一直在用
- 大帅哥2026-01-05
哇!感谢大佬!
- forward2026-01-05
AI 只读取一个精简的 SKILL.md(~500 tokens)
根据我实测,一个技能描述只占50左右的token
skill相关的系统提示是这样的,两个技能占用344字符,约等于100token,平均1个技能50token
以一个context7 mcp为例,提供两个工具占用3113字符,约等于889.4token
Only use skills listed in <available_skills> below
- Do not invoke a skill that is already runni… - buru-linuxdo2026-01-05
感谢star
- MIKUSCAT2026-01-05
已stars,这个看起来不错,最近被哈吉米的空回搞红温了,也许skills能解决问题
- Linus_Torvalds2026-01-05
太强了佬w
- dawn2026-01-05
先mark,看起来还不错
- 南山2026-01-05
有意思的方案,学习一下
- momo-linuxdo2026-01-05
看起来是,把 mcp 变成了 bash 脚本,用 skills 告诉工具什么时候调用什么脚本。感觉这个减少的 token 是只是因为 skills 的描述没有使用标准的 mcp 协议描述所以带来的减少。
- buru-linuxdo2026-01-05
是的,skill是渐进式披露,初始化只加载开头yaml的元数据部分
- antior2026-01-05
- 𝔸𝔼𝕍𝔸2026-01-05
实际上我只需要那个skiis.md文件就可以吧