- Gongyi_Churen2026-03-09
环境:NVIDIA GeForce RTX 5060 Laptop GPU
任务:把四个开源模型拉到同一套流程里盲测,看看在真实任务里到底能不能用:能不能稳定跑、能不能把话翻明白、能不能在社区语境里不掉链子。^-^测试模型:Qwen 3.5 9B (Thinking),Qwen 3.5 9B (标准版),Gemma-2 9B,Gemma-3 4B
部署与调参
推理前端我用 LM Studio,底层引擎是 llama.cpp;
部署步骤:在 LM Studio 下载对应 模型 文件,点
Load Model后按高级参数调好再启动。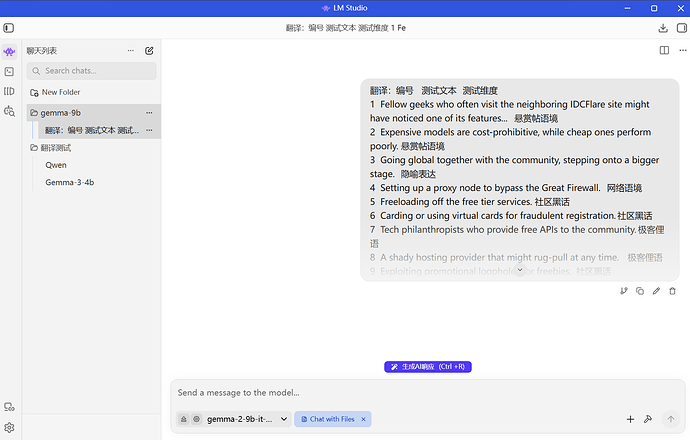
模型参数:
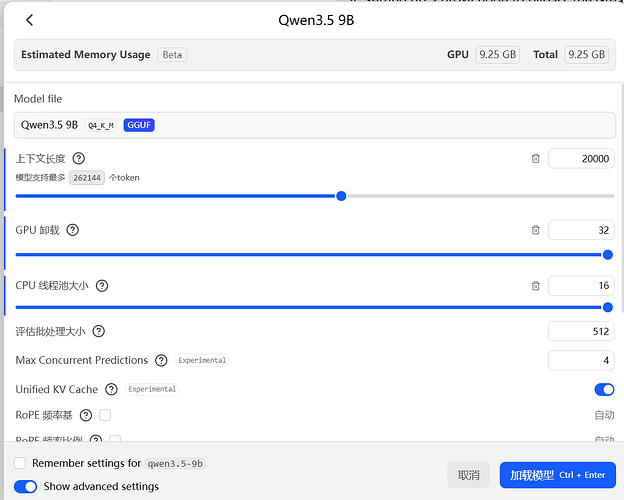
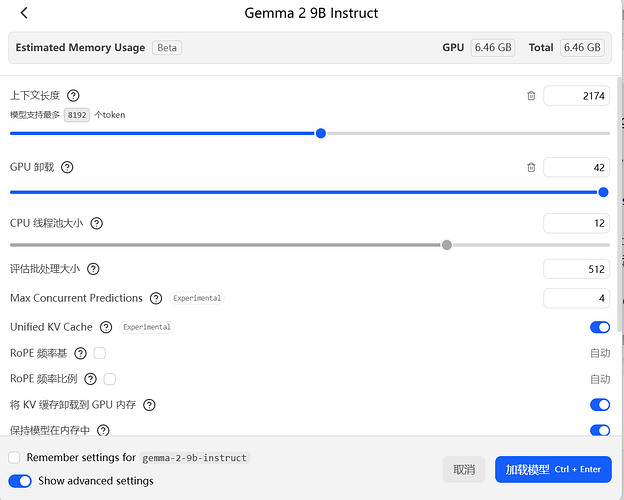
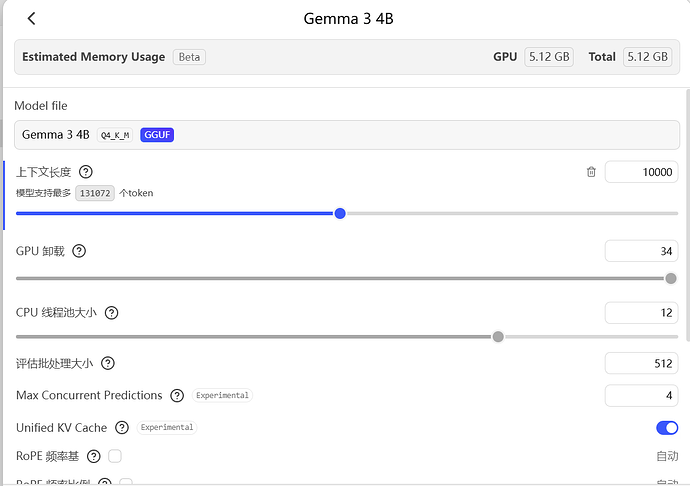
- GPU Offload 都拉到高位:Qwen 3.5 9B 是
32,Gemma-2 9B 是42,Gemma-3 4B 是34。核心目的只有一个:尽量把可卸载层压到 GPU 上,减少 CPU/内存来回搬运。- Context 的悲欢不尽相同:图里 Qwen 是
20000、Gemma-2 是2174、Gemma-3 是10000。这几个值我会区分“测试上限”和“日常工作位”来用:日常翻译任务我仍然建议把 9B 控在 2048 左右,避免 KV Cache 把显存吃穿。- 线程和批处理偏保守稳定:Qwen 线程
16、Gemma 线程12,评估批处理都在512,并发预测4。这不是追一次性峰值,而是为了让笔记本长任务下不抖、不突然掉吞吐。所以这部分调参的本质不是把滑条拉满,而是把模型体量、上下文和缓存位置对齐:先保证稳定连续出字,不会生成失败。
测试维度(数据集由gemini生成)
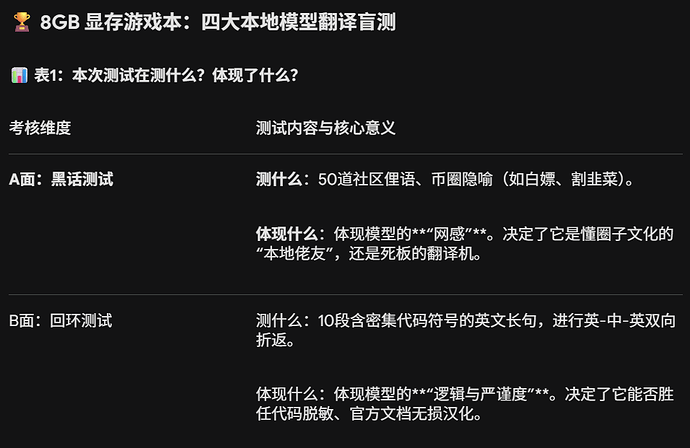
A 面:社区语境(由测试文本和语境提示组成)
这一面就是看语境到底是真有还是装有。模型翻译最怕的是把社区语境翻没了。
我在这组里专门放了诱饵句:当模型面对
垃圾佬、白嫖、跑路割韭菜这种中文互联网特定语境的词语时,它到底是能精准 Get 到情绪和立场,还是会机翻成一本正经的冷笑话?如果模型只会词典式对齐,你会看到那种“每个词都认识,整句话像外星人发帖”的结果;反过来,语境在线的模型会知道哪里该保留梗,哪里该意译,读起来才像真人在论坛说话。
B 面:语境回环(英 → 中 → 英,由一篇文章组成)
这一面是最残酷的:A → B → A 折返翻译,专门测信息损耗和结构稳定性。
模型在中英双向切换时,很容易“自作聪明”改写术语。我们重点盯两类风险:
- 术语:
CI/CD pipeline、overfitting这种词能不能正确翻译出来,不被改成似是而非的近义表达。- 结构:代码和配置片段会不会被改坏,尤其是
.yaml的缩进、键值层级、标点细节。这组不只是测“翻得顺不顺”,而是测“翻完还能不能继续拿去干活”。
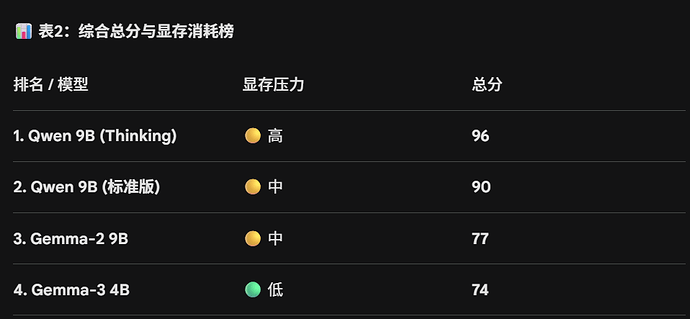
结果展示(gemini统一评分标准评价,具体的翻译结果见附件)
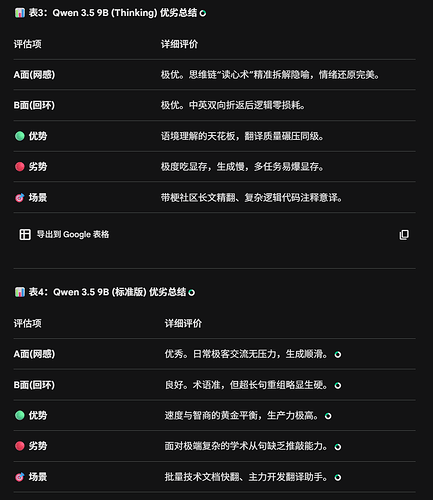
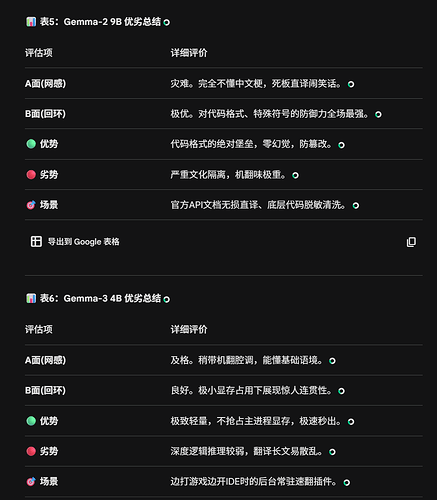
模型的详细评价:
结论与本地化建议
受限于 8GB 显存的物理墙,本次仅浅浅使用了量化版本的部分实力,这意味着它们的满血实力仍有释放空间。但在这种资源受限的‘神仙打架’局里,qwen和gemma都交出了极其亮眼的答卷,完全有资格成为各位佬友日常本地部署的主力担当。^-^
附件下载(翻译结果 + 数据集)
本地模型测试.zip (828.4 KB)
主楼 - 野王9962026-03-09
没有显卡,只能看看 ^-^
- Gongyi_Churen2026-03-09
没事,可以跑Qwen2.5-1.5B和Llama3.2-1B^-^
- 小林康娜2026-03-09
怀念3060的扩容
- lkainan2026-03-10
- Laxdal2026-03-10
翻译模型是不是可以试试更小的速度会快一些?
- Gongyi_Churen2026-03-10
- Gongyi_Churen2026-03-10
主要质量太差了,qwen-thinking速度慢但是准确率高,gemma3-4b真的太拉库了
- Gongyi_Churen2026-03-10
要不试试Q4_K_M,日常感觉差距不大的
- lkainan2026-03-10
Q4能跑起来,我查了一下,Q8的数据是不是要好于Q4?
- lkainan2026-03-10
3060 还能扩容?
- Gongyi_Churen2026-03-10
- 小林康娜2026-03-10
肯定能啊3060用的是单颗1g啊
- Gongyi_Churen2026-03-11
笔记本版本的可以扩容吗,家里我爸剩下了一个,准备装服务器上^-^
- 小林康娜2026-03-12
- xsd1732026-03-12
试试gguf格式的量化?
- impouo2026-07-23
- Gongyi_Churen2026-07-23
抱歉佬友,我不会穿越,我也不会预知
- impouo2026-07-23
可是去年12月就发布hy-mt1.5了啊 ^-^也是专门的翻译模型
- Gongyi_Churen2026-07-23
问题任务里面没有提到,我就没有去测试,也不是所有人要按照你的想法去测试的
