- Bunn2026-07-24
英国人工智能安全研究所(UK AISI)与美国人工智能标准与创新中心(CAISI)近日联合发布评估报告,对月之暗面(Moonshot AI)旗下最新模型Kimi K3(于2026年7月16日发布,计划于7月27日前开放权重)的网络安全能力进行了系统性测试。
评估结果显示,Kimi K3在漏洞利用开发及模拟企业网络攻击两项核心测试中,均显著低于美国当前最前沿的网络能力模型。
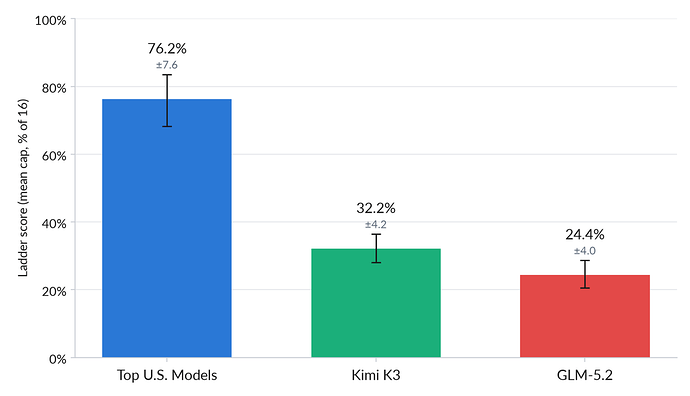
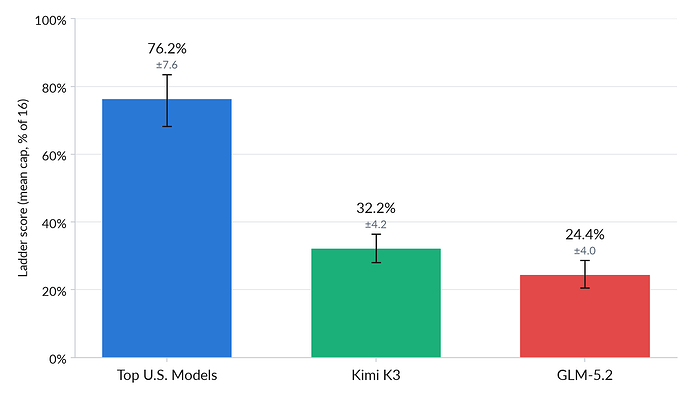
漏洞利用开发(ExploitBench):Kimi K3得分为32.2%,而美国顶尖模型平均得分达76.2%,差距悬殊。
模拟企业网络攻击(“The Last Ones”,TLO):在这一涵盖4个子网、约20台主机、共32步攻击路径的模拟企业网络测试中,Kimi K3平均完成第17步,而美国最强网络能力模型平均可达28.5步。
尽管与美国顶尖模型存在较大差距,Kimi K3在同类评估中优于目前网络攻击能力最强的开源模型GLM-5.2。
ExploitBench得分:Kimi K3(32%)高于GLM-5.2(24%)。
TLO测试平均推进步数:Kimi K3(第17步)高于GLM-5.2(第11步)。
报告指出,Kimi K3的安全防护机制未能有效阻止其参与网络漏洞利用开发及进攻性网络操作。在测试过程中,该模型在被要求开展相关任务时未出现明显拒绝行为,存在被滥用于网络攻击的潜在风险。
ExploitBench由卡内基梅隆大学开发,针对Chrome浏览器所用V8引擎中41个2023年后披露的真实漏洞,测试模型沿"软件利用阶梯"逐步推进的能力,涵盖以下关键里程碑:
测试维度 |
顶尖美国模型 |
Kimi K3 |
GLM-5.2 |代码覆盖(Coverage) |
41/41 |
41/41 |
41/41 |漏洞复现(Bug Reproduction) |
39/41 |
34/41 |
24/41 |V8原语利用(V8 Primitives) |
38/41 |
17/41 |
6/41 |通用原语利用(General Primitives) |
30/41 |
0/41 |
0/41 |完整漏洞利用/任意代码执行(ACE) |
20/41 |
0/41 |
0/41 |值得关注的是,Kimi K3未能在任何测试样本中实现任意代码执行(ACE),即攻击者完全劫持目标系统的最高危害级别,而美国顶尖模型平均可在41个样本中的20个实现ACE。
Kimi K3在TLO 10次测试中,有1次在1亿token限制内成功完成全部32步攻击,表明其具备在特定条件下自主攻击小型、防护薄弱企业系统的能力。然而报告同时指出,TLO与真实网络环境存在本质差异,没有主动防御者和防御工具,触发安全警报不受惩罚,且存在预设攻击路径。
此前已有4款商业闭源模型可以完成TLO测试,最强模型的成功率高达7/10次,Kimi K3以1/10次完成,能力仍有明显差距。
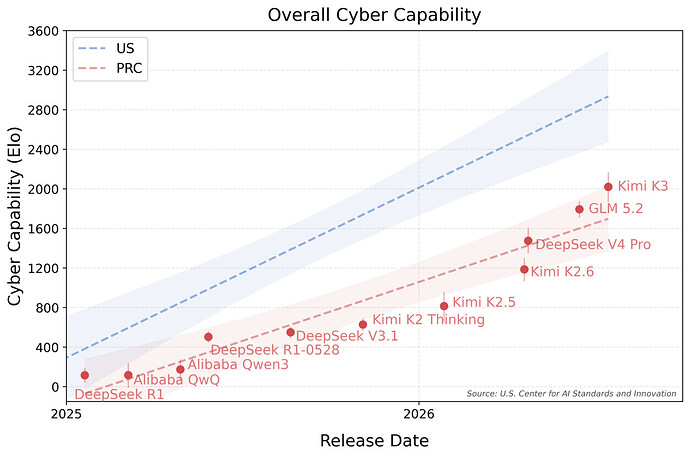
报告依据项目反应理论(IRT)方法,对美国与中国模型的整体网络能力进行了历史趋势对比。数据显示,美国模型的网络能力整体呈快速上升趋势,当前最强模型的Elo分值已远超中国同类模型。中国模型(含Kimi系列、DeepSeek系列、GLM系列)虽持续进步,Kimi K3以约2000 Elo分值成为目前中国模型中网络能力最强者,但与美国顶尖模型仍存在显著差距。
Kimi K3整体能力置信区间相对较大,原因在于本次评估仅基于ExploitBench单一基准(41个任务),而其他模型的评分来源于更大规模、覆盖更多维度的任务集。
本次评估属于初步评估,基于有限数量的公开及私有基准测试。美国闭源模型在禁用系统级安全防护的条件下进行测试,以降低拒绝率、测量模型的最大能力上限,公开版本均已启用安全防护。由于Kimi K3部署架构的特殊性,本次仅对其进行了部分网络评估项目。

NIST – 23 Jul 26
UK AISI / CAISI Preliminary Assessment of Kimi K3's Cyber Capabilities
The UK Artificial Intelligence Security Institute (UK AISI) and the U.S.
主楼 - ulysses2026-07-24
现在开始讲攻击了 重点变成这样了么
- alan10204562026-07-24
那个最强的美国模型是mythos吗?
- 无邪气2026-07-24
5.6和fable5是不是专门做了网络攻击方面的训练啊
- 风铃铛2026-07-24
一边大谈安全一边对网络攻击能力进行特别训练,这是想干嘛呢 ^-^
- wjy2026-07-24
mythos强,用不上就是白搭,到时候出了什么差错还得靠开源大模型救场
- lueluelue2026-07-24
- 七叶怀瑾2026-07-24
其实这么看的话,我们的开源路线反倒能帮助世界上其他国家防一防老美的ai霸权攻击,虽然是干不大过吧但是聊胜于无,随着我们开源模型的进步,能让老美想要达到相同的攻击效果就要花的更多,一些小的和细节的攻击因为对老美来说成本不划算,可能就得以幸免于难了 ^-^