lao1 me
AI
服务器
日常
推广
公告
搜索
主题
回帖
收藏
【慢讯】老黄:在中国 没人谈“AI末日论”
热
 别豆包了,人家实验室内部版本也不让你看啊
maonega
2026-09-15
AI
17
一
AI
知道为什么感觉workbuddy的v4.1 f 降智了
有的,上游服务端的限制 但这个限制和从它们接口上拉下来的元数据不不一致,元数据的max output token是128k, 实际上只有32k 官方接口是384k
Xiwis_Homed
2026-09-13
AI
9
人杰
AI
知道为什么感觉workbuddy的v4.1 f 降智了
^-^ 那应该是最近限制的吧 我这本来就是直接测试的接口,没有通过workbuddy请求 现在会被强制stop, reason: length
Xiwis_Homed
2026-09-13
AI
9
人杰
AI
知道为什么感觉workbuddy的v4.1 f 降智了
和配置文件没关系吧,这是上游决定的最大输出,超过这个max token会被强制stop,会被卡在思考阶段
Xiwis_Homed
2026-09-13
AI
9
人杰
AI
A/发威胁报告后最大的赢家
热
蒸啊 A/双标不是一天两天了,它早期就是靠蒸起家的 你去reddit和x上看看,清一色在喷A/的 这次不是因为蒸馏,而是路由,数据静默出海导致的安全隐患
Xiwis_Homed
2026-09-11
AI
19
Xiwis_Homed
AI
A/发威胁报告后最大的赢家
热
有提到,没写在标题里面 16006就是说智谱越狱蒸馏fable
Xiwis_Homed
2026-09-11
AI
19
Xiwis_Homed
AI
anthropic的报告揭露了这世界就是个草台班子
热
 我知道有人要倒大霉了 试问这里有多少人vibe的时候是开审核模式的,不都是YOLO一把梭的吗 就算是涉密机构三令五申不要用大模型,但是这玩意方便,还是有很多人铤而走险的
allofus
2026-09-11
AI
19
LoongXin
AI
谷歌反代大面积封禁谷歌账号
我的意思是这俩号是一直同google框架在我手机登陆着,可能不算农场号?
黑天鹅
2026-09-10
AI
7
Xiwis_Homed
AI
谷歌反代大面积封禁谷歌账号
ip一起的没啥事 我这俩号都挂在我手机上,可能保号了?
黑天鹅
2026-09-10
AI
7
Xiwis_Homed
AI
🌟喜讯!OpenCode Go GLM-5.3-Flash 降价 额度翻5倍
热
luna k3 grok 看着,都跟着涨额度了,这样看10$ 其实蛮不错的
ill
2026-09-10
AI
19
梁金瑞
AI
谷歌反代大面积封禁谷歌账号
你这也太多了,我一个号池就俩印度18月pro 目前没事,用的CPA
黑天鹅
2026-09-10
AI
7
Xiwis_Homed
AI
🌟喜讯!OpenCode Go GLM-5.3-Flash 降价 额度翻5倍
热
还没更新,看文档确实额度提升了 用flash模型应该是爽登了 **Model** | **每 5 小时请求数** | **每周请求数** | **每月请求数** | Grok 4.6 | 169 | 423 | 845 | GPT 5.6 Luna | 2,050 | 5,100 | 10,250 | GLM-5.3-Flash | 6,320 | 15,790 | 31,580 | GLM-5.
ill
2026-09-10
AI
19
梁金瑞
AI
gpt坚持了26天被封号了
热
代充没准是刷的黑卡,如果对方发现向银行提起争议的话,就可能会封你的号
小王工程师
2026-09-09
AI
14
lin_ye
AI
被gemini的雷霆幻觉吓哭
热
开high没碰到过幻觉 倒是gemini 3.8 flash干活的时候给我一种清澈的愚蠢的感觉,虽然结果是对的,但是过程必须查得非常细才肯下手,反复确认,细节到我都不耐烦了
TazNeon
2026-09-09
AI
17
斯巴达克斯
AI
根据网传消息复原v4.1f deepswe跑分:全部斩杀
热
mini-swe可能指得是用mini-swe-agent跑的测试? 一个官方的跑测评用的harness github.com  GitHub - SWE-agent/mini-swe-ag
羽织
2026-09-09
AI
19
sxjeru
AI
DeepSeek V4.1 Flash登顶世界第一模,DeepSWE超GPT6.0 Astra(消息源真假自辩)
热
deepSWE还是很有参考性的,要是没刷分的情况下 小模型再强也是小模型,使用体验和astra这大参数的差很多
问心
2026-09-08
AI
19
mordo7238
AI
deepseek新模型实测智商,是多模态!佬友们可以测测
热
^-^ 这么小的模型可以说在某个领域超过Sol, 那也是RL发力了 无脑吹真不至于,人家参数量摆在那里
gjyus
2026-09-08
AI
19
沃士矮鲲
AI
deepseek-v4.1-flash-expires-on-0910 鹈鹕测试
 没用harness, 在cherry studio直出的 --- 虽然画面元素不复杂,但它的逻辑、遮挡、动作都正确,很不错的,毕竟只是个flash模型 放到claude code里面加载一些skill什么的
Tibo-linuxdo
2026-09-08
AI
7
haib
AI
deepseek v4.1 flash公开测试
热
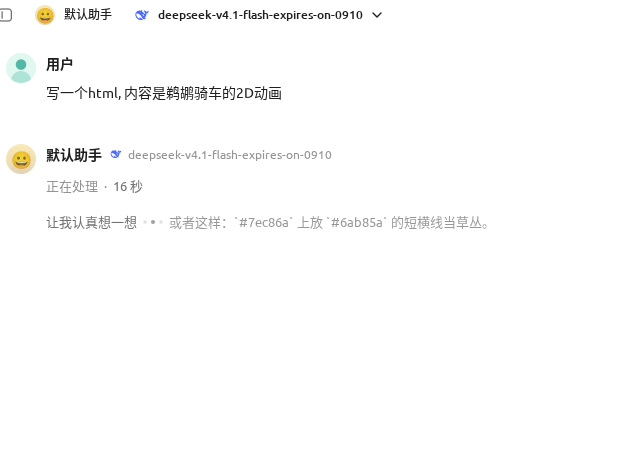 真的 只看鹈鹕骑车oneshot的话提升很高,空间逻辑完全正确,之前flash做不到 