lao1 me
AI
服务器
日常
推广
公告
搜索
主题
回帖
收藏
发布一款 微信4.1聊天查看和导出工具有啥风险不
热
个人用来分析自己的群聊工作啥的,为了群众 ^-^
jeffccie
2026-09-07
AI
19
白鱼登舟
AI
发布一款 微信4.1聊天查看和导出工具有啥风险不
热
这有点猛了,还是我老实点 ^-^
jeffccie
2026-09-07
AI
19
白鱼登舟
AI
各位佬,有没有佬做过BW1300单卡推理吞吐量的测算
这是啥卡,搜不到哇,哪家的
wannaw
2026-09-07
AI
1
jeffccie
AI
今天 GLM 3亿,AMD 0.1亿 别忘了领
这样说,你换个地区试试,我过人机好像挺简单
jeffccie
2026-09-05
AI
7
jeffccie
AI
今天 GLM 3亿,AMD 0.1亿 别忘了领
用联合登陆好点,github啥的
jeffccie
2026-09-05
AI
7
jeffccie
AI
今天 GLM 3亿,AMD 0.1亿 别忘了领
飞快,就是量太小了不够用 ^-^
jeffccie
2026-09-05
AI
7
jeffccie
AI
commandcode 10$也不够用呀。付8月消耗
现在头有点大,找不到便宜又好用的 ^-^
jeffccie
2026-09-01
AI
3
sanfen
AI
感觉glm5.3 flash的黑话也不少来着
 也不知道从哪学的,就是这么直接
zzxzz12345
2026-08-31
AI
5
温七
AI
长文本 + 固定 JSON 输出的场景下,怎么样用API成本能低一点?
还是之前好,30能蹬6个亿,涨了就没用过了
尝一口木可
2026-08-30
AI
2
jeffccie
AI
m1max满血版本地大模型
64G 还调个啥 256K开启,爽爽蹬,我测了 30 40 50 但没MAC哈哈
drfy
2026-08-30
AI
1
jeffccie
AI
花巨资横评:Qwen3.8-27B_四卡对比_3090-4090-5090-V100
> 1Cat-vLLM 我刚去看了感觉很不错呀,明天搞来试试看提升多少 ^-^
jeffccie
2026-08-30
AI
8
jeffccie
AI
花巨资横评:Qwen3.8-27B_四卡对比_3090-4090-5090-V100
核心太老了,新模型适配困难只有OLLAMA简单点。量化也挑 ,不过佬的建议我要试试 1Cat-vLLM ^-^
jeffccie
2026-08-30
AI
8
jeffccie
AI
花巨资横评:Qwen3.8-27B_四卡对比_3090-4090-5090-V100
随便一个卡大几千好几W,感觉个人还是plan适合一般使用,除非是防泄密,不然投入太多。不过有之前买过游戏卡有需要可以用起来哈哈。 ^-^
jeffccie
2026-08-30
AI
8
jeffccie
AI
花巨资横评:Qwen3.8-27B_四卡对比_3090-4090-5090-V100
以上均为真机实测,用于给佬们一个参考,请注意数据真实非AI生成。
jeffccie
2026-08-30
AI
8
jeffccie
AI
[求助] 求推荐高性价比云 GPU 算力租赁平台,用于深度学习模型训练
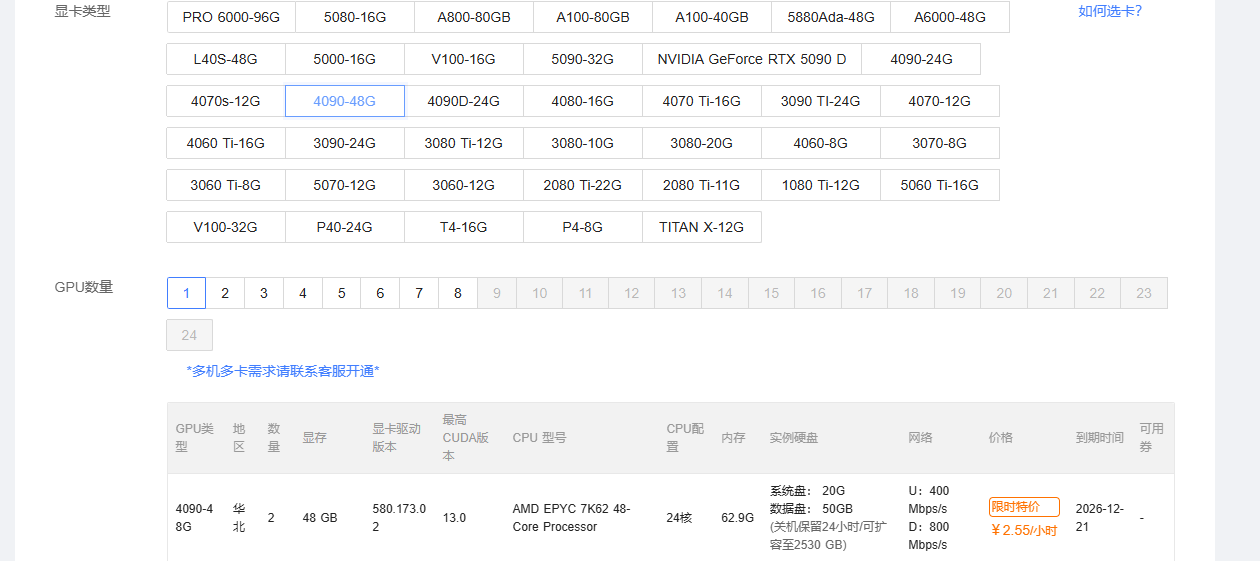 我最近的测试都用的这个,还行
ridge
2026-08-26
AI
6
jeffccie
AI
花巨资测试:Qwen3.8-27B_3090-5090-V100-上下文_横评
测试完了质的飞跃,但32G只能跑32K上下文,不过用原生MTP速度也翻了一倍。 ^-^
jeffccie
2026-08-23
AI
7
olivame
AI
花巨资测试:Qwen3.8-27B_3090-5090-V100-上下文_横评
听佬们的建议加了DFLASH和MTP,质的飞跃,从192K 从58飞到120 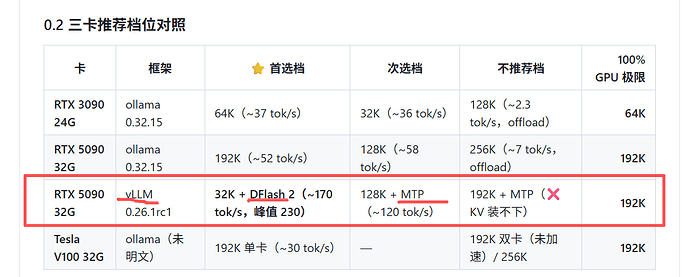  搞起来试试,看能提高多少
jeffccie
2026-08-23
AI
7
olivame
AI
花巨资测试:Qwen3.8-27B_3090-5090-V100-上下文_横评
这个得换卡试,V100 架构太老只能用OLLAMA ,只支持MTP
jeffccie
2026-08-23
AI
7
olivame
AI
花巨资测试:Qwen3.8-27B_3090-5090-V100-上下文_横评
全为真机实测,给各们佬参考。 V100是真划算。就是慢点
jeffccie
2026-08-23
AI
7
olivame
AI
花巨资测试:Qwen3.8-27B_RTX5090-32G_Ollama_上下文对比
**192K 是这台 32GB 卡的真正甜点档**
jeffccie
2026-08-22
AI
4
落寞书生
AI
花巨资测试:Qwen3.8-27B_RTX3090_Ollama_上下文对比
自部署一定要注意上下文大小,看网上各种测试也要问问他们的上下文,实测影响很大 下图是DSH 加 qwen 上下文 64K测试,因为上下文过小会被频繁压缩,个人感觉非常影响效率。 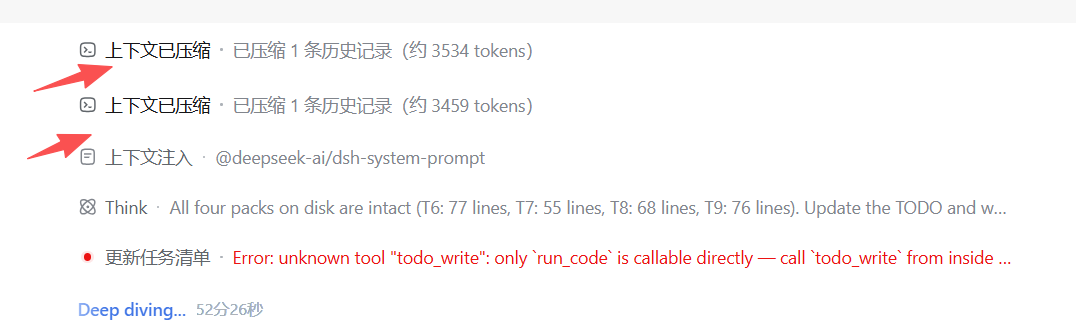
jeffccie
2026-08-22
AI
6
W1nge
AI
花巨资测试:Qwen3.8-27B_RTX3090_Ollama_上下文对比
4090 24G我一会也要测试,最近被弄的头大,各种plan都试过了,现在准备试试各种硬件,给佬们提供下参考。
jeffccie
2026-08-22
AI
6
W1nge
AI
超算互联网scnet 的tokenplan 别买千万别买
紧急避坑,个人不太建议购买这家的plan 429恶梦
jeffccie
2026-08-20
AI
3
jeffccie
AI
超算互联网scnet 的tokenplan 别买千万别买
新报错,一直用一直有惊喜 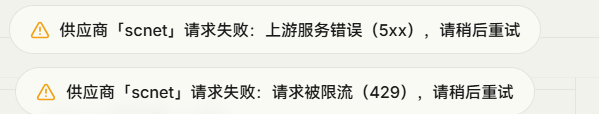
jeffccie
2026-08-20
AI
3
jeffccie
AI
今天试试 超算互联网 的tokenplan是否比ds原厂便宜
测试中,暂时安全,平台dsh 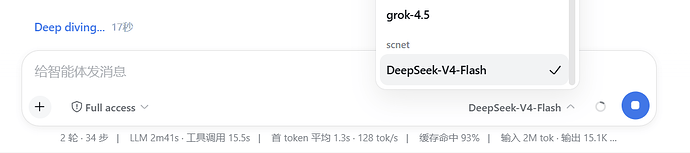
jeffccie
2026-08-19
AI
8
Neo-linuxdo
AI
今天试试 超算互联网 的tokenplan是否比ds原厂便宜
我试试看能不能蹬到6亿,超过就是赚了。
jeffccie
2026-08-19
AI
8
Neo-linuxdo
AI
今天试试 超算互联网 的tokenplan是否比ds原厂便宜
那不也得试试水么,其它便宜的都不够蹬呀 ^-^
jeffccie
2026-08-19
AI
8
Neo-linuxdo
AI
deepseek harness 安装教程(成功方案)
测试下来和其它harness一样操作,过度恢常丝滑,且也有添加自定义模型 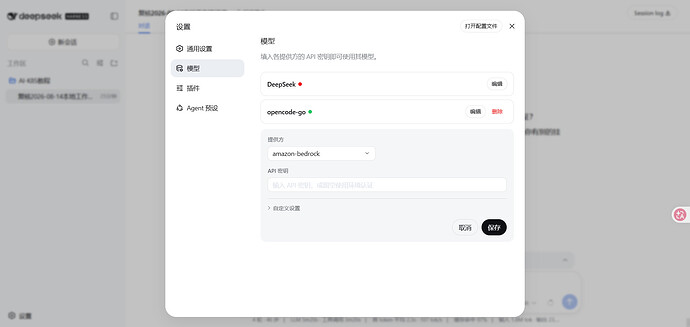
jeffccie
2026-08-15
AI
3
藏于云海
AI
opencode go ds-v4-flash好像有问题
热
flash chat改了 Responce flash正常了,但pro报错了,用的时候要注意一下。pro如像适合chat 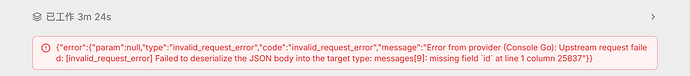
jeffccie
2026-08-09
AI
14
renew98
AI
上一页
1
2
3
4
下一页
提示
×