- chairman2026-08-17
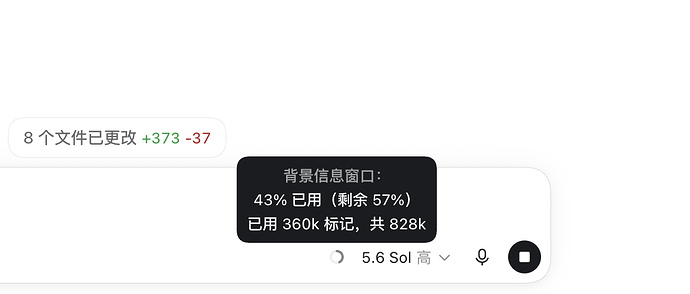
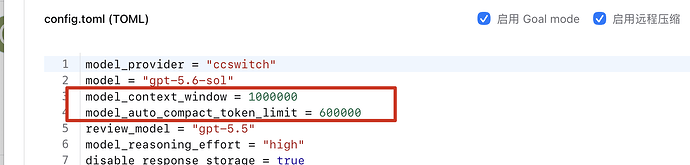
今天替播宣布5.6sol出1m上下文了,他说不建议开到这么高。大家都知道长上下文会有损失,但是开1m和开256k但是压缩哪个效果好呢?1m有损失,但是上下文压缩肯定也有损失。要是1m比压缩强,那还是值得开的。
主楼 - FFFFFFFFFir2026-08-17
1m的话后期每次会话携带token更多,会更贵的哦
- 陈小爬2026-08-17
开那么多干嘛,又贵又有损失,整个272压缩就行了
- 行思渐远2026-08-17
- 邪恶老登2026-08-17
codex的压缩和记忆我觉得一直很稳啊,追求1M不知道为啥
- xz-dev2026-08-17
我用 kimi k3 逆向的时候发现长上下文可能会发现一些,短上下文会被压缩掉的细节
- lsyt2026-08-17
理论上,缓存多的任务,1M上下文会更便宜,因为缓存和未缓存价格差太多了
- 行思渐远2026-08-17
GPT的远程压缩确实很稳定,不过1M现在作为可选项当然是更好了.
不同上下文工作方式还有区别,看过一个测试,作者是自己模拟了一个AI模拟快递员送快递场景.
1M上下文可以提前把建筑物坐标都提前记下来,并且安排好,没油的时候需要去哪里加.
200多的上下文就需要提前准备一些“字典”,干一会儿就得去查一下,再安排下一步.
不同场景下效果个有有优劣,比如1M找加油站的时候就找了远处,而200多K那个因为找了“字典”,优先找了就近.
- 邪恶老登2026-08-17
我的项目体量一般不会太大,个人体验下来,除了token消耗,没感觉1M有比较明显差异,我目前对于上下文的看法就像是电脑内存,可以大,但是够用就行
- 七英清2026-08-17
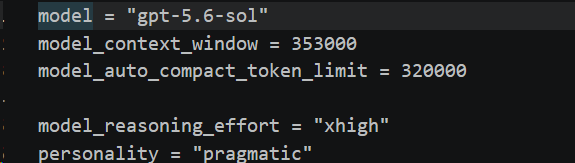
我按 tibo 配合好像不生效,佬是怎么配置的
- Baimosama2026-08-17
现在超过272k还是两倍额度进行收费吗?
- ceshi01Adx2026-08-17
除了让用量掉的更快之外没多大用处,gpt系列模型超过400k性能下降就挺严重了,所以默认设置大概在272k左右压缩
- ranran2026-08-17
这个1M上下文是desktop也支持吗?我感觉处理文字项目的话,其实没必要非要1M上下文,主要是codex可以把会话发到新对话里继续执行,做得还挺好的。
- iidoi2026-08-17
- 行思渐远2026-08-17
- 南箕子2026-08-17
一般300K以下性能是最好的,上下文接近 1M 的时候性能损失应该已经挺严重了
- sein2026-08-17
顶多到300k就得手动去压缩了,但是短上下文场景中有些长程任务中途压缩容易漂移,总之能让用户自己做出压缩时机的决策挺好的。
- RerrentLinden2026-08-17
要在 model catalog 里改配置,改 config.toml 没效果
- tiantiantian1232026-08-17
老对话窗口不行的,你新开对话窗口就可以了
- 七英清2026-08-17
开了新会话了,一样没效果,不过我是反代api接入,不是登录账号