- RiverCygnus2026-08-18
省流版:上下文没清理/压缩导致每次请求携带的上下文占据着消耗的大头,而Deepseek的控制台又不支持查看单次token消耗量,于是在感知上余额消费的越来越快
事情是这样的,今天跑AI算是目前跑的比较久的一次,因为我本人是习惯每次10块钱一充的(因为担心出现什么问题导致一次性余额全部刷完),同时又由于是学生党+暑假末期,资金实在是有些匮乏了,于是每次的充值负反馈实际上是非常强烈的,因此今天充值了两次之后,感觉事情好像有点不对劲。
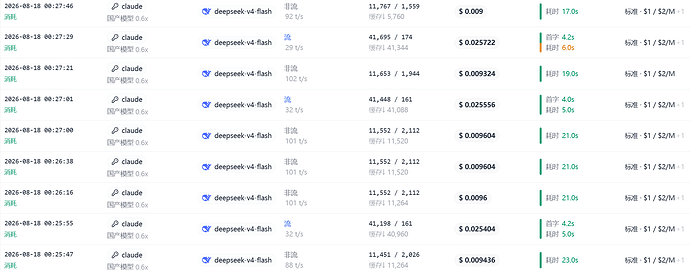
如图,从结果分析的话,大部分还是因为在高峰期+pro用了一半,所以计费我没什么疑问。但是在体感上和之前有点不同,总感觉token烧起来的速度是越来越快了,但是又不知道哪里的问题。因为DeepSeek是不支持每次调用详情查看的,只能大概判断某个时间段内的总用量,而claude上面每次显示使用的token数也不超过10万,但是整体的量却来到了上亿。
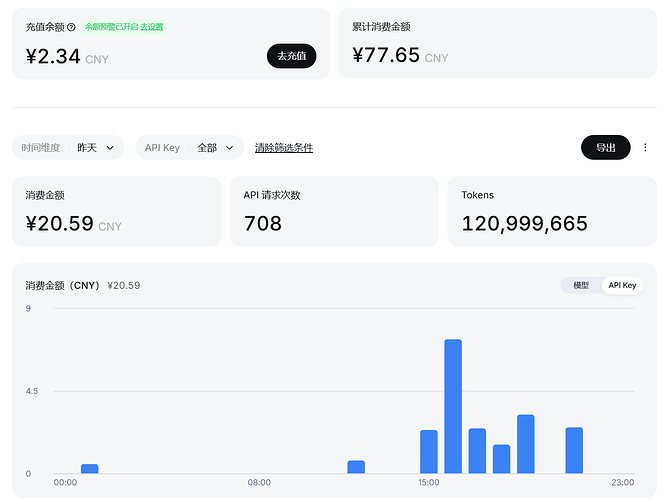
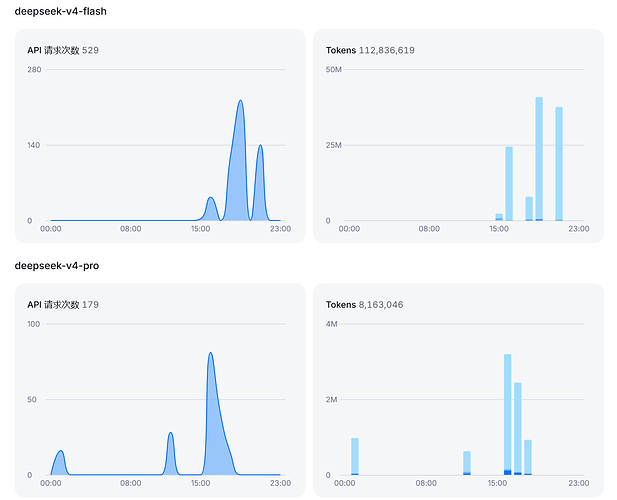
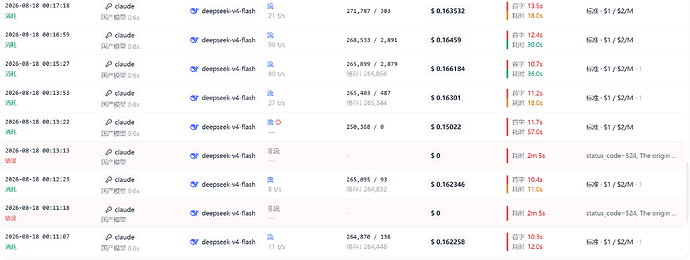
于是在晚上尝试找中转站来缓解一下资金压力,这时才通过中转站日志发现每次请求的输入token数为25w左右。
我本身是喜欢将某次对话进行规范命名,然后该对话就负责项目的某个具体部分,原本以为这是一个规范化的好习惯,但是却成为了token消耗的罪魁祸首。因为我的任务并不需要维持大量的上下文信息,但是claude又不可避免地将上下文信息携带到输入去,而在claude上并不会显示上下文占用的token,因此导致看起来claude上面用的非常少,但实际的请求消耗的token数非常大,同时又因为deepseek不支持查看单次请求的token消耗量,于是就演变成了蓝色大肥鱼在背后默默吃token(
压缩掉上下文后的单次输入token数才几w左右
最后就是想和各位佬友交流一下,有没有什么能缓解这种问题,或者来点学生党能便宜用的中转站,毕竟每天20块钱的使用量真是有点耗不起(,以及各位有没有遇到其他相关问题可以分享一下,避免再踩坑。
主楼 - Swifty2026-08-18
任务并不需要维持大量的上下文信息
如果不需要长上下文,就有意识维护一个简短的对话历史,经常compact和clear,每个任务新开一个session,如果需要之前的信息就写一些不同对话之间通用的文档来传递,经常看/context,这样至少大部分情况下都是相当便宜的短任务
- RiverCygnus2026-08-18
文,就有意识维护一个简短的对话历史,经常compact和clear,每个任务新开一个session,如果需要之前的信息就写一些不同对话之间通用的文档来传递,经常看/context,这样至少大部分情况下都是相当便宜的短
好的,这次算是吃一堑长一智了,挺好的哈哈
- 林语尘2026-08-18
- RiverCygnus2026-08-18
omg,不要哇我的余额。在等待的过程中慢慢看余额也在慢慢掉,何尝不是一种折磨。