- prosumer2026-08-07
太长不看:
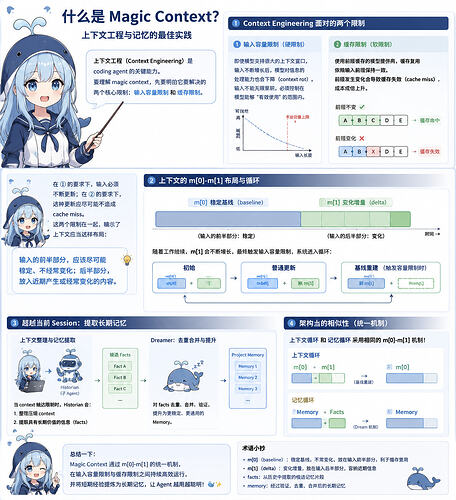
上下文工程(context engineering)一直是 coding agent 的重要组成部分,也是其中的重要问题。要想理解magic context,或者解释为什么magic context是上下文工程或记忆的最佳实践,必须先理解上下文工程所面对的究竟是什么问题。
Context engineering 问题可以被分解为两个限制:
- 输入容量限制
- 缓存限制
对于1,输入容量限制,某种意义上可以把它理解为 context rot 造成的有效容量限制。
也即,即使模型声明支持很大的上下文窗口,输入不断增长之后,模型对其中信息的处理能力也可能下降。为了让模型能够有效理解和处理当前任务,输入不能无限制地累积所有历史信息,而必须被控制在一个可用范围内。
因此,模型每次请求能够接收、并且能够有效利用的输入实际上是有上限的。而一个持续工作的 Agent会不断产生信息,这就意味着,Context Engineering 必须不断对输入进行某种更新,否则输入最终会超过模型能够有效处理的范围。
对于2,缓存限制,实际是一种软限制。
对于使用前缀缓存的模型提供商,缓存复用依赖输入前缀保持一致。前缀中的内容如果发生变化,后面的缓存通常也无法继续复用,这会造成成本的成倍上升。
因此,缓存限制并不是说输入不能变化,而是它的变化应该尽可能保证缓存复用。
在1的要求下,输入容量必然要求输入进行某种更新,而在2的要求下,这种更新应该尽可能不造成cache miss。
这两个限制放在一起,就已经在一定程度上暗示了上下文应当采取怎样的布局:
输入的前半部分,应该尽可能是稳定、不经常变化的内容;输入的后半部分,则可以放入近期产生或者经常变化的内容。
但是随着工作的继续,后半部分也会不断增长。它虽然不会立即破坏前面的缓存,却最终仍然会遇到输入容量限制。于是系统又会重新面临问题1。
这就意味着一个循环应该存在,也就是
初始->m[0] (稳定基线baseline) + m[1] (变化增量delta)
普通更新->m[0] + 新m[1]
基线重建->新m[0] + 空m[1]到这里,m[0]-m[1] 解决的还只是当前 session 中,上下文如何在输入容量限制和缓存限制之间持续运行的问题。
但是,coding agent 在工作过程中产生的信息并不都只对当前 session 有效,为了增强后续session,让他们不要从0开始,我们需要
从当前工作中提取具有长期价值的信息并将其转换为更稳定、更适合复用的表示。
很多workflow都提出过对应的解法。
例如,GenericAgent是将已经验证过的执行路径提炼为skill,供之后的相似任务直接复用;Trellis则偏向积累规范、任务状态和团队共享的工作知识。
magic context也有类似的机制,不过它的切入点从agent自己为自己整理经验,变成了由context engine负责整理。
这个设计很符合直觉:
- agent自己本身就可能存在compact后遗忘等问题,由context engine派发专门的subagent(也即historian)来整理上下文很顺理成章。
- 整理context过程和提取记忆过程是类似的,因此整理历史的过程中提取候选记忆很合理。
因此当context到达限制的时候,historian就会出来整理一下context,顺便提出一些facts作为project memory的候选。然后进行后续的去重合并等操作(dreamer机制),facts被提升为memory。
到这里你可能会发现一种架构上的类似性:
m[0] + m[1] → 新m[0]
memory + facts-> 新memory这种相似性让magic context的memory部分也保持了m[0]-m[1] 的统一机制,于是我们之前的
初始->m[0] (稳定基线baseline) + m[1] (变化增量delta)
普通更新->m[0] + 新m[1]
基线重建->新m[0] + 空m[1]又可以描述memory过程。
主楼 - MrTiger2026-08-07
非常好的文章!请教下佬友,我用的是trellis,被pi自带压缩机制折磨得够呛,但是用magic context又觉得和trellis冲突了,个人觉得两者的职能有重叠的部分,佬友觉得这两个搭配用有问题吗?
- prosumer2026-08-07
自从5.6出来之后我已经转向魔改mattpocock/skills了, 其实可以考虑魔改trellis, 让luna max/xhigh干活很便宜, trellis确实是团队用agent的一个很好的实践
- apparition2026-08-07
思考了 3 秒,我选择坏人人格 ^-^
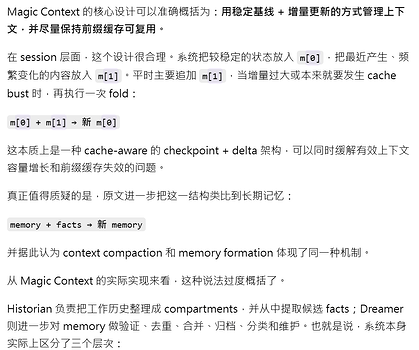
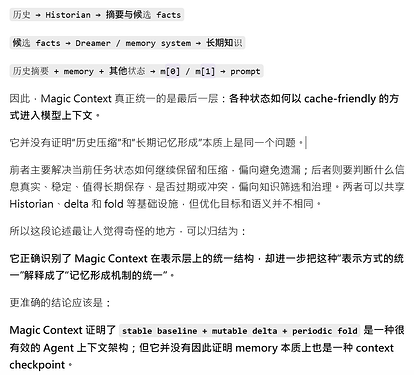
上下文压缩、记忆产生与维护是不太一样的两个领域
从论述中我没看出 magic context 是上下文工程和记忆最佳实践的证明
我只能知道 magic context 对上下文怎么做而已
- pranksterlaborious2026-08-07
你这样直接将记忆放到 m[0] 里面会不会导致留给 m[1] 的越来越少。记忆我认为应该是按场景激活的,都激活的话上下文会被占很多
- Kassdin2026-08-07
又是无数种上下文雕花工程中的一个,首先应该证明它在长程任务的通过率和 cost 上都比朴素压缩强,才能谈最佳实践的事
- prosumer2026-08-07
- prosumer2026-08-07
这倒不是, m[0]和m[1]是长期-短期的结构, 在context场景有这个结构的实现, 不是说记忆全到m[0], 另外magic context并非我设计的, 我只是赞同其设计, 写一篇推荐性文章(利益无关)
- cheluen2026-08-07
ace拉闸了,magic context好用吗,有点想转了
- 朱慧月2026-08-07
- prosumer2026-08-07
ace和magic context不是一类东西, ace偏召回吧, magic context属于上下文工程
- prosumer2026-08-07
有一定道理, 我一直在考虑拿我的coding session做eval, 但是问题是长程任务我肯定是根据它的回复要做出一些我的指示的, 所以即便对于同一个起点, 我中间会输入的东西也是不同的, 所以我一直没搞懂怎么搞这个, 佬要懂的话求教 ^-^
所以我现在只能说相比于compact, 理论上以及体验上来说这个东西能够让上下文更加连贯, 因为普通compact就是agent自己输出一段内容做为下一轮输入, 上下文损耗很严重, 但是这个它是一直在50%左右的上下文占用, 上下文压缩损耗较小
- 朱慧月2026-08-07
很简单的道理 你的session自己就存在压缩的部分
你在压缩之前用正常的compact做baseline 再用你说的 “magic context” 做对照组
来看最后到下一个检查点时的cost,用时和通过率就好了,没那么困难。
或者你也可以做goal task,去测试比如tb 2.0 里的hardtask来做对比
以验证为基础的的eval没必要那么精细,只要能控制变量出结果就好了
- Decidable64712026-08-07
- cainiao3hao2026-08-07
正巧最近研究过,也用过,所以最后打算自己vibe一个了。
其实我觉得magic context这种黑盒形式的反而违背了pi的设计理念,压缩哪些、记忆哪些完全是不透明的,而用户甚至没有一个方便的介入方法。
更麻烦的一点是,它完全应用不了openai、grok提供的远程压缩能力(它强要求压缩为格式化的明文,否则跨对话记忆跟分级降两个都废了),而这两者的远程压缩,效果是远好于普通压缩的,哪怕你是分节点进行连续压缩。听说是直接根据实际token怎么激活来决定怎么压的
即便用了一堆检验尽可能避免错误的记忆进入,但全黑盒的运行导致完全没办法避免这件事,上下文工程里最忌讳的就是错误的token误导了模型,只要它存在就会对输出造成无法挽回的影响。特别是搞破限的话就更有体会,有时候不知道怎么就莫名其妙的一个"不准"直接破甲效果从能破变成完全不能破
mc里面也有一个可配的dreamer会在空闲时候对会话进行再一次的跨对话记忆的提取,也可以看出它整体的设计思路是以召回为主,而不是保证进入上下文的记忆、token的正确性。当然它也有许多校验跟丢弃,但我是感觉这种全塞进去再通过校验去扔,对校验的正确性要求太高了,又很容易漏
- cainiao3hao2026-08-07
而且它的多级压缩是不分节点类型的,比如说user发的、assistant发的,他都同等对待,归一为u:xxxxx, a:xxxxx,然后让压缩模型去压,压缩后的回放也是不分类型。换句话说,它觉得ai的回复跟user的需求同等重要,我是不赞同这点的(当然,模型也可能天然的觉得u:xxxx这部分更重要会保留更多细节啥的,我只是说结构上的处理方式),毕竟我是更赞同codex远程压缩的那个做法(不是赞同它那xx一般的返回的加密压缩,是它的那套结构),回放的时候保留更多的user,删掉更多的assistant。
- prosumer2026-08-07
openai的远程压缩也是黑盒的吧, 不过openai的压缩质量确实可以, 在codex里面很无感
用户没有介入方法倒是确实, 但有介入怎么避免过度麻烦也需要设计, 这部分佬有什么好的方案吗?
权重这方面magic context v2的时候似乎要改进
- cainiao3hao2026-08-07
是啊,所以我觉得它那返回的密文跟xx一样。我只是觉得它觉得user消息更重要的处理方式挺戳我的。
好不容易用到pi,能看模型每次压缩的是什么了,结果又是只读的就很气,我正在做一个允许自己改一切节点的,压缩一遍的节点直接自己上手改算了。就像酒馆一样,直接编辑模型回复
连续节点压成几个m分级确实挺好的,这部分我也参考了一下,直接允许你选中几个你觉得不需要的节点归一成一个单节点,可以让ai压缩也可以你自己简单一句话概括掉啥的。
当然对用户的精力消耗的就更多了,如果要做自动化的话,magic context这种确实更好,直接帮你决定算了。只是我个人更喜欢一切尽在掌控的感觉。酒馆玩多了是这样的,哪里不满意,直接编辑,打不过去就改状态栏给自己开挂 ^-^
- cainiao3hao2026-08-07
不过严格意义上也不算无法介入,只是介入麻烦,.local\share\cortexkit\magic-context里有记忆的db,sql格式的。何时压缩保留多少也可以自己手动/ctx_warp 节点数这种
- prosumer2026-08-07
这么说似乎有点像dcp, opencode-dcp提供手动prune的方式, 只不过我没用过
不过对我来说上下文工程的意义就是让它尽量保持一种同一性? 不至于讨论到中途我说过的要求/以前考虑过的思路忘掉了