- 格事格非2026-08-20
基本配置信息如下:```
类别 当前配置
虚拟化 VMware VMware7,1
操作系统 Ubuntu 22.04.5 LTS
Kernel Linux 5.15.0-181-generic
CPU 标识 Intel Xeon Platinum 8352V @ 2.10 GHz
CPU 分配 28 vCPU,单虚拟 NUMA node,无虚拟 SMT
内存 配置 76 GB,Linux 实际可用约 74.57 GiB
Swap 2 GiB
GPU 2 × RTX 4090
显存 每卡 24,564 MiB,总计约 47.98 GiB
GPU 功耗上限 每卡 450 W
NVIDIA 驱动 570.124.06
系统盘 700 GiB VMware 虚拟磁盘
根文件系统 ext4 + LVM,686 GiB
磁盘使用 45 GiB 已用,614 GiB 可用,约 7%
网卡 VMware VMXNET3
虚拟链路 10 Gbps
Docker 29.6.0,cgroup v2
``启动参数如下:``
/app/llama-server \
--model /models/Qwen3.8-27B-UD-Q4_K_XL.gguf \
--alias qwen3.8-27b \
--host 0.0.0.0 \
--port 8080 \
--n-gpu-layers 999 \
--split-mode layer \
--tensor-split 1,1 \
--ctx-size 102400 \
--parallel 1 \
--n-predict 8192 \
--cache-type-k q8_0 \
--cache-type-v q8_0 \
--flash-attn on \
--spec-type draft-mtp \
--spec-draft-n-max 3 \
--spec-draft-type-k q8_0 \
--spec-draft-type-v q8_0 \
--jinja \
--cache-prompt \
--metrics \
--mmproj /models/mmproj-F16.gguf \
--reasoning-effort medium \
--reasoning-budget 2048 \
--api-key-file /run/secrets/qwen-api-key
``测试数据:``
Metric | Result |
|---|---:|
| GPU 0 resident/observed peak | 10.95 / 10.95 GiB |
| GPU 1 resident/observed peak | 12.86 / 12.86 GiB |
| Total resident/observed peak | 23.81 / 23.81 GiB |
| Average server decode speed | 89.59 tokens/s |
| Server decode speed range | 73.17-107.40 tokens/s |
| Average client-observed decode speed | 89.57 tokens/s |
| Client-observed decode range | 73.18-107.38 tokens/s |
| Average end-to-end speed | 50.53 tokens/s |
| End-to-end speed range | 45.10-55.38 tokens/s |
| Average TTFT | 0.561 s |
| TTFT range | 0.483-0.656 s |
| Average end-to-end time | 1.271 s / 64 tokens |
| End-to-end time range | 1.156-1.419 s |
| MTP acceptance | 64.48% (492/763) |
| Model load time | 5.70 s, derived from current startup log markers
``````
| Category | Average decode | Average TTFT | Average end-to-end | MTP acceptance |
|---|---:|---:|---:|---:|
| Chinese | 87.81 tokens/s | 0.530 s | 1.251 s | 62.56% |
| English | 82.03 tokens/s | 0.557 s | 1.330 s | 56.52% |
| Math | 93.66 tokens/s | 0.595 s | 1.275 s | 69.61% |
| Code | 94.89 tokens/s | 0.561 s | 1.228 s | 70.56%
```
测试下来我个人感觉是:
1、至少能用,输出的tok/s还算理想,不会卡顿。
2、模型能力上好像还可以,让他逆向和对一个网站做黑盒评估分析能准确发现问题。
部署在本地跑agent,跑一些漏扫,逆向任务啥的,我感觉后续可以使用它。
主楼 - 匿名者2026-08-20
这个确实是目前本地部署小模型里面最好的一个了。
- 匿名者2026-08-20
只是4BIT对于长上下文不理想。
- igg82026-08-20
真是大佬,随随便便掏出来就是两个4090
- gogo2026-08-20
- 格事格非2026-08-20
确实,这点目前测下来有点弱。但怎么说呢,也够用吧
- Fate-linuxdo2026-08-20
大佬还待是大佬啊,随便一掏出来 直接GPUx2 4090
- msputup2026-08-20
- M_M2026-08-20
内存也是76,除了服务器,我就没见过这个配置,果然大佬 ^-^
- onjim2026-08-20
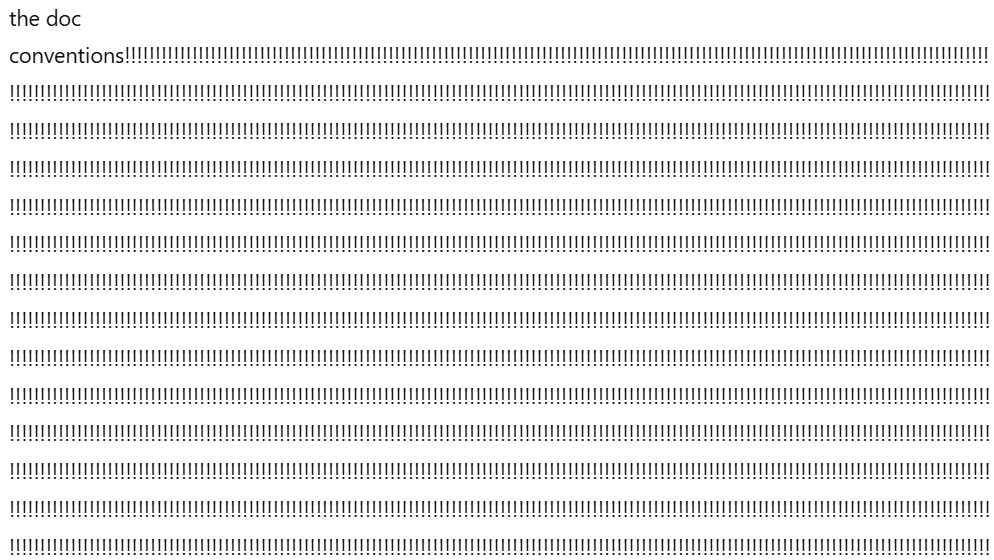
有佬知道这是啥问题不,我昨天跑这个qwen27b-8bit出现了两次
temperature: 1.0
top_p: 0.95
top_k: 20
repetition_penalty: 未设置
reasoning_effort: xhigh
enable_thinking: true
max_tokens: 未设置
vlm_mtp: 开启
mtp_block_size: 4
- 格事格非2026-08-20
temperature: 0 max_tokens: 2048 enable_thinking: true reasoning_effort: medium vllm_mtp: false ```这样试试呢?如果可以的话再用这个试试:``` temperature: 0.6 top_p: 0.95 top_k: 20 repetition_penalty: 1.05 max_tokens: 2048 - Mingo2026-08-20
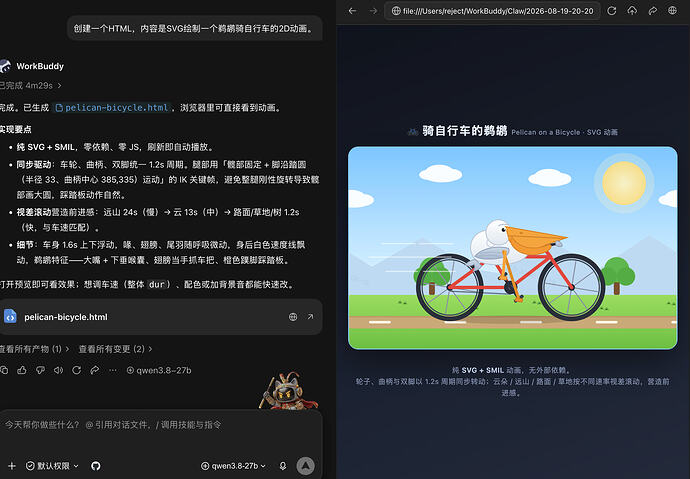
哇,超乎想象喔,鹈鹕的质量这么高吗?
- 李寻欢2026-08-20
这是我的命令。实测47 t/s左右。显卡是RTX PRO 6000。显存占用 90.4 G。
个人感觉真可以和deepseek-v4-flash正式版五五开。```
vllm serve /root/models/Qwen3.8-27B-FP8 \
--host 0.0.0.0 \
--port 6666 \
--served-model-name Qwen/Qwen3.8-27B \
--tensor-parallel-size 1 \
--max-num-seqs 1 \
--mm-encoder-tp-mode data \
--reasoning-parser qwen3 \
--enable-auto-tool-choice \
--tool-call-parser qwen3_coder \
--trust-remote-code - 格事格非2026-08-20
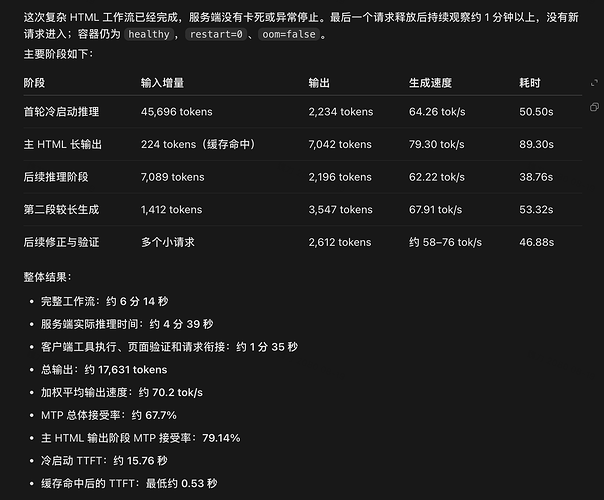
刚刚又让他帮我在甲骨文上升级了一下Vaultwarden啥的,同时上codex监听任务速度也还不错。
指标 |
最后一次请求 |新增/重新计算的输入 |
1,153 tokens |Prompt 处理时间 |
1.205 秒 |Prompt 处理速度 |
956.75 tok/s |输出 |
1,105 tokens |输出时间 |
18.138 秒 |输出速度 |
60.87 tok/s |服务端总耗时 |
19.343 秒 |MTP 接受率 |
69.94% |TTFT 情况:
- 纯模型侧首 token 时间估算约 1.2 秒
- 这次请求开始前发生了一次 prompt cache 腾挪,额外耗时约 1.13 秒
- 因此从服务端收到任务到首 token,实际估算约 2.35 秒
- WorkBuddy 客户端显示的 TTFT 还会叠加局域网、代理转发和客户端处理时间
llama.cpp 当前日志没有记录精确的“第一个 HTTP chunk 发出时间”,所以
2.35 秒是根据 slot 获取、模型启动和 prompt eval 时间计算的服务端估算值,不是客户端精确测量值。如果把北京时间 10:30:49 到 10:35:34 这一段连续的 15 次模型调用视为刚才的完整 WorkBuddy 任务:
- 加权平均输出速度约 73.1 tok/s
- 单次速度范围约 57.8~105.7 tok/s
- 一般缓存命中的 TTFT 约 0.7~2 秒
- 遇到 17K~35K 新 prompt 或缓存失效时,TTFT 会升到 11~18 秒
- 最慢的一次主要是 prompt cache 未命中,重新处理了约 34,660 tokens
结论:当前输出速度总体正常,平均约 73 tok/s;最后一次是 60.87 tok/s,偏低但仍在正常波动范围。现在更明显的问题是 prompt cache 腾挪或失效带来的 TTFT 波动,而不是持续性的生成速度不足。
- szz2026-08-20
看着不错,比某中转站强不少,那个中转站不用也罢
- slothboy2026-08-21
- hbetv2026-08-21
羡慕这么好的配置,我现在想本地跑H3玩玩,奈何配置不行
- Teler2026-08-21
有佬知道有什么平台现在提供qwen3.8-27B的调用吗,想试一下接agent项目的能力边界咋样
- 长夜2026-08-21
这个基本可以放弃指望。
这玩意只是看起来小,但问题是它是稠密模型,它的推理成本比ds4f高不少,这意味着作为服务商提供给你的api,会比ds4f贵2.5倍以上——然后你就面对一个非常好笑的问题了,那为什么你不用ds4f呢?——不就是ds4f涨价之后显得贵吗,这小玩意比它还贵你会用吗?
所以基本上你不会看到服务商提供它的。
- Chen_JW2026-08-21
现在的qwen3.8-27b太慢了,每次思考都要好几分钟甚至有时候能干到十分钟二十分钟这样子,测试下来鹈鹕骑车和其他几个前端小游戏一个问题就能思考个7,8万token,只能拿它做做单次任务啥的了