- Myth2026-08-21
评测数据基本超200k之后得分都腰斩了,那这样的模型跑分结果还有可信度吗
搞1M上下文也没什么意义了 徒增费用
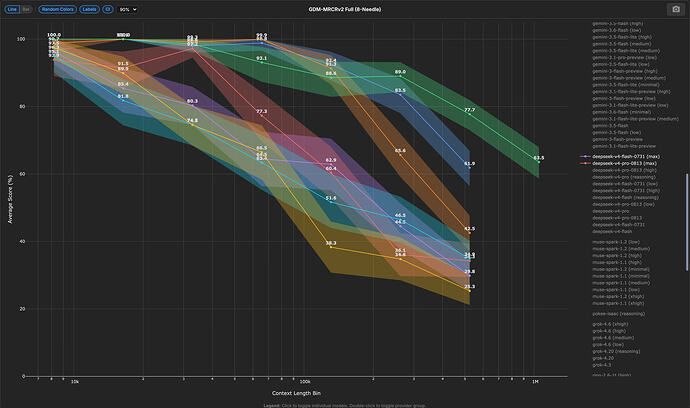
感兴趣的可以研究一下
contextarena.ai
Context Arena
Context Arena — LLM long-context benchmark leaderboard
主楼 - GloryDuck2026-08-21
原来不止单次调用费用暴涨,智力也暴跌啊
- 朴实无华2026-08-21
对呀,所以CODEX 272k 压缩是有道理的,不用追求过长,过长弱智
- Mr.Hua2026-08-21
就跟人一样,东西里太多,有时候就等于啥都没记住
- hubiao2026-08-21
# 将上下文窗口设置为 372,000 model_context_window = 372000 # 将自动压缩阈值设置为 272,000 model_auto_compact_token_limit = 272000 - ld.so2026-08-21
 Jamie2026-08-21
就想让ai帮我读电子书怎么办, 都是很长的
- admini-linuxdo2026-08-21
没那么严重,测试方式和测试数据样本不全面。当然大上下文是要不断探索的领域和解决模型幻觉一样重要。
- 时牧2026-08-21
是啊,所以gpt在codex用只需要258k上下文
- 7xWEcQ2026-08-21
这样设置的话那个372没意义吧,272就压缩了,要么就全默认得了。要减少压缩频率增加点上下文长度,正常不是372+353吗。
- alizoed2026-08-21
- 紫剑2026-08-21
一直以来都是这样,所以基本不看有多少上下文,提早压缩。ds我感觉100就得压缩
- 时牧2026-08-21
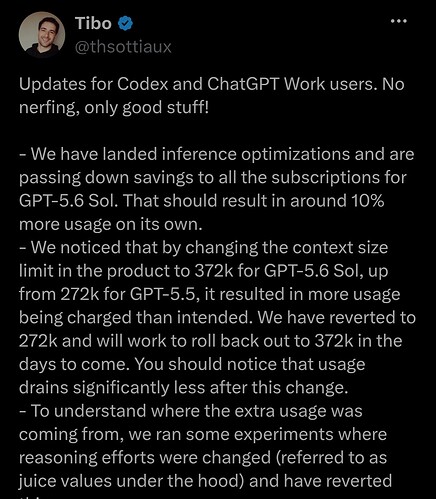
Tibo 7月13日的发帖原文
7月18日 PR #33972 正式把 bundled metadata 锁死在 272000
之后直到现在(2026-08),默认仍是 272k raw / 258.4k effective
- 陈小爬2026-08-21
cc里我设置的272k压缩,但是有33k的缓冲,在239就自动压缩
- nianshou2026-08-21
但是压缩后也会损失质量。你得对比一下1m和压缩究竟哪个损耗最大